OpenAI Alignment Blog5050
OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估
OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估。g-mean² 通过行为标签和监控预测计算 TPR 和 TNR,但无法解决不同模型任务混合差异和部署风险问题。新指标包括对齐共享实例的配对匹配指标、模拟监控拒绝输出的后控制集成指标,以更全面评估模型部署风险。
OpenAI Alignment Blog5050OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估。g-mean² 通过行为标签和监控预测计算 TPR 和 TNR,但无法解决不同模型任务混合差异和部署风险问题。新指标包括对齐共享实例的配对匹配指标、模拟监控拒绝输出的后控制集成指标,以更全面评估模型部署风险。
 Meta Engineering
Meta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
 IBM Research Blog2222
Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
 腾讯混元 · Hugging Face 新模型
Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
 OpenAI News
Itaú 通过 ia.i 对话界面和 IARA 管治平台,将其 AI 首先战略应用于客户和员工,这是巴西监管最严格的行业之一。
OpenAI News3535Anant Kumar 使用 Codex 进行代码审查并加快后续跟进。
OpenAI NewsLocaliza 使用 ChatGPT Enterprise、OpenAI API、Codex 和 60 多个专业智能体重组工作流程,构建 AI 原生移动体验。
 Ollama Blog
Reflection 的首个开源权重模型 Beam 已于今晨全面推出,Ollama 作为首发合作伙伴限时免费提供该模型,其 Beam 端点支持完全零数据保留(ZDR)。
OpenAI NewsGrupo Boticário 运营着自主解决高达 80% 经销商运营请求的专有智能体平台,使销售团队能转为顾问角色。
OpenAI News4545Stack Overflow for Agents 通过 ChatGPT 插件实现智能体创建量增长 10 倍,由工程师使用 Codex 在数周内开发完成。
Meta EngineeringMeta 使用 AI 智能体参与工程流程构建 Forum 应用,将 AI 视为工程过程的参与者而非辅助工具。该实验以生产就绪成果而非代码量衡量成功,通过 Human-On-The-Loop 模式让 AI 自主执行计划、实施、测试和验证,工程师负责设定目标、监督和验收。
OpenAI News3838GPT-Rosalind 学术计划推出,为符合条件的学术实验室提供赞助访问权限及工具,以推动生命科学研究。
 Microsoft AI News
微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。
 Microsoft Research
Magnetar 证明 Rust、Go 或 C 编写的程序,平均比最快可比系统快 10 到 39 倍,并仅依赖标准哈希函数实现安全,解决了零知识证明的三大挑战:效率、通用性和可用性。它通过利用重复性计算和早期终止证明过程,大幅降低了证明开销,使生成证明变得像运行程序一样常规,可用于 AI 智能体行为验证、金融交易校验等场景。
 NVIDIA Blog
NVIDIA 发布 120B 参数的 Nemotron 3.5 Super VL 开源模型,在多模态智能体任务中实现最快任务完成速度和最高准确率;同时推出 Nemotron 3.5 Bolt 74B-A9B 24GB 和 Nemotron 3.5 Bolt E4B 4GB 边缘模型。
OpenAI News1717OpenAI为巴西教师推出葡萄牙语版教育者工具,新增Study Mode功能支持教师引导主动、分步式学习。该工具通过提问帮助学生思考与学习。
 OpenAI Agents SDK releases2727
OpenAI Agents SDK v0.24.0 发布,新增 MCP 注释对转换工具的暴露支持及运行范围工具异常格式化功能。修复了批量 OpenAI 对话会话写入 API 限制问题,并优化了待处理批准的自动压缩延迟。版本包含 15,444 行新增代码和 1,412 行删除代码,主要改进工具执行与故障恢复、持久化 RunState 与会话历史、沙箱安全、追踪、示例、依赖项及发布元数据。
 OpenAI Deployment Safety
GPT-Live-1.1 和 GPT-Live-1.1 Quip 使用包括公开互联网信息、第三方合作数据及用户生成内容在内的多样化数据集进行训练,采用高级数据过滤流程减少个人信息并使用安全分类器防止有害内容。其性能指标对比值为已发布模型的最新版本数据。
 Apple Machine Learning Research3434
在 ToolBench 上,Retrieve-then-Plan (RtP) 在单工具查询中优于 Plan-then-Retrieve (PtR),而 PtR 在多工具查询中表现更佳,这一交叉点在所有检索预算(k=1至20)、注册表规模(1k至47k API)和模型族(Gemini 2.5 Flash 和 gpt-oss-120b)中均成立。
 Google Developers Blog
评估 AI 智能体不能仅凭感觉检查,因为智能体可能陷入重试循环或产生幻觉回答却仍看似正常,导致云费用和 token 使用量激增。应建立可重复的评估流程,从定义关键用户旅程(CUJ)开始,使用模拟用户测试,并采用单元测试、确定性指标、LLM 作为裁判的评分标准和集成测试等多层检查。结合手动审查的跟踪记录与自动化验证,可在开发早期检测到隐性回归,并随着智能体能力增长扩展评估框架。
OpenAI News2222Sullivan & Cromwell 与 OpenAI 合作开发了 Agreement Analyzer 工具,用于识别草拟协议中的问题。
Apple Machine Learning Research在四台 Mac Studio 集群上,Muse Spark Open(816B 参数)生成速度超过 36 tokens/秒。Mac Studio M5 Ultra 版本比 M3 Ultra 在推理速度上提升 4.6 倍(TTFT)和 1.6 倍(tokens/秒),得益于 GPU 神经加速器和 1.2 TB/s 内存带宽。
OpenAI News2828SentinelOne 通过 OpenAI Daybreak 将恶意软件分析时间从数周缩短至数小时,使其能够调查更多威胁。
OpenAI NewsAmp 推动智能体能力边界,使用 GPT-6 Astra、Ultrafast、GPT-Live-1 和 Sign in with ChatGPT。
OpenAI News4040Block 的安全团队借助 OpenAI 技术将威胁调查速度提升至分钟级别并快速提出补丁。
OpenAI News4545Third Moment Research 运行 10,000 个智能体 36+ 小时,其 AI 实验室使用 GPT-6 Astra 和 GPT-6.1 Sol、Codex 及 Daybreak 模型构建专注于长期任务并随使用改进的智能体。
Apple Machine Learning Research2727Whisper-small 在 CS-FLEURS 基准测试中实现 14 种语言对的平均 F1 分数 0.798,优于 CNN 的 0.776 和 HuBERT 线性基线的 0.751。该方法通过识别预训练语音编码器中的语言选择性隐藏状态维度,直接从语音中检测语言转换,仅需少量代码转换数据集即可微调决策规则。
OpenAI News2222欧盟企业和小型企业的智能体 AI 采用正在增长,更深入的使用可能释放更多价值。
 LangChain Blog
Orange Business 为 120,000 名员工和 150 多家客户部署了旗舰 AI 平台 Live Intelligence。
IBM Research Blog3838IBM 宣布将在 2027 年第一季度推出 7 纳米纳米堆叠技术早期研究开发工艺设计套件(PDK),帮助半导体公司在大规模采用前评估该技术。该套件将提供逻辑功能标准单元库和 SRAM 设计示例,支持布局布线、早期模块级布局和密度与功耗性能特性评估。纳米堆叠技术通过将晶体管堆叠而非并排排列,首次在逻辑晶圆技术层面实现晶体管级别的 3D 布局,与当前纳米片晶体管架构有显著差异。
OpenAI News5555Higgsfield 推出 GPT-6 Astra、GPT-Image-2.5 和 GPT-Live,支持创作者制作更长的视频、实现精确的视觉效果,并提供语音电影制作的路径。
IBM Research Blog5858IBM Research 使用开源智能体工厂优化量子纠错硬件,高级综合评估实现 52 倍加速,成本约 26 美元;同等预算下闭源前沿模型配置成本 299 美元(11.5 倍更高)但加速 204 倍,开源配置以更小面积实现硬件优化;该智能体工厂通过协调器分配任务给并行工作智能体,结合代码修改与硬件效果评估,探索多种架构可能性。
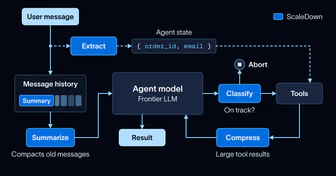
LangChain BlogScaleDown 通过压缩和提取技术优化长时运行智能体的上下文管理,其模型在基准测试中比 GPT-5.5 等通用模型便宜 41 倍且快 2.7 倍。ScaleDown 提供四种模型:Summarize、Compress、Extract 和 Classify,分别用于摘要、压缩、提取和分类,支持最多 1M tokens 的输入,并支持图像和 PDF 输入。
Google Developers BlogGemini 4 Argon 在 11 小时内无人工干预运行中,通过分析 205,000 行代码的 ADK Python 仓库,提出了 6 项优化建议,最终 2 项被采纳并上线,将内存会话准备时间缩短约 40%,冷包导入速度提升 21%。该模型在优化过程中遵循了仓库的维护者指南,并运行了全部 16,892 个单元测试。
Ollama Blog5858Ollama Cloud 现支持在 Fly.io Sprites 全 Linux 虚拟机中运行 AI 智能体,其中 Sprite 是 Fly.io 提供的隔离式 Linux 虚拟机。
 GitHub Blog · AI & ML
GitHub Copilot 可通过自定义指令、代理技能、自定义代理和模型上下文协议(MCP)服务器等方式,让用户向 Copilot 传达项目规则、封装可重复流程、提供专业指导以及连接外部工具,从而提升协作效率。自定义指令定义代码规范,代理技能封装重复性任务,自定义代理处理复杂工作,MCP 服务器扩展 Copilot 功能。
Microsoft Research微软研究院开源多模态模型StudentSim用于模拟学生学习行为,通过公开脱敏学习记录训练个性化学生模拟器,在棋类、英语写作和数学领域表现优于基准,为AI辅导系统提供早期反馈信号,不用于替代教师或课堂教学。
 Microsoft Official Blog
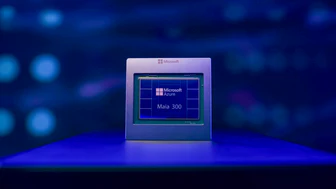
微软将 Azure Maia 系统扩展至多吉瓦部署,Maia 200 已投入生产,Maia 300 将于 2027 年推出。Maia 200 正服务于微软生产工作负载,包括微软 Copilot,并支持 MAI 团队开发下一代模型,GitHub Copilot 和微软 Foundry 将于今年年底推出。
OpenAI News5757Sophos 通过使用 OpenAI Daybreak 将网络安全威胁调查时间缩短 96%,并自动化了 52% 的 MDR 案例,同时保留了人工监督。
OpenAI News2222Asana 在 Codex 中使用 GPT-6 Astra 使其浏览器智能体成本降低 76 倍、速度提升 5 倍。