Hugging Face Blog4040
基于 NVIDIA Nemotron 开源模型的万圣节互动投影项目 MonsterHouse
MonsterHouse 是一个用 NVIDIA Nemotron Voice Agent、NVIDIA Nemotron ASR、NVIDIA Nemotron 3.5 Bolt E4B 4GB、Magpie TTS Zeroshot 和 Audio2Face-3D 构建的互动投影,能通过语音与访客交流并模仿脾气暴躁的老海盗声音。
Hugging Face Blog4040MonsterHouse 是一个用 NVIDIA Nemotron Voice Agent、NVIDIA Nemotron ASR、NVIDIA Nemotron 3.5 Bolt E4B 4GB、Magpie TTS Zeroshot 和 Audio2Face-3D 构建的互动投影,能通过语音与访客交流并模仿脾气暴躁的老海盗声音。
 AWS Machine Learning Blog3838
Worldwide Express 通过 Amazon Bedrock 和多智能体 AI 解决了每月 1500 万美元因货运异常导致的资金冻结问题,其系统包含三个专门处理不同类型账单纠纷的智能体,并在 6 个月内将活跃异常减少 75%,加快了 4 周的回款时间并每年节省 100 万美元。
 NVIDIA Blog5858
Breakthrough Listen 和 SETI 机构将具身 AI 智能体引入外星智慧搜寻,在加州艾伦望远镜阵列实现从自然语言请求控制仪器、增强校正数据及应用 AI 模型处理数据流。NVIDIA Holoscan 平台处理传感器数据,NVIDIA RTX PRO 6000 Blackwell GPU 实现每秒 2.4TB 数据处理,完成实时脉冲星 AI 检测。
 Google DeepMind5858
PlanAssist 工具可将规划官员评估住宅申请时间缩短 58%,已在英国巴尼特、卡姆登和多塞特等地试点,现向 12 个更多地方规划当局推广。该工具由 Google DeepMind 与英国政府、Google Cloud 和 Faculty 合作开发,基于 Gemini 架构,通过自动验证文件、检查政策约束和草拟报告来加速流程,同时保留官员最终决定权。
 Databricks Blog4747
Databricks 宣布 Spark Declarative Pipelines Real-Time Mode 正式可用,该模式通过持续流式处理、并行查询阶段和即时数据传递实现毫秒级端到端延迟。
 LangChain Blog精选6767
LangChain 为 Managed Deep Agents 加入浏览器能力,开发者通过 define_browser 导出浏览器配置,即可让托管智能体读取页面渲染结果并点击操作。
推荐理由: 原文给出浏览器工具的接入方式、handoff 机制与 WebVoyager 实测数据,可据此判断托管智能体如何覆盖无 API 的网页任务。
LangChain Blog精选6767LangChain 发布 Managed Deep Agents v0.10,新增浏览器使用能力,让智能体操作没有 API 的网站,并支持异步子智能体在后台运行长任务。
推荐理由: 原文给出浏览器接管与异步子智能体两项能力的具体配置方式和交接流程,可据此判断智能体处理无 API 网站与长任务时的分工。
AWS Machine Learning Blog3434Epsilon 通过 Amazon Nova Act 和 Amazon Bedrock AgentCore Browser Tool 构建了意图驱动型 UI 测试平台,实现自然语言测试用例(如“确认奖励余额可见”)与现有 Playwright 回归测试套件的结合。
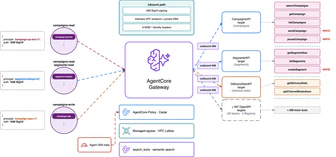
AWS Machine Learning Blog4242MoEngage 通过 Amazon Bedrock AgentCore Gateway 将 400 个内部 API 转换为受权限控制的智能体工具,解决多团队 API 集成难题。该方案无需搭建 MCP 服务器或配置网络,将新 API 上线时间从数天缩短至数小时,同时满足 API 保留在 VPC 内部、身份由服务端控制、工具定义不占用推理上下文窗口的约束。
 Meta Engineering精选6666
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
推荐理由: Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
Hugging Face BlogProject ProtoStar 项目发布,旨在通过使数据集、模型和代码更易获取和复用,解锁公共资助科学研究的潜力。该项目汇集了大学、研究机构、产业和开放科学社区,支持以 AI 兼容、机器可操作的格式发布科学成果,并通过一系列公开挑战展示其价值。首个挑战由卡内基梅隆大学主办,将于 11 月 2 日启动。
 vLLM Blog精选同一件事 · 2 家7878
vLLM 宣布在发布当天支持 Mistral Large 4,这是一个 1 万亿参数、每 token 激活 49B 的 MoE 原生多模态模型,采用 MLA 加 DSA 稀疏索引器,并内置 DSpark 投机解码草稿模型。
Hugging Face Blog精选同一件事 · 2 家8585Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Hugging Face BlogHugging Face 发布 Granite Switch 4.1.1,在 4.1 基础上增量更新,保留完全向后兼容性。新增多语言语音转写模型(支持 10 种语言带原生标点)和 Jev 决策指数测试集性能提升的决策适配器。团队通过仅更新适配器未重新计算基础模型,实现快速部署,未来将支持第三方自定义适配器。
 Mistral AI精选8282
Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。
Databricks BlogProcore 通过 OpenSharing 将连接后的建筑数据以程序化方式共享至客户现有环境,支持 Power BI、Tableau、Snowflake、BigQuery、Databricks 工作空间或本地 SQL Server,用于报告和下游分析。
 Google Developers Blog
LiteRT 在 Google Play services 中迎来重大升级,其 GPU 推理速度比传统 GPU 代理器快约 1.4 倍,通过新推出的 CompiledModel API 实现,该 API 由开源 GPU 引擎 ML Drift 驱动
Databricks BlogDatabricks 发布语音智能体,通过实时上下文决策在对话中调整响应,实现语言切换、转接人工或提供个性化服务。该智能体需 200 毫秒内处理客户请求,依赖 Databricks 提供的上下文、本体和治理能力,整合客户、订单、产品和政策数据,并遵循企业数据目录的访问规则。
AWS Machine Learning BlogQA Studio 的应用功能组织测试并报告健康指标,团队级用户管理控制访问权限,通过健康评分和趋势图表监控测试覆盖率,五种角色(管理员、团队负责人、编辑、执行者、查看者)实现应用级别的权限管理。
Google Developers Blog5858Agents CLI v1.8.0 通过 eval generate、eval grade 等命令实现 Hill-Climbing 优化 Agent 质量,使用 custom_response_quality 指标对 4 个案例进行 1-5 分评分,发现修改系统提示词为厨师角色导致平均分从 4.0 降至 2.75。该工具支持模型后端实验和自动告警,通过循环迭代提升 Agent 性能。
LangChain BlogLangChain 发现近 70% 的 Managed Deep Agent 运行来自定时任务。Crons 通过实现记忆("dreaming")、主动性(探索新动作)、智能筛选(事件流监控)和提醒(定时任务)等机制,使 agents 具备 proactivity、personalization 和 ambient 特性。
 Together AI Blog3838
Together AI 推出 GPU 集群自动修复功能,通过在虚拟机和宿主机两端持续监控节点健康,在检测到故障时推荐最小化修复动作并提供证据,允许用户选择自动执行或手动批准。该功能目前全面可用,支持被动健康检查、修复建议、自动修复策略(含故障和节点级授权)、空闲等待控制、升级阶梯和安全护栏,并通过 API 和控制台进行修复;预览版提供基于节点标签的修复合约支持第三方检测系统。
Databricks BlogDatabricks Lakehouse Federation允许用户通过标准SQL直接查询外部数据库(如SQL Server、PostgreSQL等)中的数据,无需迁移。
Databricks Blog4545Databricks Vital Skills 通过开源 Agent Skills 标准为 Genie Code 增强医疗健康与生命科学领域知识,使其在 BiomniBench 基准测试中得分提升。
Google Developers Blog3434Google 发布对话式商务工作原型 HappyDelivery,基于 LangGraph 和 Gemini 在 GCP 上实现;Ingress 层通过 GKE/Cloud Run 和 Cloud Pub/Sub 处理来自 WhatsApp 的输入
AWS Machine Learning Blog3434Property Finder 在迁移视觉 AI 工作负载至 Amazon Bedrock 时发现其评估数据集 96.8% 的标签来自单一模型的预测而非人工验证,导致新模型客观比较受阻。该公司通过人工专家独立标注 356 张图像构建可信基准数据集,并采用进化式提示优化迭代 27 次后,在保持 86% 准确率的同时将成本降低 86%。
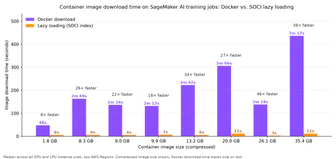
AWS Machine Learning Blog3434AWS SageMaker AI 推出 SOCI-indexed images 功能,将容器镜像下载从关键路径移除,使 SageMaker AI 训练和处理任务启动时间从分钟缩短至秒级。该功能通过预索引 AWS Deep Learning Container (DLC) 或为自有镜像添加索引实现,无需修改工作负载定义,基准测试显示可将 GPU 空闲时间减少 90%,提升效率 8-46 倍。
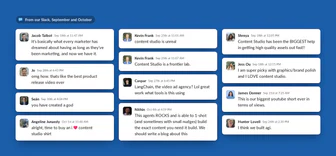
LangChain Blog精选7171LangChain 介绍了其内部设计智能体 Content Studio 的搭建过程,该智能体在 Slack 中接收一句提示词即可产出视频、社交图、UI 图和幻灯片,所有素材均以代码生成。
推荐理由: LangChain 公开了设计智能体 Content Studio 的完整搭建过程,包括技能、wiki、检查门与异步子智能体的分工方式,可作为构建垂直 Agent 的参考。
 NVIDIA Newsroom5858
NVIDIA Vera Rubin NVL72 和 NVIDIA Vera CPU 现已在 Oracle Cloud Infrastructure (OCI) 上正式提供,计划引入 HGX Rubin NVL8 系统以帮助组织加速前沿模型训练、提高推理效率并扩展智能体工作负载。
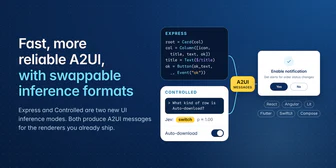
Google Developers Blog精选6666Google 为生成式 UI 协议 A2UI 推出可替换推理格式,并新增默认格式 A2UI Express,官方称相比 Direct JSON 延迟最多降低 3 倍、生成同等 UI 所需 token 最多减少 3 倍。
推荐理由: 官方给出可替换推理格式的接入方式与延迟、token 对比,便于判断生成式 UI 的工程取舍。
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
Databricks BlogLakeflow Connect 通过原生连接器支持维基、项目管理工具和 AI 基础模型,使下游 AI 智能体获得完整业务上下文。该平台提供全面管理的原生连接器,支持 SaaS 应用、数据库和文件源,数据直接导入 Databricks 平台,通过点选式 UI 或 API 配置,增量导入 Unity Catalog 表格。
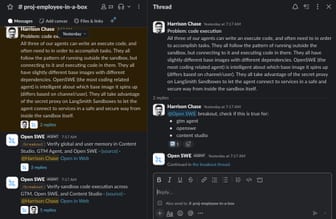
LangChain Blog5858LangChain 内部智能体通过 Slack 集成,以用户身份或固定凭证执行任务,具备全局与用户级记忆,在沙盒中执行代码,并支持后台调度运行。其架构包含 GTM、OpenSWE 和 Content Studio 三种智能体,分别处理 GTM 活动、工程代码审查和营销内容创作,通过“ breakout”功能优化用户体验,并解决身份认证等核心问题。
Databricks BlogDatabricks AI Search 现在原生支持使用 Iceberg v3+ 的 Streaming Tables、Materialized Views 和 Managed tables,除 Delta 表外。
 PyTorch Blog3434
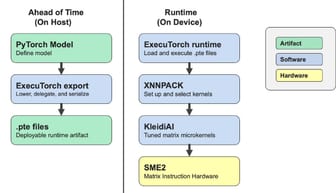
Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
AWS Machine Learning Blog3838Amazon SageMaker SDK v3发布,通过双分支SageMaker Pipeline为每台相机训练异常检测器和缺陷分类器,并设置质量门禁阻止性能不佳的模型。
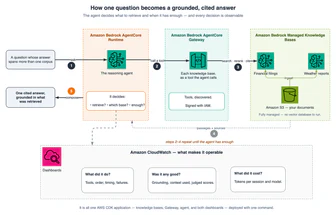
AWS Machine Learning Blog4848使用 AWS CDK 在 Amazon Bedrock 管理知识库上构建企业级智能检索,通过 AgentCore 提供的推理代理和 AgenticRetrieveStream API 实现多轮规划和工具驱动检索,返回带引用的答案。该方案部署包含 Amazon S3 语料库、知识库和推理代理的 CDK 应用,支持语义路由和多次检索,并内置 Amazon CloudWatch 监控和评估功能。
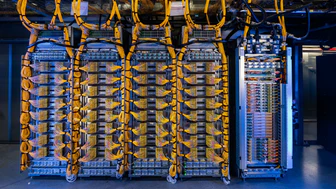
Meta Engineering5858Meta 在 2026 OCP 全球峰会上分享了支持其最新 AI 模型 Muse Wonder 和 Muse Spark 及 Prometheus 集群的网络创新。
 OpenAI News4545
Fanatics 通过 OpenAI 的 Shop the Look 功能让球迷完成赛时装备搭配,测试约 30,000 件 MLB 产品显示参与度提升 10%。
 IBM Research Blog5858
IBM 和 PyTorch 基金会宣布 Spyre 加速器将成为 PyTorch 的第一类后端并支持多加速器调度。torch-spyre 编译器、Spyre vLLM 插件及持续集成工作使模型和流程能运行在 Spyre 上,该架构针对推理优化,适合 IBM Z、LinuxONE 和 Power 系统。