Hugging Face Blog
Hugging Face 提供 TRELLIS.2 微调脚本和容器。
Hugging Face 发布用于微调 3D 生成模型 TRELLIS.2 的脚本和容器,支持本地或 Hugging Face Jobs 部署,通过 LoRA 技术仅微调结构预测和几何生成阶段,以提升特定任务(如鞋类)的精度。
Hugging Face BlogHugging Face 发布用于微调 3D 生成模型 TRELLIS.2 的脚本和容器,支持本地或 Hugging Face Jobs 部署,通过 LoRA 技术仅微调结构预测和几何生成阶段,以提升特定任务(如鞋类)的精度。
 NVIDIA Blog5555
GeForce NOW 将引入《战锤40,000:战争之黎明IV》,支持云游戏体验克洛努斯之战;DLSS 5 技术将登陆《战争 thunder》和《Where Winds Meet》,性能较前版提升十倍;本周新增 10 款游戏入库,包括《龙之信条2:暗裔觉醒》等。
 PyTorch Blog
EUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
 OpenAI News
OpenAI 捐赠 200 万美元支持 AI 与儿童安全研究,用于开发共享工具以衡量对年轻人的风险与机遇。
OpenAI News3535Holiday Extras 通过 Codex 将客户专长转化为更优应用、提升预订转化率并探索新的增长可能。
 vLLM Blog精选6060
vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。
推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。
 LangChain Blog
LangChain 内部 GTM Agent 在 12 周内为销售代表生成 1540 份售前物料,使销售效率提升 47%(发送物料交易进入下一阶段的概率从 16% 提升至 47%),平均每份物料节省 3.37 小时人力成本。
 AWS Machine Learning Blog
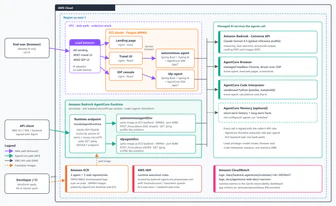
Java 团队可以利用 Amazon Bedrock 和 Spring AI 构建自主 AI 智能体,解决可扩展性、治理、安全和运维问题。Spring AI 通过 Spring 模式(自动配置、依赖注入、可组合顾问)为 JVM 带来 AI 能力,而 Amazon Bedrock AgentCore 平台支持框架和模型无关的智能体构建、连接和优化。
 Claude · YouTube3535
旅野森玛丽ko 用 Claude 编写代码创作了计算机生成动画,并以此呈现为新的视频装置作品《所有闪耀的光芒》,该作品于 2026 年 10 月 31 日至 2027 年 3 月 28 日在 Mori Art Museum 的回顾展 Mariko Mori: All That Shines 中展出。
 Codex releases00
GitHub Copilot 发布 0.170.0-alpha.2 版本,提供代码审查、漏洞检测和密钥保护等功能。
AWS Machine Learning BlogAmazon Bedrock AgentCore 今日推出 Web Search API,允许开发者通过单次 API 调用搜索 Amazon 运营的网页索引,返回结果包含文本摘要、页面标题、URL 和发布时间。
AWS Machine Learning Blog5858Amazon SageMaker HyperPod 通过在 PyTorch DDP 训练循环中添加三项检查来检测无声数据损坏(SDC),包括非有限梯度检查、环形重放审计和权重指纹比较,当检测到问题时将可疑节点隔离并由 HyperPod 替换,已在 4 ml.p5.48xlarge 实例集群上测试验证。
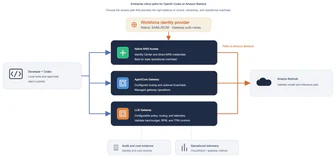
AWS Machine Learning Blog开发者通过 Amazon Bedrock 使用 OpenAI Codex 进行代码探索和工程工作。Amazon Bedrock 支持 Codex 推理,并可与 AWS 身份、IAM 和可观察性实践集成。推荐从 Native AWS Access 开始小规模试点,使用 GPT-5.6 Sol 进行验证,通过 IAM Identity Center 进行身份认证,并配置模型权限和观测目标。
 Databricks Blog
Databricks 解决方案架构师 Alasdair Anderson 分享其工作日常,涵盖技术构建与团队辅导;他强调平台如 Lakebase 和 Agentbricks 如何助力金融业客户实现秒级数据处理与业务流程重塑;公司文化中的“客户至上”与“求真务实”通过分析行业报告、实时风险建模等实践体现,同时内部协作的开放透明也促进全球团队高效解决复杂挑战。
Databricks BlogDatabricks 通过分析审计日志和 Genie 检测凭证驱动攻击,发现被盗凭证在几分钟内从新 IP 列出秘密范围、目录和存储库,随后读取包含服务主体凭证的秘密,再由服务主体创建函数并加入管理员组,这些非线性事件序列揭示入侵行为。
AWS Machine Learning Blog3838Claude Haiku 5.5 发布,成本比 4.5 版本低 75% 并支持成本控制;GPT-6.1 Terra 在 OpenAI 评测中表现与 GPT-6 Astra 相当且速度更快三倍。
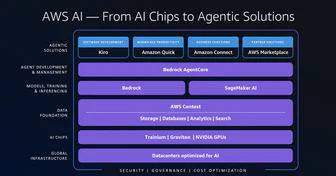
AWS Machine Learning Blog1212AWS re:Invent 2026 AI/ML 主题研讨会将于 11 月 30 日至 12 月 4 日举行,提供 140 余场专题学习会,涵盖 AI 芯片、模型训练与推理、智能体开发管理等全栈内容。
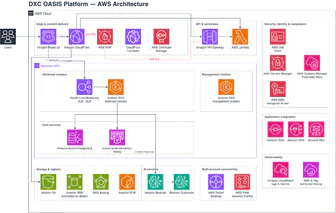
AWS Machine Learning Blog3838DXC Technology 在 Amazon Bedrock 上构建的多模型 AI 基础设施通过统一 API 访问 Anthropic Claude、Amazon Nova、Meta Llama 和开源模型族,并使用 Amazon Bedrock Guardrails 实施内容过滤和 PII 匿名化。
AWS Machine Learning BlogAWS CloudTrail 捕获 Amazon Bedrock AgentCore 中 AWS Agent Registry 的 UpdateAgentRuntime API 调用事件,Amazon EventBridge 将匹配事件路由至 AWS Lambda 函数,Lambda 函数查询 MCP 服务器当前工具并更新匹配的 Registry 记录。
Codex releases00GitHub Copilot 0.167.2 发布,提供代码审查、漏洞检测和密钥扫描功能,支持自定义集成。
 Google Research5858
Google Research 发布可穿戴设备驱动的 CKM 风险评估框架,通过可解释健康年龄模型(CHA)预测未来健康轨迹。该框架基于 2.2 百万人周穿戴数据训练的 SensorWM 模型,提供个性化 12 周反事实健康模拟,结合语言模型生成临床验证的指导方案。CHA 模型整合心率、步数、睡眠等可改变指标,预测 68,000 人年疾病风险,改善临床指标预测效果。
AWS Machine Learning Blog3838AWS Generative AI Innovation Center 提供 23 件生产级可复用资产,包含 RAG 管道、文档处理器等,可缩短开发时间至数周,DoorDash、Lyft 和 Ricoh 等公司使用后实现测试能力提升 50 倍、工程时耗减少 90%、部署周期从数月压缩至数周。这些资产已通过安全审查并支持持续维护,解决了因缺乏单一事实源、质量信号和复用文化导致的重复开发问题。
OpenAI NewsJioStar首席架构师Vijay Seshadri解读5亿用户规模下的AI发现实践,强调评估指标、安全边界和AI生产化部署的关键经验。
 Apple Machine Learning Research
Weighted State Souping 提出查询依赖权重来组合缓存的 State 状态编码,在单跳和多跳文档问答、寻针式检索、变量跟踪及工具使用等任务上显著提升长上下文性能。该方法可适配为高效稀疏变体,实现近常数编码成本,同时保持(有时提升)性能。
Apple Machine Learning Research状态空间模型(SSMs)在情境学习和精确检索任务上落后于 Transformer,其门控机制导致其先学习记忆解决方案,延迟或阻止正确情境学习解决方案的收敛,但门控机制对改善长序列泛化有益。
Apple Machine Learning Research研究人员评估了大型语言模型(LLM)判官在个性化写作任务中的表现,发现判官质量与 MMLU 测量的通用 LLM 能力相关性较弱(Pearson’s ρ ≤ 0.2),且表现受写作任务和评估标准(如通用帮助性 vs 风格个性化)影响。LLM 评估器在成对比较中比独立评分响应时更一致且表现更佳,而“最强”LLM 并未最可靠地复现人类评估,可能因对人类标注者和较弱 LLM 忽略的细微细节过度敏感。
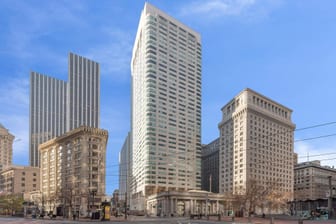
Databricks BlogDatabricks 开放 235,000 平方英尺旧金山新总部,投资超 10 亿美元用于 AI 研究,支持 KARL、MemCurrent 等模型及 Genie 代理,并承诺至 2030 年举办 Data + AI Summit。
 Google AI Blog精选7878
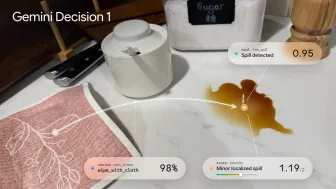
Google 发布 Gemini Decisions API,由新模型 Gemini Decision 1(gemini-decision-1)驱动,可在 Gemini API 和 Google AI Studio 中使用。
推荐理由: 原文给出了单次前向打分、延迟与定价数据,读者可据此判断它适合哪些低延迟决策场景。
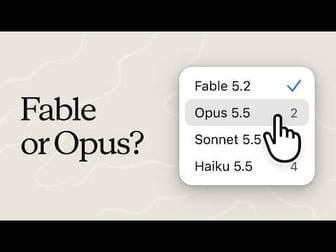
Claude · YouTube同一件事 · 3 家4242Claude Code 发布 Fable 5.2,用户需根据任务类型选择 Opus 5.5、Fable 5.2、Sonnet 5.5 或 Haiku 5.5,或跨模型分配任务;各模型可用性及使用限制因订阅计划而异。指南建议在复杂编码与知识工作、开放性技术任务、低成本限定工作等场景下分别选用对应模型。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Amazon Science
亚马逊网络服务使用其自动化推理工具Tiros验证网络隔离,通过将网络配置转换为逻辑命题并分析模型中的可能路径,检查隔离是否符合声明策略,替代了传统的动态采样方法。
 Meta Engineering4040
Meta 的 Intelligent Delivery 系统通过 AI 优化计算资源分配,自 2017 年以来为广告排序性能额外提升约 10%。该系统包含预测计算边际效用的 Resource Core Model(6B 稀疏参数+20M 密集参数)、跨系统资源迁移的多层机制,以及利用智能体 AI 持续检测响应系统变化的框架。
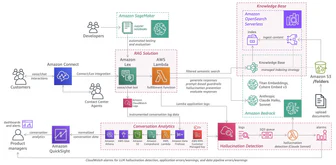
AWS Machine Learning Blog精选6060AWS 发布开源框架 UAEF,用适配器将 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore 和 Langfuse 的执行轨迹统一为 AgentTrace,再用 7 个维度 36 项内置指标打分。
推荐理由: 原文给出跨框架统一评测的适配器与指标设计,读者可据此判断多框架智能体版本对比的落地方式。
AWS Machine Learning BlogAWS Quick 的 AI-驱动的产品开发生命周期(AI-PDLC)通过六种专用技能代理,结合人类审批,将企业信号转化为验证原型。Discovery 代理分析企业数据源中的痛点,Prioritize 代理使用 0-10 分数框架评估用例优先级,所有决策均需人工确认。
Databricks Blog3838Bright Machines 通过在工厂边缘使用 Debezium 捕获 PostgreSQL 变更,将其写入 Apache Iceberg,再通过单一可审计的出站路径发送,最终在 Databricks 中通过 Unity Catalog 联邦读取,为客户提供了无需开放工厂网络访问的实时、受治理的工厂数据仪表盘。
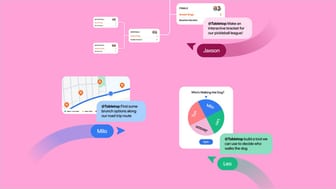
Google AI BlogGoogle AI 推出 Tabletop,一个用于实时协作的新实验性平台,支持团队生成定制化行程、投票、费用分摊和赛程表。用户可通过 @tabletop 提示或模板创建互动空间,分享链接供多人同步使用,类似 Google 文档。目前在美国 18 岁以上用户通过候补名单推出。
Codex releases55GitHub Copilot发布0.170.0-alpha.1版本,提供代码生成、审查、安全和协作功能,集成GitHub平台支持。
 Google Developers Blog精选7878
Google 发布生成式 UI 开放协议 A2UI 1.0,这是该协议的首个稳定版本,让 AI 智能体以交互界面而非纯文本作答。1.0 新增双向函数调用、无障碍支持和扩展元数据,并提供 Web、Android、iOS 的开源渲染器 SDK 以及 Python、TypeScript、Dart 的智能体 SDK。
推荐理由: A2UI 1.0 将智能体输出从纯文本扩展为原生交互界面,并提供多平台渲染器与接入方案示例,据此可判断生成式 UI 的落地方式。
AWS Machine Learning Blog亚马逊 SageMaker AI 双向流推出按使用量计费模式,使模型提供商能通过 AWS Marketplace 报告实时流式推理的实际使用量。Deepgram 成为首发合作伙伴,为 AWS Marketplace 带来语音转文本和文本转语音的按使用量计费。
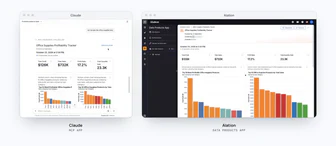
Databricks Blog精选7676Databricks 宣布 Genie One 成为企业 AI 协作的统一入口,将搜索、产物生成和跨工具操作集中到一处,并基于 Genie Ontology 提供企业上下文,由 Unity Gateway 统一治理。
推荐理由: 原文给出 Genie One 从问答扩展到产物生成、跨工具执行与治理的具体能力,可据此判断企业 AI 工作台如何落地。
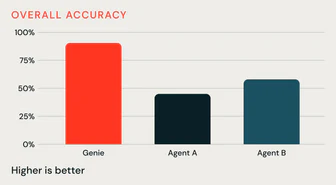
Databricks Blog5858Genie 在包含表格、笔记本、仪表板等企业级知识资产的基准测试中,正确率达 91%,远超 Agent A(45%)和 Agent B(58%),同时 token 使用量减半,速度提升 3-4 倍。Genie Ontology 通过自动提取和组织企业知识,为 Genie 提供共享的业务理解,显著提升准确性和效率。