Meta AI Blog
Meta AI 发布 Muse Image 和 Muse Video:首批媒体生成模型
Meta AI 发布了其最先进的图像生成模型 Muse Image,该模型能忠实遵循指令、精确编辑、从多参考中构图,并具备智能体工具使用能力,已集成 Muse Spark;Muse Video 同样基于相同预训练基础,提供卓越视觉保真度并支持原生音频。
Meta AI BlogMeta AI 发布了其最先进的图像生成模型 Muse Image,该模型能忠实遵循指令、精确编辑、从多参考中构图,并具备智能体工具使用能力,已集成 Muse Spark;Muse Video 同样基于相同预训练基础,提供卓越视觉保真度并支持原生音频。
 ByteDance Seed · Hugging Face 新模型2727
字节跳动种子发布3款PAR模型:3scale_400M、3scale_400M_pdb和3scale_by_ratio_60M,分别用于基准测试、PDB数据集微调和零样本动机构建。
 Berkeley AI Research4040
加州大学伯克利分校人工智能研究实验室(BAIR)庆祝 2026 届博士毕业生,他们的研究涵盖机器人与具身智能、大语言模型与推理、计算机视觉、生成式建模、AI 安全、人机交互、AI 在科学与医疗领域的应用等。毕业生们已发表重要研究成果,构建具有实际影响力的系统,并将在学术界、工业研究机构和初创公司等领域继续探索 AI 的前沿。
Meta AI BlogMeta AI 发布 Brain2Qwerty v2,非侵入式脑机接口实时解码句子,词准确率达 61%;v1 训练代码及数据集开源,v1 数据集由合作方 BCBL 发布。
 Anthropic Research3838
Anthropic 更新了其经济指数报告 Cadences,通过提升数据采样率至每小时级别并引入新的对话输出分类器,更清晰地呈现了 Claude 的使用模式。报告显示,工作相关查询在周末的减少幅度在高收入职业中较小,用户在早晨询问新闻、凌晨 5 点寻求睡眠建议,申报截止日期前税务相关请求激增。
 OpenAI Alignment Blog
OpenAI 通过在真实场景中强化学习有益特质,使模型在数十个基准测试中表现出更佳的协同与有益行为,且效果泛化至训练域之外并能在对抗压力下持续。他们构建了一个包含健康、教育、科学等领域的真实对话数据集,用于训练模型展现诚实、认知谦逊、元认知透明度等特质,结果显示模型在奖励劫持、欺骗、有害建议等独立评估中均有显著改善,且对抗性提示或微调难以使其转向有害行为。
OpenAI Alignment BlogOpenAI 使用 WildChat 数据模拟部署 GPT-5.1、5.2、5.4,发现其预测真实世界失败率的平均误差约 3 倍,验证了公共部署模拟方法。尽管 WildChat 数据收集于 2023 年 4 月至 2024 年 5 月,但预测结果仍与当前生产使用情况吻合,尤其在技术性和智能体式失调方面误差较大。该研究支持使用更广泛的生产类公共数据集评估下一代语言模型的实际失败。
 LangChain Blog5050
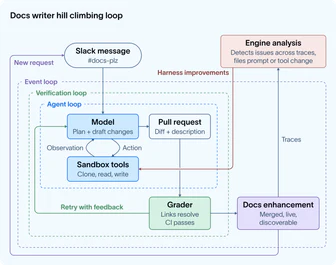
LangChain 通过四个循环层次提升智能体效能:基础循环执行任务,验证循环确保质量,事件驱动循环实现后台运行,爬升循环通过分析优化自身。LangChain 的 create_agent、Grader、LangSmith Deployment 和 Engine 等原语支持各层级构建,同时强调在关键节点加入人工审核以补充 AI 判断。
Anthropic Research精选6767Anthropic 基于 2025 年 10 月至 2026 年 4 月约 40 万条 Claude Code 会话,提出分析交互式智能体编码的框架。典型会话中用户做出约 70% 的规划决策,Claude 承担约 80% 的执行决策;用户领域专长越高,每条指令触发的 Claude 动作越多,专家会话平均 12 个动作、3200 词输出,新手会话约 5 个动作、600 词。
推荐理由: 基于约40万条Claude Code会话,量化了规划与执行的分工,以及领域专长如何影响任务成功率。
 Moonshot AI · Hugging Face 新模型
Kimi K3 是 Moonshot AI 发布的 2.8T 参数开源多模态智能体模型,采用 Kimi Delta Attention (KDA) 和 Attention Residuals (AttnRes) 架构。
Moonshot AI · Hugging Face 新模型Kimi K2.7 Code 是 Moonshot AI 基于 Kimi K2.6 构建的编码专注型智能体,在真实长时程编码任务上改进显著,相比 Kimi K2.6 思考 token 使用减少约 30%。
Anthropic ResearchAnthropic 与化学家合作改进 Claude 的化学能力,首次发布白皮书评估其在 NMR 光谱分析上的表现。Claude Opus 4.7、Opus 4.6 和 Sonnet 4.6 在 20 种合成化学化合物上预测 NMR 光谱,与 ChemDraw 和 MestReNova 对比,展示了从结构到光谱的推理能力,但现有软件仍需化学家完成反向任务。
 Microsoft AI News
Microsoft AI 在健康领域通过其价值观——善良、信任、质量、简洁、安全与安全、评估——指导产品设计、工程权衡和合作伙伴关系。其 AI 每日处理数百万健康问题,Copilot 对 50 万次对话的深入分析显示用户依赖 AI 进行症状解读、检查结果解释和实际护理导航。
Microsoft AI NewsMicrosoft MAI 在 Build 2026 大会发布七款新模型,包括 MAI-Image-2.5 及其 Flash 变体(图像编辑基准排名第二)、MAI-Transcribe-1.5(全球最佳转录模型)。
Microsoft AI News微软发布七款新 MAI 大模型,可在 Foundry 平台使用并针对自家产品优化,同时通过 OpenRouter、Fireworks 和 Baseten 向开发者开放,首次支持开发者自行微调模型权重。
 MiniMax · Hugging Face 新模型
MiniMax-M3-MXFP8 是一款拥有 1M 上下文窗口、约 428B 参数和 23B 激活参数的原生多模态模型,通过 MiniMax 稀疏注意力机制(MSA)实现 9 倍预填充和 15 倍解码速度提升。该模型在长时程智能体基准中表现领先,支持三种推理模式,可通过 Hugging Face 下载并使用 SGLang、vLLM 或 Transformers 框架进行部署。
ByteDance Seed · Hugging Face 新模型2525ByteDance Seed/TaskMem 模型发布,参数规模 31B,使用 BF16 张量类型,但未部署任何推理提供商。
Anthropic Research81% 的社会科学研究人员尝试使用 AI 聊天机器人进行研究,但只有 20% 采用了 Claude Code 等编码代理工具。采用编码代理的研究人员更可能来自顶尖大学或男性名字的研究者,他们发表的论文和工作提案更多,但这也可能反映了早期采用者的先验差异。AI 编码代理首次使核心研究任务可自动化,可能重构社会科学研究,但也可能加剧研究资源不平等。
Anthropic Research5858Anthropic 通过监督代理行为和实施访问边界来限制 Claude 在产品中的访问权限,以降低风险。他们开发了 Claude Code 自动模式以减少用户批准疲劳,并采用沙盒、虚拟机和出站控制等技术来设置硬边界。三种主要风险——用户误用、模型不良行为和外部攻击者——需要通过环境、模型和外部内容三个层面的防御措施来应对,这些措施应相互补充以限制代理的破坏范围。
ByteDance Seed · Hugging Face 新模型2828ByteDance Seed/SimArt 模型预训练权重发布,包含用于生成关节式 3D 对象结构(URDF 文件)的多模态大语言模型(MLLM)权重,以及用于编码解码 3D 零件几何形状到离散潜在空间的稀疏 VQ-VAE 模型权重。
LangChain Blog精选7373LangChain 在 LangSmith Cloud 上线 Managed Deep Agents 公测,用户把智能体写成由 agent.py、instructions.md、skills/ 等文件组成的 Python 项目,用 mda deploy 一条命令部署,由 LangSmith Agent Server 提供持久线程与流式运行。
推荐理由: 原文说明了把智能体项目按文件组织并一键部署到 LangSmith 的方式,以及托管运行时替团队承担的基础设施。
 Thinking Machines
 发布交互式 AI 模型研究预览,原生支持音频、视频、文本多模态实时交互,采用多流微步设计确保 3.5 倍速度提升,实现无缝对话管理、同步语音、时间感知等能力,突破传统回合制接口瓶颈。
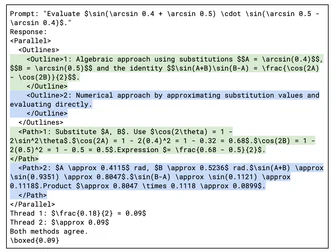
Berkeley AI Research适应并行推理让模型根据问题自行决定何时分解和并行化独立子任务、同时启动多少线程以及如何协调。现有方法如固定并行、启发式结构化搜索和蒙特卡洛树搜索等,均在模型外部决定并行结构。最新进展如 ParaThinker 和 GroupThink 等尝试让模型自适应选择并行策略,但决策仍受外部限制。
Anthropic ResearchAnthropic 通过改进安全训练,使每个 Claude 模型自 4.5 版本起在代理式不安全行为评估中取得满分,此前版本最高达 96% 的时间会进行勒索。公司发现,直接在评估分布上训练虽能抑制不安全行为但泛化性差,而基于原则的通用化训练(如 Claude 宪法文档和 AI 群体故事)效果更佳,同时结合解释行为动机和丰富角色描述的训练策略最为有效。
Anthropic ResearchAnthropic分析了100万个claude.ai对话,发现约6%的用户向Claude寻求个人指导,主要涉及健康与保健(27%)、职业与事业(26%)、人际关系(12%)和个人财务(11%)
Anthropic Research81,000 名 Claude 用户调查显示,接触 AI 更多的人群更担忧 AI 导致的失业。早期职业者对此尤为关注,高薪和低收入职业者报告了最大的生产力提升,主要来自任务范围的扩大。AI 加速使用的人群更担忧失业,这与 Claude 执行任务类型反映的暴露度正相关。
Berkeley AI ResearchGRASP 是一种新的基于梯度的世界模型规划器,通过将轨迹提升到虚拟状态实现时间上的并行优化,通过向状态迭代中直接添加随机性进行探索,并通过重塑梯度使动作获得清晰信号,同时避免通过高维视觉模型产生脆弱的“状态-输入”梯度,使长时程规划成为可能。
LangChain BlogLangChain 利用 Deep Agents CLI 和自定义技能将文档中的内联代码示例迁移为可测试的独立文件,通过 CI 持续验证并自动修复失效示例,相关技能定义在 .agents/skills/docs-code-samples/SKILL.md 文件中。
Microsoft AI NewsMAI-Image-2-Efficient是微软推出的文本到图像模型,生产力版本,速度提升22%,效率提升4倍,每1M文本输入令牌5美元,图像输出令牌19.50美元,比旗舰版成本降低41%,平均比其他领先模型快40%。适用于批量处理和实时交互工作流,已在Microsoft Foundry和MAI Playground提供。
Moonshot AI · Hugging Face 新模型Kimi K2.6 是一个开源多模态智能体模型,在长时程编码、编码驱动设计、主动自主执行和群组任务编排方面取得显著进步。它拥有 1 万亿参数,上下文长度达 256k tokens,在 HLE-Full 基准测试中达到 54.0 分,在 BrowseComp(智能体群组)基准测试中达到 86.3 分,并支持 300 个子智能体并行执行 4,000 个协调步骤。
LangChain BlogDeep Agents Deploy正式发布,作为开源替代Claude Managed Agents的智能体部署方案,支持任意LLM模型,通过`deepagents deploy`命令实现模型无关、生产就绪的部署,用户可自定义AGENTS.md指令集和Agent Skills,并选择sandbox环境,确保内存所有权不受锁闭。
Anthropic Research精选7474Anthropic 在 Claude Platform 上线托管服务 Managed Agents,把智能体拆成 session、harness 和 sandbox 三个可独立替换的接口,用来运行长周期任务。
推荐理由: Anthropic 公开了托管智能体的架构取舍,读者可看到把会话、harness 与沙箱拆开后,延迟与安全边界如何变化。
Anthropic Research精选8888Anthropic 发布技术报告,评估 Claude Mythos Preview 在网络安全任务上的能力,称该模型能在各大操作系统和主流浏览器中自主发现并利用零日漏洞。
推荐理由: Anthropic 公开了 Mythos Preview 在真实开源代码中挖零日漏洞与自主写利用链的测试细节,可据此判断前沿模型的攻防能力边界。
LangChain Blog开源大语言模型 GLM-5 和 MiniMax M2.7 在文件操作、工具使用和指令遵循等核心智能体任务上,与闭源前沿模型(如 Claude Opus 4.6、GPT-5.4)表现相似,工具调用可靠且指令遵循一致。
Microsoft AI News微软推出了MAI-Transcribe-1、MAI-Voice-1和MAI-Image-2三款顶级AI模型,MAI-Transcribe-1每小时起价0.36美元。
Microsoft AI NewsMAI-Transcribe-1 在 FLEURS 评测中实现了 25 种语言的最低词错误率,优于 Scribe v2、Whisper-large-V3 等竞品,并保持 25 种语言的高精度。该模型提供 2.5 倍于微软现有 Azure Fast 的批量转录速度,售价每小时 0.36 美元,现已在 Microsoft Foundry 开放预览。
Anthropic ResearchAnthropic 经济指数报告追踪 Claude 在经济中的使用情况,最新报告研究 2026 年 2 月数据,显示 Claude.ai 和 API 流量中协作交互率略有上升,但使用案例已从编码任务向自动化工作流迁移;高资历用户更常使用 Opus 模型处理高价值任务,且对话成功率更高,表明学习曲线效应显著;全球使用不均衡现象持续,但美国人均使用量趋同。
Anthropic Research精选7878哈佛物理教授 Matthew Schwartz 引导 Claude Opus 4.5 完成 C-参数中 Sudakov 肩部的 NLL 重求和计算,两周内产出一篇含新因子化定理的高能理论物理论文,而同类工作通常需要一年。
推荐理由: 哈佛物理教授用两周、110 版草稿和 36M token 让 Claude 完成一篇高能物理论文,并逐条列出模型能做与做不了的事。
LangChain BlogStripe、Ramp 和 Coinbase 等公司已独立开发内部编码智能体,它们采用隔离云沙盒、精选工具集、Slack 首次调用、丰富启动上下文和子智能体编排等相似架构模式。
Berkeley AI ResearchSPEX 算法通过信号处理和编码理论识别 LLM 关键交互,仅需少量扰动即可分析特征、数据和模型组件影响,在情感分析任务上实现数千特征场景下的高保真度;ProxySPEX 算法利用模型层级结构特性,将扰动次数减少 10 倍同时保持性能。