AWS Machine Learning Blog
管理亚马逊 Bedrock 成本的端到端方法:为 FinOps 和平台团队的 playbook
亚马逊 Bedrock 成本管理需要将每美元支出归因到身份、团队和应用,并监控、执行预算、优化平台默认设置,再通过定期审查将数据转化为决策。Bedrock 自动将推理成本归因到 IAM 主体,需通过 CUR 2.0 和成本分配标签实现。解决共享角色问题需采用用户会话管理,使每个用户请求都能独立归因。
AWS Machine Learning Blog亚马逊 Bedrock 成本管理需要将每美元支出归因到身份、团队和应用,并监控、执行预算、优化平台默认设置,再通过定期审查将数据转化为决策。Bedrock 自动将推理成本归因到 IAM 主体,需通过 CUR 2.0 和成本分配标签实现。解决共享角色问题需采用用户会话管理,使每个用户请求都能独立归因。
 NVIDIA Technical Blog6565
开发者在边缘构建新一代智能体,用于监控驾驶员注意力和车厢条件、帮助机器人理解环境规划任务、协调生产线上的机器集群,这些物理 AI 应用需要感知、推理和行动的模型,在严格的内存、功耗和延迟预算内运行。
 Hugging Face Blog4040
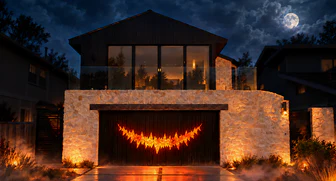
MonsterHouse 是一个用 NVIDIA Nemotron Voice Agent、NVIDIA Nemotron ASR、NVIDIA Nemotron 3.5 Bolt E4B 4GB、Magpie TTS Zeroshot 和 Audio2Face-3D 构建的互动投影,能通过语音与访客交流并模仿脾气暴躁的老海盗声音。
NVIDIA Technical Blog6565开发人员使用 NVIDIA NemoClaw 构建自主智能体,该框架包含模型、执行器和领域特定工具,并支持安全部署。NemoClaw 提供政策执行运行时、优化和可观察性工具,确保智能体在访问真实企业系统和数据时的可靠性和安全性。
NVIDIA Technical Blog6565NVIDIA GPUDirect Storage (GDS) 加速本地和云环境中的 GPU 存储访问,在 NVIDIA GPU 和存储目标之间提供稳健、便携且高效的数据路径,增加带宽、最小化延迟并降低 CPU 和内存利用率。
 IT之家 · AI4040
开发者 FORZGC 利用在 AI 辅助下扒取网站 API 并打包为 Windows Phone 系统可用应用,为微软 Lumia 640 开发新功能;微软 CEO 纳德拉承认放弃 Windows Phone 是错误决定。
 OpenHands Blog3838
OpenHands Agent Canvas 可在分钟内设置 AI 代码审查代理,自动审查 GitHub 拉取请求并遵循编码标准。代理使用 OpenHands 的 `code-review` 技能,优先识别影响生产的逻辑错误、安全漏洞、性能回归和缺失用例,避免次要格式问题,直接在 GitHub PR 中发布包含问题、严重性和建议修复的反馈。
 Cohere Blog3434
使用 Cohere Embed、Rerank 和 Parse 与 Amazon SageMaker AI、OpenSearch Serverless 和 Amazon Bedrock 结合,搜索金融报表并生成带页面级引用的答案。
 Google Developers Blog精选6262
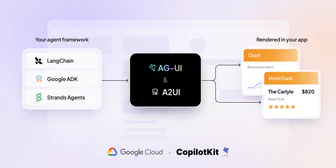
谷歌介绍其框架无关的开放标准 A2UI,让智能体以声明式 JSON 描述界面,由应用用已有组件渲染,并配合 CopilotKit 的 AG-UI 协议接入 LangChain、Google ADK、Mastra、Strands 等智能体框架。
推荐理由: 原文给出 A2UI 与 CopilotKit 的完整接入代码和双向交互示例,可据此判断生成式 UI 的落地方式。
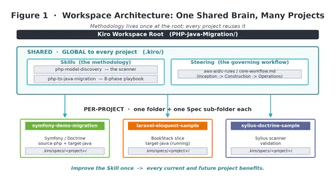
AWS Machine Learning Blog5555Kiro 将 AI 代理与代码库结合,通过可重复的八阶段工作流程将 PHP 应用迁移至 Java,支持开发者交互式审核或 AWS Transform 自动化处理,共享技能文件实现方法论统一。
 Hacker News · AI 热帖6565
一名开发者用 52 分钟手写 C 语言构建了所有 Linux 文件工具,未使用 AI 辅助,并发布了相关视频。
 OpenRouter Blog
OpenRouter 针对 4 个大模型(anthropic/claude-haiku-5.5、openai/gpt-6-luna、deepseek/deepseek-v4.1-flash)。
OpenRouter BlogAnthropic/claude-haiku-5.5 模型配合严格 JSON schema 可从 PDF 中提取表格并返回类型化行,测试五份 PDF(含扫描件)成功提取所有 644 个单元格,失败案例源于 PDF 处理路径而非模型能力,需注意空结果和输出长度限制。
Google Developers Blog5858Agents CLI v1.8.0 通过 eval generate、eval grade 等命令实现 Hill-Climbing 优化 Agent 质量,使用 custom_response_quality 指标对 4 个案例进行 1-5 分评分,发现修改系统提示词为厨师角色导致平均分从 4.0 降至 2.75。该工具支持模型后端实验和自动告警,通过循环迭代提升 Agent 性能。
 LangChain Blog
LangChain 发现近 70% 的 Managed Deep Agent 运行来自定时任务。Crons 通过实现记忆("dreaming")、主动性(探索新动作)、智能筛选(事件流监控)和提醒(定时任务)等机制,使 agents 具备 proactivity、personalization 和 ambient 特性。
OpenRouter Blog5858当你达到 Claude Code 使用限制时,可以通过 OpenRouter API 密钥继续编码,该密钥采用按 token 收费模式且无五小时窗口限制。设置三个环境变量即可切换回原计划,典型短会话在 Claude Sonnet 5.5 上成本为 0.16 美元,Opus 5.5 上为 0.31 美元。
OpenRouter Blog6767Anthropic 的 Claude API 出现 529 Overloaded 错误表示该模型暂时超出容量,通常几秒后可恢复正常。应先使用指数退避重试,若问题持续,则通过 OpenRouter 将请求发送至其他提供相同 Claude 模型的服务商。
IT之家 · AI6565央视实测发现涂鸦未完全覆盖二维码核心数据区时,AI能复原成功;覆盖核心区则无法修复,专家建议处理二维码时打上90%区域马赛克。
 Browser Use
Cloudflare 由于自动化特性(navigator.webdriver 为真,Playwright 默认无头壳用户代理不显示 HeadlessChrome)经常封锁标准无头 Chrome,并且通常来自云服务器 IP、无 Cookie 启动。
 Databricks Blog
Databricks 通过构建包含评审环节的文档提取流程,使用 ai_extract 结合 JSON schema 和全局指令提升准确率,并借助 MLflow Prompt Registry 版本化配置,最终在固定人工标注数据集上验证改进效果,使系统整体性能得到提升。
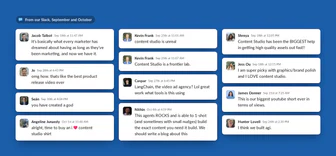
LangChain Blog精选7171LangChain 介绍了其内部设计智能体 Content Studio 的搭建过程,该智能体在 Slack 中接收一句提示词即可产出视频、社交图、UI 图和幻灯片,所有素材均以代码生成。
推荐理由: LangChain 公开了设计智能体 Content Studio 的完整搭建过程,包括技能、wiki、检查门与异步子智能体的分工方式,可作为构建垂直 Agent 的参考。
NVIDIA Technical Blog6565Inclusion AI 在 NVIDIA DGX Spark 上对 Ling-3.0-flash 进行批大小 1 评估时发现解码是内存限制因素,其中 MoE 计算和输出层投影导致执行时间增加。MoE 计算和输出层投影是瓶颈。
 36氪 · AI6565
WISE2026商业之王大会将举办「世界咖啡·产业对接」,面向技术方招募带落地案例的AI应用或具身智能方案。需求方已提前筛选190余家意向企业,技术方需提交含对象、环节、解决事例的方案摘要,通过审核后双向匹配。活动提供交流机会,不保证成交,旨在让技术方直击真实业务痛点。
 OpenAI News
OpenAI 工程师使用 Codex Ultrafast 将事件调查时间从小时缩短至分钟。该工具支持更快的安全分析、代码重构和日常工作流程。
 Claude · YouTube5050
Anthropic 工程师 Doug 分享在站会与发布评审中使用 Claude Docs 的方法。Claude 在文档中协同工作,自动提取数据、验证论点并响应评论中的问题。该工具专为团队协作设计,支持文档内实时分析。
 Google AI Blog4545
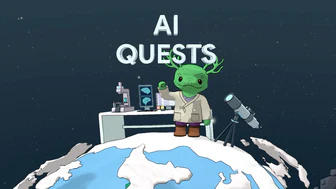
Google AI Quests 系列第三课“极峰”发布,通过游戏化学习神经科学,引导学生扫描和映射大脑神经元以理解记忆损失机制。该课程包含数据清理和模型测试任务,强调 AI 需要人类监督和批判性思维。课程灵感源自 Google AI 十年连接组研究,完成后学生将了解真实世界突破性成果,如完整果蝇脑图谱。
36氪 · AI5050WISE2026商业之王大会将举办「世界咖啡·产业对接」活动,面向企业征集具体业务问题,与技术方进行定向交流。活动通过场景需求方当“桌长”与技术方轮转对接,提前匹配意向,现场聚焦AI应用和具身智能,预计收集需求并促成超100轮对接。
 Hamel Husain5050
仪表盘应通过叙事和自定义数据可视化解释变化、可能原因和下一步,而非让读者自行判断重要性;AI 使构建自定义可视化可行,利益相关者更受益于具体趋势的可视化展示及分析。
 Simon Willison6565
Simon Willison 开发了一个名为 Seam Cutter 的工具,可创建图像的水平或垂直切割线并滑动两侧,实现从图像中间裁剪部分区域。该工具旨在解决在用 Tailor 将多张截图拼接成长图时,需要裁剪中间特定部分(如删除无关提示词)的需求。
IT之家 · AI6565网友“QAQLeonard”为索尼 A7C II 制作了定制固件,直接解锁 FL2、FL3 胶片模式,支持导入外部 LUT、富士 NC、理光 GR 直出色调及创意外观、电子快门声音、竖屏显示等,A7C II Tools 已推出 3.0 版本,是首个拥有正式图形界面的版本。
IT之家 · AI6565开发者 @none25smu 成功为微软 Surface Duo 2 刷入 iOS/iPadOS 26 系统,实现双屏运行并提升至 37 FPS 帧率。项目仍处早期开发阶段,未来计划模拟 Apple Pencil 并移植至初代 Surface Duo。
IT之家 · AI6565阿里千问蒋冠军在2026中国计算机大会上分享个人AI智能体技术实践,认为模型、记忆与生态协同是核心能力三要素。当前AI应用正加速迈向助理阶段,个人AI智能体理论上限接近100%。千问通过建立覆盖30多个行业的用户需求透视图和8000多项原子模型能力要求,提升模型稳定性;利用长期记忆理解用户历史信息关联;构建以模型为中心的开放服务体系整合专业知识、工具及第三方Agent,实现主动服务。
 vLLM Blog精选6060
vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。
推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。
 MarkTechPost5858
Letta 允许开发者创建具备持久化记忆、共享状态和语义检索功能的 Stateful Agentic Engineering Copilots。
IT之家 · AI6565开发者成功为小米 8 手机刷入苹果 iOS 16.5 系统,将机型伪装为 iPhone X,系统桌面显示和动画流畅但项目仍处早期阶段。
IT之家 · AI5858山东聊城90后小伙于建进用豆包AI识别父亲脑梗征兆,AI两次发出警示建议立即就医,帮助老人抓住静脉溶栓4.5小时黄金窗口期,恢复良好。AI在用户犹豫节点上拦截了潜在延误,引发微博热搜。专家提醒AI建议仅作参考,不能替代医生面诊。
IT之家 · AI6565OptiScaler MOD 社区将 AMD FSR 4.1.2 神经网络超分辨率模型移植至 Intel Arc 显卡,借助 XMX 矩阵加速核心实现硬件加速。在 Intel Arc A770 上测试显示,FSR 4.1.2 Lite 平均帧率 101.5 FPS,超分耗时 0.75 毫秒,与原生 XeSS SR 性能接近。
Simon Willison5555Claude Opus 5.5 High 通过提示词在几秒内用 canvas 元素和模拟画笔将照片快速绘制成版本。
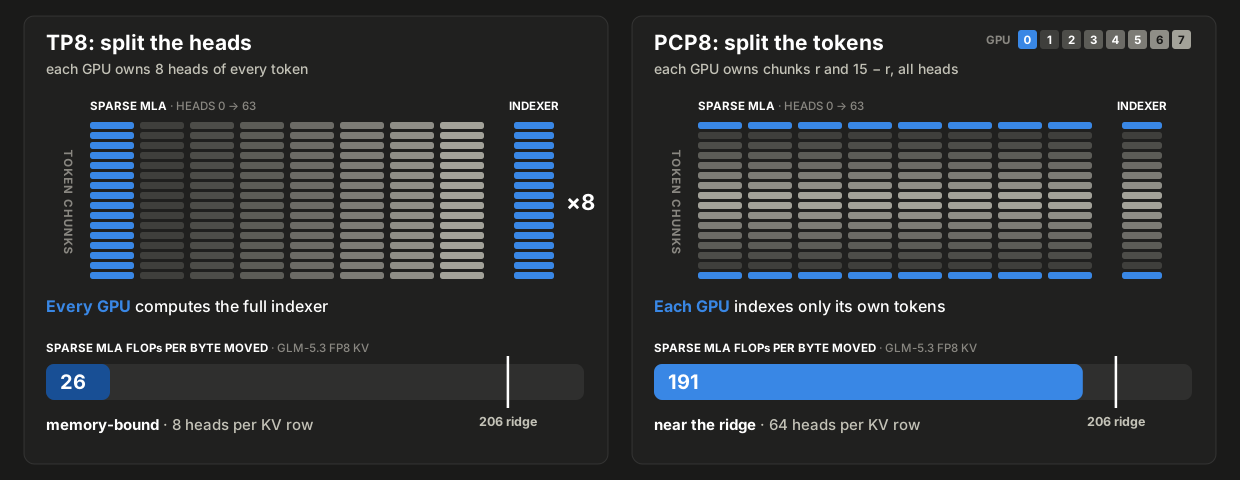
vLLM Blog精选6262vLLM 团队发布 GLM-5.3 优化第二部分,在 16 张 H200 上以 1 个预填节点加 1 个解码节点部署,用 PCP 按 token 切分预填、DCP 按 token 切分 KV cache,使 1M 上下文可放入预填节点
推荐理由: vLLM 团队拆解了 PCP、DCP 与 Hybrid HiSparse 如何在 16 张 H200 上组合,读者可据此理解长上下文部署的内存与预填瓶颈。
AWS Machine Learning Blog使用 AWS CDK 自定义资源可自动编排 SageMaker AI 端点更新时的自动扩展,无需手动干预。通过三个自定义资源(注销、更新、注册可扩展目标、附加扩展策略)实现显式依赖顺序,确保端点配置和自动扩展参数在单一部署中同步更新。部署栈包含三个自定义资源、两个 Step Functions 状态机及十二个 Lambda 函数。