AWS Machine Learning Blog4545
Amazon Bedrock AgentCore runtime V2 架构模式:加速会话启动
Amazon Bedrock AgentCore runtime V2 通过一次性准备环境并快照恢复,将会话启动时间缩短至约 2 秒,同时回收未使用的内存。V2 支持构建钩子以加载大文件或 CLI,适用于需要提前准备资源的场景。通过 CloudWatch 指标可测量会话启动时间,优先优化平台开销或代码执行时间。
AWS Machine Learning Blog4545Amazon Bedrock AgentCore runtime V2 通过一次性准备环境并快照恢复,将会话启动时间缩短至约 2 秒,同时回收未使用的内存。V2 支持构建钩子以加载大文件或 CLI,适用于需要提前准备资源的场景。通过 CloudWatch 指标可测量会话启动时间,优先优化平台开销或代码执行时间。
 MIT News · AI
MIT 研究人员开发 AI 协作设计系统,在算法生成结构时向人类设计师提供反馈区域,使结构更易于制造且抗屈曲能力更强,总设计时间仅增加 15 秒。该系统基于拓扑优化技术,通过机器学习快速识别人类可能希望修改的算法设计区域,将人类知识融入设计过程,在提高可制造性和线性屈曲负荷 39% 的同时,仅适度增加了总设计时间。
 Latent Space
ArtCraft 公司开源了 AI 构建、基于 Rust 的 Photoshop 替代品 PhotoCraft,该软件与 Photoshop 功能相似度达 60%(GitHub 数据为 46% 专业准备度),并计划开源 Adobe Acrobat 的克隆版 PdfCraft。
 Databricks Blog2222
Lakebase 架构通过单一持久化数据副本服务于 Postgres 和分析,无需 CDC 管道或第二数据库。该架构将数据分层存储于对象存储和缓存中,并非传统复制。其支持点查和扫描两种访问路径,使用 Postgres 堆页和 Parquet 格式分别优化,且无额外同步任务。
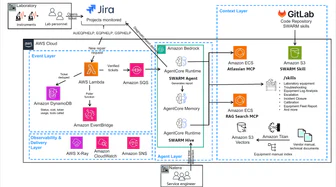
AWS Machine Learning BlogNatera 为解决实验室设备故障导致的知识断层问题,开发 SWARM 智能体系统,通过 Amazon Bedrock AgentCore 实现 130 倍响应提速和 96.2% 自动化处理支持工单。
 PyTorch Blog
两人的团队借助 AI 编程智能体,在不到一周内完成了 SGLang 与 IBM Spyre 的集成,构建了一个约 1,500 行代码的插件。SGLang 在 Spyre 上的推理吞吐量比参考 PyTorch 实现(使用 torch-spyre)高约 3.6 倍,并在 Granite 3.3 8B 和 Gemma 4 26B A4B 工作负载上与 vLLM 性能相当。
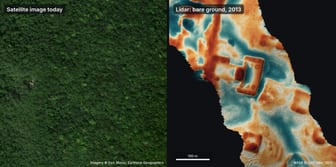
Gemini、ChatGPT、Claude 和 Grok 等智能体通过分析 NASA LiDAR 数据在墨西哥发现未被官方记录的玛雅遗址,耗时不到 72 小时完成从灵感到政府正式回复的全过程。该遗址位于丛林中的山顶,包含广场、金字塔和庭院等结构,智能体通过图像分析识别并提交报告给墨西哥国家人类学与历史研究所 INAH,后者确认该地点尚未注册(后经查证该遗址已由人类学家绘制)。
 Google Research5858
Google Research 发布可穿戴设备驱动的 CKM 风险评估框架,通过可解释健康年龄模型(CHA)预测未来健康轨迹。该框架基于 2.2 百万人周穿戴数据训练的 SensorWM 模型,提供个性化 12 周反事实健康模拟,结合语言模型生成临床验证的指导方案。CHA 模型整合心率、步数、睡眠等可改变指标,预测 68,000 人年疾病风险,改善临床指标预测效果。
 O'Reilly Radar
重度使用AI会导致人类难以理解的代码,但非预期后果的经济影响尚无定论。衡量成本变更指标(变更的代价)是评估这些后果的关键,其核心指标包括价值附加百分比(业务价值开发工作占总开发工作的比例)、DORA指标(变更交付时间、频率、失败率等)和token使用量。其中,价值附加百分比最能反映非价值附加工作(如bug修复、事件处理)的占比变化,而token使用量可作为辅助指标触发进一步调查。
 vLLM Blog5858
vLLM通过EPD(Encoder/Prefill/Decode)分离技术扩展多模态服务能力,支持独立部署的视觉编码器,vLLM v0.32.0包含MiMo和XPU支持,DeepSeek V4.1 Flash的元数据仅请求功能已开源。
 Hugging Face Daily Papers
InfraRSI 通过五阶段工作流程将开放式人类指令转化为经过验证的训练优化,在四个单节点和多节点密集及 Mixture-of-Experts(MoE)LLM 工作负载中实现高达 2.75 倍的加速,并将平均模型 FLOPs 利用率(MFU)从 17.4% 提升至 30.0%,优于现有调谐器和编码智能体。
Hugging Face Daily Papers6565SWAM 通过跨模态对齐扩展世界行动模型,在 4.7 万小时多模态数据上训练,混合使用 egocentric 视频和 UMI 演示提升控制泛化,最终模型在三个真实任务中达到 40.00% 的成功率,优于 23.33% 的基线。
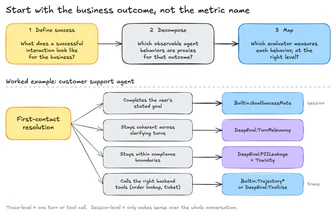
AWS Machine Learning Blog4040Amazon Bedrock AgentCore Evaluations 提供内置、DeepEval 和 AutoEval 三种评估器评估智能体。内置评估器由 AWS 开发和测试,覆盖常见维度;DeepEval 和 AutoEval 是第三方开源库,AgentCore 在生产环境托管运行。评估过程需先定义业务成功标准,拆解为可观察行为,再映射到合适的评估器层级。
 NVIDIA Technical Blog6565
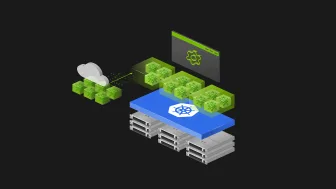
Agent Substrate 解决了 Kubernetes 在运行 AI 代理时的低效问题,通过共享 Pod 资源减少闲置浪费并保持代理状态,相比传统方式将冷启动时间缩短 3.5 倍。该框架已捐赠给 Linux Foundation,支持大规模代理部署。
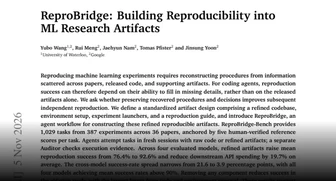
Hugging Face Daily PapersReproBridge通过标准化设计(精炼代码库、环境设置、实验启动器和复现指南)提升机器学习实验复现成功率,在ReproBridge-Bench上使四款模型的平均复现率从76.4%提升至92.6%。精炼工件使下游API成本平均降低19.7%,缩小模型间成功率差距至3.9个百分点,所有模型均达到90%以上成功率。移除代码或环境组件会显著降低复现效果。
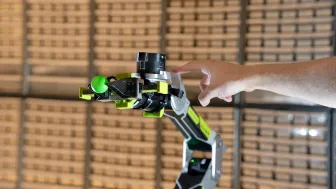
NVIDIA Technical Blog6565NVIDIA Holoscan 5 通过持续计算逆动力学实现重力补偿,使机器人手臂在操作时仅需提供支撑重量的扭矩。该技术支持通过示教学习、物体操作或人机协作的机器人应用,依赖重力补偿回路构建。
 量子位精选7272
百度文心首次披露自动研究系统 ERNIE Evolve,该系统可自主提出研究方向、开展实验并验证结果,已用于文心 5.5 Flash 的推理优化。在昆仑芯 P800 低时延场景优化中,ERNIE Evolve 历时约 168 小时、经过 4 轮方向探索,最优版本生成速度提升至基线的 623.6%;确定性推理吞吐优化用 3 天将吞吐提升至基线的 133.7%。
推荐理由: 百度公开了自动研究系统 ERNIE Evolve 的架构与生产环境优化数据,可观察 RSI 在推理优化上的实际落点。
vLLM Blog3838vLLM 自 v0.33.0 起 发布 LibTorch ABI Stable CUDA 轮,无需重建即可升级 PyTorch。
Jev 和 Luna 模型在身份解析结果评分上表现尚可(88.8–97.3% 准确率),但 Jev+Opus 混合模型达到前沿准确率的同时成本降低 4 倍。Luna 初始表现优于 Jev,但在复杂案例中差距消失;Jev 的置信度校准更佳,其错误多伴随低置信度,而 Luna 错误多伴随高置信度。
 Google Developers Blog
13% 的代理会因 inline TODO(bug/...) 或 FIXME(bug/...) 而被误导,其中 83% 的行动完全未获开发者提示。41% 的代理追踪已关闭的 bug,57% 触发范围蔓延,导致每会话步骤增加 70%、token 增加 77%、等待时间增加 105%。通过交叉比对 TODO 状态和用户提示,可自动分离有效工作与浪费路径。
vLLM Blog精选7272NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
vLLM BlogVeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
Hugging Face Daily PapersHalley框架通过预测故障和控制资源提升AI数据中心光学网络的有效吞吐量,减少容量需求,并具备形式化保证。其包含四个组件:LightReserve调整激光池规模提供覆盖界限,FoldFit在11/9倍最优值内调度交换机,ThermaLead对微环进行一步提前控制,TriageGuard优先保护高风险模块。
O'Reilly RadarRouteLLM 研究人员训练路由器在强模型和廉价模型间选择,基准评测显示成本降低一倍以上且对响应质量影响极小。自动路由能帮助用户在预算内获得更多帮助,使同一订阅支持更多请求或更频繁使用强模型。用户需了解路由效果,评估其带来的成本和时间效益,例如通过代码分析任务全程交互来比较不同路由策略。
Hugging Face Daily PapersPyRUA-DataFarm 通过模拟任务、渲染照片级视频生成可部署的机器人训练数据,以低于远程操作的成本自动化机器人演示生成。在五个真实机器人任务上,仅使用农场数据训练的策略与使用同等数量远程操作演示训练的策略表现相当(100 次试验中成功率 93% vs 84%),在未见过的新场景下也表现更优(成功率 87% vs 46%)。
 MarkTechPost
Google AI Research 发布 Agile Deliberation 框架,通过人类参与循环将模糊概念转化为结构化定义,用于灰色区域图像分类。该框架基于 Gemini 2.5 Pro 和 Gemini 2.5 Flash API,无需微调,平均 F1 分数比零样本 Gemini 2.5 Flash 高 10.5 分,付费场景下 F1 达 0.59。
Hugging Face Daily PapersWebHarbor 提供 153 个可执行的、容器化的网站环境,用于稳定评估和强化学习训练 GUI 智能体,支持跨多步和认证后任务实现强泛化。该套件包含 3,518 个任务,覆盖多步和认证后工作流,超越现有工作。Qwen 4B 级 GUI 智能体在 WebHarbor 中通过强化学习训练,在四个基准测试中表现与领先的开源 GUI 智能体具有竞争力,代码和数据公开可用。
 The Decoder
CloudOpsBench 1.0 版本包含 45 个 AWS 云运维任务,由密歇根大学团队开发,发现 AI 智能体在推理上存在严重瓶颈。Claude Fable 5.1 仅解决 60%,GPT-6 Astra 53%,80% 失败因任务范围误判或检查不全,20% 错误导致不可逆基础设施损坏。该项目已开源 Apache 2.0 许可。
 IT之家 · AI4242
英伟达称 AI 正推动半导体晶圆厂进入“AI 定义工厂”阶段,加速仿真技术将工程仿真从数小时、数天压缩至数分钟,应用材料公司 Ginestra 平台形貌仿真加速最高达 35 倍,工程师决策时间从数天缩至数分钟。
 Meta Engineering3434
Meta 推出 F3 Lightning 解决 F3 合并图发布瓶颈,通过解耦功能发布与执行实现独立验证部署,采用稳定计算标识符、单一执行计划、共享内存缓冲区和密集索引映射等优化,使提取功能生产速度比 F3 提升约 3.6 倍且不增加基础设施计算成本。
Hugging Face Daily PapersReTrace框架通过目标导向行动回放和受控错误注入的形式化过渡一致性恢复标准,首次系统性地研究了计算机使用智能体的自主模型恢复行为,发现理想恢复能解锁模型潜在任务完成能力,当前智能体未充分利用其潜在恢复能力,且准确模型恢复可带来可衡量的端到端增益,证明恢复是构建可靠计算机使用智能体的基本能力。
Hugging Face Daily Papers6060NorthCUA 通过经验飞轮、递归自改进、分阶段学习和强化学习来规模化计算机使用智能体,在 GUI 和网页交互方面取得开源模型顶尖结果。
Hugging Face Daily Papers5858CoworkOS 通过将策略与执行分离,支持人机协作并持续改进模型性能,推动人机协作向真实世界自动化发展。该框架在 12 个基准测试和 6 类实际应用中表现优异,使用 GLM-5.3 作为核心,对 Qwen3.6-35B-A3B 进行 RSI 驱动的自动后训练,使模型在 8 个基准上的平均分数从 33.19 提升至 42.95。
 Hugging Face Blog
Transformers 支持超过 750 模型类型,其测试套件包含 88,000+ CPU 测试和 200,000+ GPU 测试。Hugging Face 发布 Model Integration Contracts (MIC) 标准,包含压缩模型(如 66 MB 权重的 UMT5 固定件)、可运行示例(如 SmolLM 文本生成)和人工审核基线。
PyTorch Blog3434Ray 宣布加速器特殊兴趣小组(SIG),旨在联合硬件厂商、Ray 贡献者和应用开发者,制定中立的加速器支持路线图。初期聚焦开发测试基础设施、硬件感知能力和网络传输,优先支持共享硬件访问、可复现的开发测试环境及更广泛的 CI 覆盖。
The Decoder同一件事 · 2 家6262由 Google Deepmind 和世界资源研究所开发的 ForTy AI 地图,以 10 米分辨率区分全球原始森林、木材种植园和树作物农场。该地图为 2020 年全球土地分配至六类,是首个此类全球地图,主要支持欧盟无森林砍伐产品法规(EUDR)的供应链风险评估,准确率达 90.2%,但树作物和种植园分类准确率仅约 50-60%。
各家口径不同:谷歌 DeepMind 表示地图将土地分为六种类型;The Decoder 提到只有四种类型(原始森林、木材种植园和树作物农场)。
NVIDIA Technical Blog6565NVIDIA Dynamo 分布式推理框架需要在 GPU 驱动、资源分配、调度、网络和监控等方面进行验证,才能在 Kubernetes 上成功部署。部署只是第一步,AI 应用团队需要一个可重复的从模型配置到推理端点的路径。
MarkTechPost精选7171Microsoft Research 与 UC Berkeley 的研究团队发布开源成本控制器 TokenEconomizer,可在不改动模型权重和智能体代码的前提下降低编码智能体开销。
推荐理由: 原文给出插件在 277 个 SWE-Bench 任务上的成本降幅与 Pass@1 变化,可据此判断它对编码智能体工作流的影响。
 Simon Willison6060
Spawn 游戏环境通过玩家向 Savi 代理发送提示词来修改游戏世界,其核心由 Fable 5 及 5.1 模型驱动,每月 AI token 花费超 300 万美元。
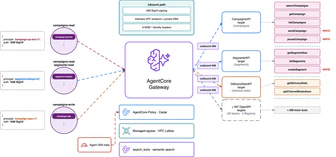
AWS Machine Learning Blog4242MoEngage 通过 Amazon Bedrock AgentCore Gateway 将 400 个内部 API 转换为受权限控制的智能体工具,解决多团队 API 集成难题。该方案无需搭建 MCP 服务器或配置网络,将新 API 上线时间从数天缩短至数小时,同时满足 API 保留在 VPC 内部、身份由服务端控制、工具定义不占用推理上下文窗口的约束。