Hugging Face Daily Papers
嵌入Gemma 2:统一高效的跨模态表示模型
EmbeddingGemma 2 是一个开源的多模态嵌入模型,将文本、图像、音频和视频表示统一在高效且资源灵活的设计中,并在基准测试中表现优异。它在所有模态的嵌入基准测试中建立了新的帕累托前沿,优于专业模型和规模大两到十二倍的其他模型。该模型支持选择性模态编码器加载、可调节的视觉标记预算、可截断的嵌入维度和量化权重,以适应资源受限的环境。
Hugging Face Daily PapersEmbeddingGemma 2 是一个开源的多模态嵌入模型,将文本、图像、音频和视频表示统一在高效且资源灵活的设计中,并在基准测试中表现优异。它在所有模态的嵌入基准测试中建立了新的帕累托前沿,优于专业模型和规模大两到十二倍的其他模型。该模型支持选择性模态编码器加载、可调节的视觉标记预算、可截断的嵌入维度和量化权重,以适应资源受限的环境。
Hugging Face Daily PapersFalcon是一个因果音视频目标说话人提取模型,通过目标说话人嘴部视频从嘈杂重叠语音中提取其声音,结合单次多尺度时频分离器和编码器空间说话人对比损失,在不增加推理成本的情况下减少干扰说话人泄露。
Hugging Face Daily Papers6565DTCA 通过置信度提升和熵校准进行标记级信用分配,提升扩散语言模型的数学推理能力。该框架在 LLaDA-8B-Instruct 上实验显示,在不同生成预算下,数学推理性能提升显著,MATH500 指标提高 9.0 分,GSM8K 指标提高 5.3 分。
Hugging Face Daily PapersRSI Arena 证明自主 AI 智能体能独立用人类反馈训练和迭代改进语言模型,多数智能体在第二阶段实现偏好增益,尽管基准测试提升有限。十款前沿模型作为训练智能体,从 NVIDIA Nemotron 3.5 Lightning 30B-A3B Base 开始,在第一阶段六天内独立选择数据、实施训练、选择检查点,使用 64-GPU 集群和 300 美元 API 信用。
 IT之家 · AI
首批风云气象卫星极端天气 AI 模型发布,台风智能云图解译模型每 15 分钟解译一次,27 秒生成台风分析文本;强对流短临预警模型结合风云四号卫星观测,将预警时间提前至四小时。
IT之家 · AI同一件事 · 2 家Anthropic通过未公开发布的内部Claude研究模型发现Chrome、Safari、Android、Windows和Linux漏洞,并串联为5条攻击链。
 Replit Blog
ViBench 2.0 发布,用于评估模型在长时程软件构建中的能力,包含 17 个产品、241 个功能请求和 544 个测试计划,顶级模型 GPT-6.1 Sol。
 AWS Machine Learning Blog5858
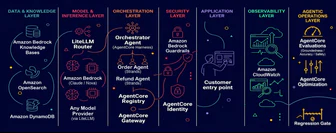
Amazon Bedrock AgentCore 提供 runtime、网关、身份、内存、策略、注册和评估等模块化服务,支持大规模智能体构建、部署和运营。企业级智能体平台蓝图基于 AgentCore,增加了所有权、账户边界、软件交付、可观察性、成本治理和退役等企业级约束,通过推理网关和工具网关实现受控访问,并包含评估流程确保智能体在生产前通过验证。
 LangChain Blog
OpenWiki 使智能体在需要跨来源连接的问题上准确率比单独搜索高约 5 倍,添加证据图将准确率再提高 27% 并使引用一致性翻倍。
Hugging Face Daily PapersEvidenceConnect 框架通过合成图像区域缩略视图生成比较、聚合或链式视觉证据问题,提升 VLM 的证据连接能力,ZwZ2 模型基于此框架训练,未针对任何下游基准但提升细粒度与空间感知,并在具身空间推理、多模态长上下文理解、多模态智能体任务及通用视觉推理上取得进展
 Simon Willison6565
GitHub Octoverse 2026 报告显示,2026年每月合并的拉取请求增至2.2亿,是不到一年前的三倍;提交量超过7.38亿,较之前增长超两倍,主要来自今年下半年;新仓库创建速率翻倍至每月3030万。报告还按行业细分数据,并统计了涉及互操作性或逆向工程的仓库数量。
Hugging Face Daily Papers6565Multiscale Policy Optimization (MPO) 通过在回合尺度上对齐信用分配和政策更新来改进长时程 LLM 智能体训练。在搜索、工具使用和自动化任务上使用 4B 和 30B-A3B 模型的实验表明,MPO 比强 RL 基线有持续提升。
Simon Willison6262Claude Opus 5.5 在 3D 建模、音乐生成和游戏设计方面显著改进,使 AI 构建好玩游戏变得容易。开发者通过单次提示创建了四款 HTML/JavaScript 游戏,包括 Tree Appreciator 和 Emberwick。OpenAI 预计 GPT-6 Astra 年底能匹敌 Opus 5.5 的趣味性。
 MIT Technology Review · AI00
MIT Technology Review 分析了工业 AI 自主性与人类控制结合的最新进展,强调在自动化过程中保持人为监督的重要性。
Hugging Face Daily PapersVibeVideoBench评估代码驱动的视频生成多模态智能体,发现顶尖系统在多数任务上满足核心要求,但常因时间管理不善失败;扩散视频模型能生成惊艳片段,却无法可靠渲染公式。
Hugging Face Daily PapersSPOT 通过预测 token 生成顺序并行验证候选,将扩散语言模型的遍历次数减少高达 6.8 倍,同时保持精确解码。该 0.62M 参数模型读取目标输出分布,预测顺序并提出候选树,目标模型通过状态等式在单次遍历中验证。SPOT 在 SDAR-8B 上将目标遍历次数减少至标准解码的 1/6.8,吞吐量提升 3.4 倍,并在所有任务和预算下超越校准无训练基线。
 MarkTechPost6060
FlashMap通过连续流图绘制器将离散扩散绘制器替换为连续流图,在Qwen3-8B上对GSM8K实现高达6.14倍的无损速度提升,其绘制器权重(Qwen3-8B和Qwen3-4B)已开源至Hugging Face,支持vLLM和SGLang插件。
Hugging Face Daily Papers分解矢量量化技术通过在互补特征视图上使用并行码本提升了离散视觉token质量,使其在多模态理解中能匹配连续表示,在工业级多模态数据上训练的模型在九项指标平均上比 UniAR 和 Emu3-Chat 分别高 22.8% 和 59.2%,是目前首个能与 Qwen3-VL 等强连续表示模型竞争的离散表示模型。
 Ai2 Blog
Ai2 开源模型 olmOCR 2 可用于从文档图像中提取可搜索、结构化文本,包括手写和复杂布局,研究人员已将其用于使档案照片库可搜索并改进手写考古记录的转录。
Hugging Face Daily Papers6565大规模评估显示,专用记忆系统常弱于简单检索增强生成,引入记忆收益与记忆税框架评估净价值。记忆在长时程智能体中日益普遍,但构建记忆相较于直接从原始历史检索的净价值仍不明确。
Hugging Face Daily PapersThe Trinity 框架通过将任务组织成能力树、生成模拟训练世界、路由专业 Harness 模块,递归改进多模态智能体,在 28 个训练基准和 18 个未见基准上提升均值性能 34 和 26 点,包括两个真实世界具身任务。
Hugging Face Daily PapersPDRVLA通过集成轻量级物理动态模块改进机器人行动生成,该模块在物理世界模型监督下预测未来视觉特征,避免在线视频生成带来的延迟。PDRVLA在四个模拟基准上取得99.3%(LIBERO)、89.9%(LIBERO-Plus)、93.6%(RoboTwin~2.0)和81.5%(SimplerEnv)的成功率。
Hugging Face Daily Papers6565Looped Transformers 在相同计算量下通过完整回溯时训练优于截断回溯,扩展规律表明当模型大小可调时两个循环为最佳。Looped Transformers 通过复用共享层块增加计算深度而不增加可训练参数量,通常使用回溯时训练(BPTT),但为节省训练计算量常截断至最后几循环,这可能导致梯度偏差削弱循环优势。
Hugging Face Daily Papers6565HABIT-Bench 评估智能体从数百次会话的合成用户历史中习得习惯的能力,要求智能体整合零散证据并选择新请求的适当行动。使用 Qwen3-235B-A22B 和 GLM-5.3-Flash 评估八种记忆方法,最佳配置在四选任务中达到 33.61% 宏平均准确率,优于随机猜测的 25%。即使提供标注证据,仍存在大量错误,表明理解应如何指导决策比单纯回忆历史更重要。
Hugging Face Daily Papers6565CodeCap-Bench 通过比较代码字幕与自然语言字幕在视频问答和重建任务上的表现,证明代码字幕具有更优的推理准确性和重建保真度。该基准包含 323 个结构化 2D 内容视频,涵盖五个类别,评估发现主流闭源 MLLM 在代码字幕生成上虽表现良好,但难以捕捉复杂时序动态,开源模型差距显著。
IT之家 · AI6565前英特尔 CEO 基辛格通过风投机构 Playground Global 支持内存初创公司 Nagare Labs 开发 Z2RAM 内存技术,完成 500 万美元种子轮融资。Z2RAM 采用氧化物半导体材料,计划通过标准后端工艺(BEOL)实现多层存储结构,无需 EUV 光刻,目标比特密度达 SRAM 的 5 倍以上,计划四年内推出样品。
Hugging Face Daily PapersHarness Self-Evolution通过元技能指导技能适应来改进LLM代理,无需参数更新即可提升弱模型性能。研究发现,技能对强模型有益但对弱模型可能有害,在七种模型和三种基准测试中,有103个任务-技能对使GPT-5.6-luna提升了31.1分,但使Gemma-4-E4B降低了8.8分。
Hugging Face Daily Papers6565Test-Time Memory Evolution (TTME) 方法通过更新外部存储而不改变模型权重,比Test-Time Training (TTT)更高效地指导科学发现。在五个数学任务上,TTME优于TTT,同时将FLOPs计算成本降低82.8-84.6%,运行时间减少47.7-58.4%。
 Browser Use
GPT-6 Astra 在 Odysseys2 长时程网页智能体基准中表现最佳,完成 47 项任务,平均评分为 84.6。该基准包含 100 项真实网页任务,每项任务有 8-12 项通过/失败检查,15 个智能体参与测试,其中 Opus 5.5 高效模式完成 18 项任务,平均评分为 71.2。
Hugging Face Daily Papers6565ThinkWorld模型通过将动作表示为动态链并利用世界想象从无标注人类视频中学习,提升了机器人泛化能力。该VLA框架将每个动作推理表示为动态推理链(CoD),通过强化学习与世界想象结合强化推理,使无标注视频能提供状态转换的直接监督,实现人类与机器人经验的共同推理空间。实验证明其在仿真和真实机器人上有效实现人机迁移并泛化到未见任务和环境。
Hugging Face Daily PapersOvisOCR3是一个0.8B视觉语言模型,通过多导师蒸馏和强化学习统一多种OCR任务,在文档解析、通用OCR、关键信息提取、图文描述和跨页表格重建等任务上达到SOTA结果,在OmniDocBench v1.6上获得96.74分,在OCRBench v2英语和中文拆分中排名第一,并在多个基准测试中超越基线模型。
IT之家 · AI6565百度计划近日披露世界模型研发进展,有望率先用于自动驾驶。世界模型核心在于对物理环境进行建模与预测,若用于自动驾驶可提升复杂场景下的预测与决策能力,为无人车规模化落地提供支撑。目前尚无明确消息关于该模型的具体用途以及与萝卜快跑的关系。
Hugging Face Daily Papers6565Redistribution sensitivity score (RSS) 识别在 27 个预训练 SAE 模型(覆盖 8 个语言模型)上产生可重复特征重新分配模式的特征响应,结合 clean margin 可量化其对下游读出的贡献。
Hugging Face Daily Papers4242Rollback 通过使用世界模型回溯到过去的决策点、探索反事实行动并生成细粒度监督来改进机器人策略,同时通过真实世界反馈不断细化动态。该方法将世界模型从被动模拟器转变为反事实引擎,在真实世界任务上显著提升成功率,并在 8 小时内超越人类玩家的平均成功率。
Hugging Face Daily Papers6565LociArt通过生成精炼网络、自动化数据集构建和专用基准实现精确的局部视频风格化,支持区域风格控制和时间一致性。GRNStyle在生成精炼网络基础上引入极性风格感知掩码,结合表示-几何条件化技术,实验表明其在区域风格质量和空间控制上优于现有方法。LociArt-100K数据集包含10万局部风格化对,基准包含80个源视频和84个目标掩码,采用风格原型相似度评估方案。
Hugging Face Daily PapersChronoReplay训练框架通过将异构时空监督组织成按时间排序的交互片段、保留特定任务答案格式、平衡不同监督信号学习,使单一模型能学习互补时空能力并保持时间一致性,在 OVO-S-Bench、OST-Bench 和 UCS-Bench 基准测试中均取得提升,OST-Bench 提高 13.41 分,同时通过自适应帧选择优化流式推理性能。
Hugging Face Daily PapersHy-Nomas 是一个 8B 参数的扩散模型,支持自由形式文本指令和跨多轮交互的相机控制,通过因果注意力与结构化视频描述相结合的方式遵循多轮文本和相机指令,在人类评估中优于现有世界模型,已开源模型权重、代码和基准。
IT之家 · AI开发者让微软 Surface Duo 2 原生运行 iOS 26,双屏触控已可用,并计划适配 iOS 27。该项目通过移植苹果 XNU 内核和驱动实现,设备被识别为“iPhone 17 Pro Max”,双屏以 37fps 运行,但壁纸显示异常、部分界面存在图形错误。
Hugging Face Daily Papers这篇综述定义了递归自改进(RSI),将可信赖的改进要求组织为改进有效性、约束保持和递归更新阶段的监督。AI系统围绕大模型越来越多地使用经验和反馈来对模型、提示词、记忆、工具和工作流程进行持久性更改。
Hugging Face Daily Papers6565HiP3R 使用层次位姿图将局部视频重建合并为全局一致的相机轨迹和 3D 几何,无需重新训练。它首先优化鲁棒的块级 Sim(3) 图以建立全局布局和尺度,然后固定此布局并估计每帧的共享 SE(3) 相机,将重叠窗口预测转换为单一轨迹。实验在多个基准上证明 HiP3R 在改进相机轨迹和 3D 重建方面的有效性,且适用于基于块和流式后端,无需额外训练或微调。