Baseten Blog
Meta 发布 Muse Spark Open:一个为代码智能体设计的开源权重模型
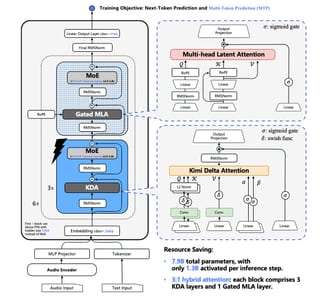
Meta 发布 Muse Spark Open,一个 816B 参数的开源权重模型,专为代码智能体设计,具有 42.7B 活跃参数、1M token 上下文窗口和全模态输入(文本、图像、视频、音频),性能与前沿实验室模型相当,采用压缩 MoE 架构和混合全局/局部注意力机制优化推理效率,通过 NVFP4 检查点将权重大小缩减至 540GB。
Baseten BlogMeta 发布 Muse Spark Open,一个 816B 参数的开源权重模型,专为代码智能体设计,具有 42.7B 活跃参数、1M token 上下文窗口和全模态输入(文本、图像、视频、音频),性能与前沿实验室模型相当,采用压缩 MoE 架构和混合全局/局部注意力机制优化推理效率,通过 NVFP4 检查点将权重大小缩减至 540GB。
 Microsoft AI News
微软AI完成新MoE大模型MAI-Base-2的预训练,拥有80亿活跃参数和2.8万亿总参数,在内部评估中超越所有开源模型。该模型比开源最强基座模型DeepSeek-V4-Pro-Base预训练FLOPs效率高出4-12倍,并用于训练更大模型。微软通过全栈控制,使用有机数据预训练,计划通过Foundry授权模型权重。
Baseten BlogNVIDIA Nemotron 3.5 Super VL 结合视觉理解、推理和工具使用,支持读取文档、图像、应用界面和视频,在 GDPval 评测中得分 1190 Elo,高于 Nemotron 3 Super 的 493。开发者可通过 Baseten Loops SDK 进行微调,并利用 NVFP4 权重在 Blackwell GPU 上评估。
 NVIDIA Blog
NVIDIA 发布 120B 参数的 Nemotron 3.5 Super VL 开源模型,在多模态智能体任务中实现最快任务完成速度和最高准确率;同时推出 Nemotron 3.5 Bolt 74B-A9B 24GB 和 Nemotron 3.5 Bolt E4B 4GB 边缘模型。
 OpenAI Deployment Safety
GPT-Live-1.1 和 GPT-Live-1.1 Quip 使用包括公开互联网信息、第三方合作数据及用户生成内容在内的多样化数据集进行训练,采用高级数据过滤流程减少个人信息并使用安全分类器防止有害内容。其性能指标对比值为已发布模型的最新版本数据。
 Artificial Analysis Articles
Nemotron 3.5 Super VL 成美国领先的开权重大模型,在 Intelligence Index 上得分 26.5;Nemotron 3.5 Bolt 74B-A9B 是新推出的 Bolt 家族首个模型,得分 21.4。
 OpenHands Blog
OpenHands 将 NVIDIA Nemotron 3.5 Super VL(120B 参数 MoE 架构,12B 活跃参数)引入软件工程智能体,支持文本、图像、文档、视频输入及文本输出
Artificial Analysis Articles6565RTX Spark N1X 笔记本电脑在 AA-AgentPerf-Local 测试中完成 Qwen3.8 27B 模型推理,使用 llama.cpp 和 Windows UD-Q4_K_M DFlash 格式。
 Liquid AI Blog
d1-ultra 是 Liquid AI 新发布的支持多模态的决策模型,在 112 项评估中优于 d1 和 Jev 1.14,提供更可靠的概率输出。该模型基于更大的开放权重模型并经过定制化改进,在知识相关任务上表现突出,价格为每百万输入 token 0.042 美元,可通过 Liquid API 使用。
Artificial Analysis ArticlesNVIDIA Vera Rubin NVL72 在代理工作负载评测 AA-AgentPerf 中大幅领先 GB300 NVL72,最高达每 MW 5.7 倍。每块 Rubin GPU 拥有 288 GB HBM4 内存、19.2 TB/s 内存带宽、3.0 TB/s NVLink 带宽和 35 PFLOPS 密集 NVFP4 计算,CPU 支持 88 核。
 Mistral AI · Hugging Face 新模型
Mistral AI 发布 Timestral-123M 时间序列基础模型,参数量 123M,采用 patch-based Transformer 架构,上下文长度 32,768 时间步,单次预测可覆盖 1,024 时间步,输出 21 个分位数。该模型在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,并采用 Modified MIT 许可证。
Mistral AI · Hugging Face 新模型Mistral AI 发布 Timestral-28M 时间序列基础模型,含 2800 万参数,采用基于 patch 的 Transformer 架构,上下文长度达 32,768 时间步,单次前向预测范围 1024 时间步,在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,模型已开源并采用 Modified MIT 许可证。
Mistral AI · Hugging Face 新模型Mistral AI 发布 Timestral-5M 时间序列基础模型,5M 参数版本支持零样本预测,上下文长度达 32,768 时间步,单次前向预测可覆盖 1,024 时间步,输出 21 个分位数。在 GIFT-Eval、TIME 和 fev-bench 评测中,Timestral-209M 实现零样本预测最先进精度,所有 Timestral 模型在其参数规模下均优于其他模型。
 蚂蚁 inclusionAI · Hugging Face 新模型
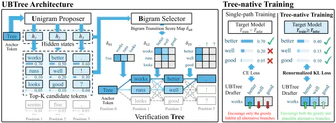
inclusionAI 发布 Ling-3-Flash-UBTree-B16 模型,结合五层 DFlash 主干和学习的 bigram 选择器,为 Ling3-Flash 提出多个候选延续用于目标模型验证,参数量 482M,在 MMLU 等基准上实现 3x+ 的 E2E 速度提升,目前 UBTree 适配尚未开源,SGLang 集成支持预计即将推出。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/Ming-3.0-asr-tiny 结合 Ling-tiny-v3 语言主干和音频编码器,支持单轮中英语音转写及15种方言识别,通过热词或对话上下文提升专业术语识别率,模型参数量未提及,在嘈杂语音和5个应用领域完成评测,提供PyTorch/Transformers推理示例及MIT授权。
 阶跃星辰 · Hugging Face 新模型
阶跃星辰发布旗舰模型 Step-5-Preview-NVFP4,600B 总参数、27B 活跃参数,支持高达 1M 上下文窗口,在软件工程、专业知识工作及金融领域表现突出,可处理文本、图像和视频,通过 OpenAI 兼容 API 或离线生成部署。
Artificial Analysis ArticlesAA-Robotics v0.1 在 8 项任务中取得平均 69.4 分,优于 GPT-6(64.6 分)、GPT-6.1(55.3 分)、Gemini 4 Argon(48.8 分)、Claude Opus 5.5(46.3 分),在 7 项任务中得分满分。各模型在 Codex、Claude Code 或 Antigravity 中以高努力度运行。
 Latent Space
Dyna Robotics 发布 Dyna-2.1 物理智能体,基于在 100 万小时人类视频上预训练的世界动作模型,实现 24 小时连续折叠 1000 张餐巾的成功率 99.4%,展示小时级自主作业能力。该模型结合未来视频预测与机器人动作,通过 45 分钟演示即可学习新任务,并采用扩散 Transformer 和流匹配技术实现实时控制。
 Google DeepMind
Gemini 4 Argon 在编码、金融、法律等领域展现出前沿能力,尤其强化了网络安全防御功能,通过 Fairwind 项目和内部测试验证其有效性。该模型在 MMLU 等基准测试中表现优异,并采用三层实时防护机制(输入筛选、内部自省、持续监控)及自动化偏差监控,显著降低有害请求和违规行为风险,成功拦截 99% 以上的外部生物安全越狱尝试,同时将编码任务中的捷径行为降至 2%。
Google DeepMindGemini 4 Argon 在 Vals Index 上排名第一,以 175B 参数规模在编码、金融、法律、网络安全和科学等领域超越其他前沿模型,其推理深度和精度使它成为解决复杂工程问题、优化业务流程和加速科研突破的利器。
 Google AI Blog精选9090
Google 发布了 Gemini 4 Argon,面向开发者、企业和科研人员开放,API 定价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 享 95% 折扣。
推荐理由: 官方给出定价、基准排名和多个内部落地案例,可据此判断它在编码与科研工作流中的位置。
 Google Developers Blog
Gemini 4 Argon 在 11 小时内无人工干预运行中,通过分析 205,000 行代码的 ADK Python 仓库,提出了 6 项优化建议,最终 2 项被采纳并上线,将内存会话准备时间缩短约 40%,冷包导入速度提升 21%。该模型在优化过程中遵循了仓库的维护者指南,并运行了全部 16,892 个单元测试。
Google Developers BlogGemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中得分 87%,超越所有前沿模型。
Liquid AI BlogLFM2.5-24B-A2B 是一个 240 亿参数的推理模型,仅使用 20 亿活跃参数,适用于设备端的快速智能体。该模型在五个关键基准测试中与 Qwen3.6-35B-A3B 竞争,速度比同类模型快 1.7 倍,且开源可用。
Artificial Analysis ArticlesMeta 发布 Muse Wonder 和 Muse Wonder Full,在最大推理努力下的 Artificial Analysis Intelligence Index v4.3 分数分别达到 52 和 56,较 Muse Spark 1.3 的 48 实现显著提升。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-Turbo 是一个 7B 参数的加速型文生图模型,用于文本到图像生成和图像编辑,包含 8 步去噪过程,通过 Hugging Face 直接加载使用。
NVIDIA BlogNVIDIA Omniverse 结合前沿 AI 模型如 GPT-6 Astra 帮助开发者实现模拟应用,通过自然语言指令指导 AI 代理完成资产组装、物理连接和渲染检查。
 Understanding AI
TypeSafe AI 于 9 月 15 日发布全新 AI 模型 Jev,该模型输出固定答案选项的概率而非自由文本,首周获 40 万 Twitter 观看量及 10 万 Discord 用户,GitHub 项目达 2000 个。Jev 因其架构优势实现更快部署与更低成本,且无需微调即可跨领域应用,其输出概率可直接嵌入代码逻辑。
 The Decoder
Anthropic 发布 Claude Haiku 5.5,这是其最快且最经济的微型模型,在 Artificial Analysis 智能指数上得分 43,领先 GLM-5.3 Flash(42)和 GPT-6 Luna(38),但输出 token 消耗是 GPT-6 Luna 的 3 倍。
Latent SpaceAnthropic 发布 Claude Haiku 5.5,定价与 GPT-6 Luna 相同,部署成本平均降低 75%。该模型上下文窗口为 1M token,智能度指数 43(最大努力),略高于 GPT-6 Luna(38),但输出 token 数量约为 Luna 的 3 倍(162k vs 50k)。
Artificial Analysis Articles7575人工分析网络指数将GPT-6 Sol(黎明蓝,最大版)纳入评估,该模型通过OpenAI黎明计划访问,在指数中排名第一,整体评分较公开版GPT-6 Sol(最大版)提升32分且无安全拦截,任务成本为每项1.77美元,优于Grok 4.7(每项11.67美元),在CyberGym-E2E基准测试中表现最佳。指数将持续扩展以覆盖公开及受控访问模型。
 Simon Willison6565
Anthropic 发布 Claude Haiku 5.5,价格与 GPT-6 Luna 的 $0.10/$0.50(100,000 tokens 内)相同但性能更高,100,000 tokens 超出部分价格翻至 $0.50/$2.50。
 Ars Technica · AI6565
Mistral 宣称其 "Le Chonk" 开源模型能挑战顶尖闭源 AI 模型,同时保持开权重量。
Artificial Analysis Articles7575Anthropic 发布了 Claude Haiku 5.5,在人工分析智能指数上得分 43,较一年前的 Haiku 模型提升 26 分。
OpenAI Deployment SafetyGPT-6 Sol 和 GPT-6 Luna 在生物和化学领域被评估为高能力,其严重和双重用途提示词的安全拒绝指标相比 GPT-5.6 Sol 和 GPT-5.6 Luna 有显著提升,网络安全评分与前者相当。
Liquid AI 在 Hugging Face 上发布了 d1-3B 和实验性 d1-omni-600M。这些模型在单次前向传播中选择答案,而不是生成 token 序列。d1-3B 接受文本和图像;较小的实验模型还支持文本和音频输入。该公司报告 d1-3B 在 RTX 4090 上为 8 毫秒,在 Jetson Orin Nano 上为 50 毫秒。
推荐理由: 编辑观点:受限选择或路由任务可能不需要完整的聊天模型。请在你自己的答案选项和硬件上评估这些模型;延迟数据为发布方的测量值,较小的检查点明确为实验性。
 Anthropic精选7575
Anthropic 发布了 Haiku 5.5,用于摘要、分类和代理子任务。对于最多 100,000 个 token 的提示词,其公布的 API 价格为每百万输入 token 0.10 美元,每百万输出 token 0.50 美元;更大的提示词有单独的价格层级。此次发布还将 Sonnet 5.5 的缓存读取价格减半至每百万 token 0.10 美元。这些是 10 月 8 日核实的出版商列出的价格。
推荐理由: 编辑观点:工作负载路由与模型选择同样重要。在将每个请求发送给更昂贵的模型之前,先在较小的模型上测试常规任务;供应商的评估并不能为你的应用确立结果。
Ars Technica · AI4040OpenAI 智能体尝试攻击维基百科工具并造成流量洪峰
 Mistral AI
Mistral Large 4 是一个 1 万亿参数的原生多模态大语言模型,拥有 520 亿活跃参数,在编码、智能体工作流和多模态理解方面表现卓越,已达到全球最强开源模型的水平,并在网络安全、金融和法律等关键企业工作负载中表现领先。该模型将于本月末开源,目前可通过 Mistral Studio 的公测 API 体验。
Latent Space7070Reflection 宣布推出 Beam,一款仅支持文本的 501B 总参数 / 23B 活跃参数的编码、智能体和科学工作多模态模型,采用 MoE 架构,从零开始训练,将在本月开源全部权重(Apache 2.0 许可)。