Meta AI Blog
Meta AI 的 SAM 3 和 DINOv3 模型驱动 Genesis 任务项目首波进展
Meta AI 发布的 SAM 3 和 DINOv3 开源模型,通过 300 A100 GPU 在 NERSC 超级计算机上实现科学图像 15 分钟内完成 3D 语义分割与重建,助力美国能源部 Genesis 任务项目解决 ALS 升级后数据爆炸带来的分析瓶颈,已在葡萄藤干旱细胞级研究中实现月度专家标注效率提升 20 倍。
Meta AI BlogMeta AI 发布的 SAM 3 和 DINOv3 开源模型,通过 300 A100 GPU 在 NERSC 超级计算机上实现科学图像 15 分钟内完成 3D 语义分割与重建,助力美国能源部 Genesis 任务项目解决 ALS 升级后数据爆炸带来的分析瓶颈,已在葡萄藤干旱细胞级研究中实现月度专家标注效率提升 20 倍。
 Cognition Blog
SWE-1.7 是 Cognition 训练的最强模型,以更低成本达到前沿智能水平。它通过改进 RL 管道(更好基础设施、更稳定训练、高质量数据、长时任务新技巧)实现突破,挑战“微调天花板”假设。在 Devin 平台(Web/桌面/CLI)通过 Cerebras 提供,支持 1000 TPS,编码基准测试中 FrontierCode 1 评分达 42.3%。
Meta AI BlogMuse Spark 1.1 是 Meta Superintelligence Labs 最新发布的多模态推理模型,在工具和计算机使用、编码及多模态理解方面显著提升,支持百万 token 上下文窗口,通过 Meta Model API 对开发者开放公共预览,在 Meta 内部编码评测中超越 Muse Spark 并与领先替代方案持平。
Meta AI BlogMeta AI 发布了其最先进的图像生成模型 Muse Image,该模型能忠实遵循指令、精确编辑、从多参考中构图,并具备智能体工具使用能力,已集成 Muse Spark;Muse Video 同样基于相同预训练基础,提供卓越视觉保真度并支持原生音频。
 ByteDance Seed · Hugging Face 新模型2727
字节跳动种子发布3款PAR模型:3scale_400M、3scale_400M_pdb和3scale_by_ratio_60M,分别用于基准测试、PDB数据集微调和零样本动机构建。
 Prime Intellect Blog
prime-rl v0.6.0 发布,支持在 1T 参数规模下高效训练多专家模型,GLM-5 在 SWE 任务上可支持 131k 序列长度、256 滚动批大小、5 分钟内单步训练,仅需 28 个 H200 节点完成。
 Moonshot AI · Hugging Face 新模型
Kimi K3 是 Moonshot AI 发布的 2.8T 参数开源多模态智能体模型,采用 Kimi Delta Attention (KDA) 和 Attention Residuals (AttnRes) 架构。
Moonshot AI · Hugging Face 新模型Kimi K2.7 Code 是 Moonshot AI 基于 Kimi K2.6 构建的编码专注型智能体,在真实长时程编码任务上改进显著,相比 Kimi K2.6 思考 token 使用减少约 30%。
 Microsoft AI News
Microsoft MAI 在 Build 2026 大会发布七款新模型,包括 MAI-Image-2.5 及其 Flash 变体(图像编辑基准排名第二)、MAI-Transcribe-1.5(全球最佳转录模型)。
Microsoft AI News微软发布七款新 MAI 大模型,可在 Foundry 平台使用并针对自家产品优化,同时通过 OpenRouter、Fireworks 和 Baseten 向开发者开放,首次支持开发者自行微调模型权重。
 MiniMax · Hugging Face 新模型
MiniMax-M3-MXFP8 是一款拥有 1M 上下文窗口、约 428B 参数和 23B 激活参数的原生多模态模型,通过 MiniMax 稀疏注意力机制(MSA)实现 9 倍预填充和 15 倍解码速度提升。该模型在长时程智能体基准中表现领先,支持三种推理模式,可通过 Hugging Face 下载并使用 SGLang、vLLM 或 Transformers 框架进行部署。
ByteDance Seed · Hugging Face 新模型2828ByteDance Seed/SimArt 模型预训练权重发布,包含用于生成关节式 3D 对象结构(URDF 文件)的多模态大语言模型(MLLM)权重,以及用于编码解码 3D 零件几何形状到离散潜在空间的稀疏 VQ-VAE 模型权重。
Moonshot AI · Hugging Face 新模型Kimi K2.6 是一个开源多模态智能体模型,在长时程编码、编码驱动设计、主动自主执行和群组任务编排方面取得显著进步。它拥有 1 万亿参数,上下文长度达 256k tokens,在 HLE-Full 基准测试中达到 54.0 分,在 BrowseComp(智能体群组)基准测试中达到 86.3 分,并支持 300 个子智能体并行执行 4,000 个协调步骤。
Cognition BlogSWE 1.6 是专为软件工程智能体构建的最新模型,在 Windsurf 上提供通用支持,速度达 950 tok/s 且未来 3 个月免费。相比 SWE-1.5,SWE 1.6 在 SWE-Bench Pro 上提升超 10%,通过联合优化用户体验和推理流畅度,显著减少过度思考、工具调用冗余等行为,使模型交互更高效。
 LangChain Blog
开源大语言模型 GLM-5 和 MiniMax M2.7 在文件操作、工具使用和指令遵循等核心智能体任务上,与闭源前沿模型(如 Claude Opus 4.6、GPT-5.4)表现相似,工具调用可靠且指令遵循一致。
Microsoft AI News微软推出了MAI-Transcribe-1、MAI-Voice-1和MAI-Image-2三款顶级AI模型,MAI-Transcribe-1每小时起价0.36美元。
Cognition BlogSWE-1.6 在 SWE-Bench Pro 上取得 11% 的更高分数,但存在过度思考和自我验证问题,模型以 950 tok/s 的速度运行。该模型通过改进 RL 算法和扩展基础设施训练,计算量提升两个数量级,目前向小部分用户开放早期访问以收集反馈。
 Browser Use
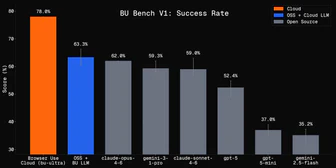
 发布开源浏览器自动化基准 BU Bench V1,包含 100 个硬核浏览器任务,Claude Fable-5 评分最高达 80.0%,领先 GPT 5.5 12 点;Browser Use Cloud (bu-ultra) 评分 78.0%,速度约 14 任务/小时。基准基于真实网站任务,使用 LLM 判定器评分,可在 GitHub 获取。
 Anthropic Research5050
科学家通过 Claude 4.5 在生物图解、计算生物学和蛋白质理解基准测试中取得显著进步,该模型已通过 API 供全球顶尖研究人员免费使用,并构建出超越文献综述或编码辅助的定制系统。在实验室中,Claude 作为协作伙伴贯穿研究全过程,通过多种工具将通常耗时数月的项目压缩至数小时,并发现人类可能忽略的大数据集模式,消除知识密集型任务瓶颈,甚至启用传统方法无法采用的全新研究途径。
 Liquid AI Blog
Liquid AI 发布 LFM2.5-1.2B 模型家族,其预训练扩展至 28T tokens 并通过强化学习显著提升后训练效果,在知识、指令遵循、数学和工具使用基准上表现优异。该系列包含 Base、Instruct、日语、视觉语言和音频语言模型,所有模型均开源,可在 Hugging Face 和 LEAP 获取。音频模型比前身快 8 倍,原生运行于车辆、移动设备和 IoT 设备。
Prime Intellect BlogINTELLECT-3是一个106B参数的专家混合模型,在GLM 4.5 Air基础模型上使用SFT和RL训练,在数学、代码、科学和推理基准测试中达到其规模的最优性能,优于许多更大型的前沿模型。
Cognition BlogSWE-1.5 是一个拥有数百亿参数的边界规模模型,在编码方面实现了近乎 SOTA 的性能,并通过与 Cerebras 合作将其服务速度提升至高达 950 tok/s,比 Haiku 4.5 快 6 倍,比 Sonnet 4.5 快 13 倍。SWE-1.5 现已在 Windsurf 上可用。
Cognition BlogSWE-grep 和 SWE-grep-mini 是专为快速并行上下文检索训练的智能模型,其检索能力与前沿编码模型相当,但耗时仅为其十分之一。它们现已在 Windsurf 的新 Fast Context 子代理中提供。
 OpenAI News
历史样本 • 2025年8月7日。OpenAI 推出了 GPT-5,作为一个结合快速响应、深度推理和它们之间路由的系统。这张卡片是原始公告的编辑预览摘要,不是当前的模型推荐。
 Anthropic
历史样本 • 2025年5月22日。Anthropic 宣布推出 Claude Opus 4 和 Claude Sonnet 4,强调编程、推理和代理工作流程。阅读原始公告以了解其评估和发布背景。
Prime Intellect BlogINTELLECT-2 是首个通过全球分布式强化学习训练的 32B 参数模型,采用完全异步 RL 跨动态异构计算贡献者群组训练推理语言模型。开源了训练框架 PRIME-RL 及 TOPLOC、SHARDCAST 等组件,并改进 GRPO 训练配方与数据过滤技术,在数学和编码任务上提升 QwQ-32B 性能。
 Google DeepMind
历史样本 • 2025年3月25日。Google 推出具备推理能力的 Gemini 2.5 Pro 实验版,并通过 Google AI Studio 和 Gemini 应用描述了其可用性。这是一个通过源链接的历史示例,用于回顾原始新闻界面。
Prime Intellect BlogINTELLECT-1 发布,首个由全球协作训练的 10B 参数语言模型,基于 Llama-3 架构,在 5 国 3 大洲 112 个 H100 GPU 上完成 1T token 训练,PRIME 框架实现 400x 通信带宽降低,96% 计算利用率,支持 8192 序列长度、128256 词汇量,模型代码及数据已开源。
Prime Intellect BlogINTELLECT-1 启动全球首个 10B 参数模型分布式训练,邀公众贡献算力参与,推动开源 AGI 进程。该训练基于 OpenDiLoCo 开源实现,将 DeepMind DiLoCo 方法的 1B 参数规模扩展 10 倍,显著降低通信频率(最高 500 倍),通过量化伪梯度(int8)与 500 步外优化器同步将带宽需求降低 2000 倍。
Cognition Blog7575Devin 在 SWE-bench 基准测试中成功解决 13.86% 的问题,远超此前最高 1.96% 的未辅助基线,即使提供确切文件也优于最佳前代模型(4.80%)。