OpenAI 发布 GPT-6.2 Astra 与 GPT-6.2 Sol,API 价格下调并带来部分基准提升
OpenAI launches GPT-6.2 Astra and Sol with lower API prices and some benchmark gains
OpenAI发布两款语言模型GPT-6.2 Astra和GPT-6.2 Sol,前者面向专业工作、后者面向日常使用,已在ChatGPT Work和Codex中向Plus、Pro、Enterprise、Edu用户开放,开发者可通过API调用。
同一新闻,精选展示《OpenAI发布了GPT-6.2 Astra与GPT-6.2 Sol系统卡。》
同一件事另外 7 家也报道了
各家口径不同:Artificial Analysis Articles称GPT-6.2 Astra得分为60,而OpenAI News提到上下文长度为128k和速度提升3.5倍。
- Artificial Analysis Articles··首发
- OpenAI Deployment Safety··+0 分钟
- OpenAI News··+17 小时 45 分
新增信息:上下文长度为128k;速度提升3.5倍
- The Decoder··+20 小时 31 分·当前阅读
OpenAI 发布 GPT-6.2 Astra 与 GPT-6.2 Sol,API 价格下调并带来部分基准提升
- MarkTechPost··+22 小时 8 分
OpenAI 发布 GPT-6.2 Astra 与 GPT-6.2 Sol,Astra API 价格降 20%。
新增信息:Astra API价格降低20%
- IT之家 · AI··+22 小时 24 分
OpenAI 发布 GPT-6.2 Astra 和 GPT-6.2 Sol 双模型
新增信息:GPT-6.2 Astra效率提升5.2%
- IT之家 · AI··+23 小时 44 分
- 36氪 · AI··+23 小时 55 分
- 量子位··+24 小时 49 分
按发布时间排列 · 事件后续出现时自动追加 · 由模型根据各家标题与摘要比对
OpenAI 发布两款新语言模型。GPT-6.2 Astra 旨在满足专业工作的高要求,而 GPT-6.2 Sol 则面向日常使用。OpenAI 表示两款模型在基准测试中都超越了前代产品,并且运行成本更低。
GPT-6.2 Astra 和 Sol 现在即可供 Plus、Pro、Enterprise 和 Edu 用户在 ChatGPT Work 和 Codex 中使用。Pro-500 订阅者可以使用两种模型的 Ultrafast 模式。首次,Pro-200 订阅者也可以获得 Ultrafast 访问权限,从 GPT-6.2 Sol 开始。
开发者可以通过 OpenAI API 访问这两种模型。OpenAI 表示,GPT-6.2 Astra 的 API 价格比前代产品便宜 20%,为每百万输入 token 8 美元,缓存输入为 0.40 美元,每百万输出 token 为 40 美元。GPT-6.2 Sol 保留 GPT-6.1 Sol 的定价,输入为每百万 token 2 美元,缓存输入为 0.10 美元,输出为每百万 token 10 美元。
OpenAI 将 Astra 称为“科学家世界的最佳模型”,并展示了精美的幻灯片
OpenAI 训练 GPT-6.2 Astra 以更可靠地处理法律、金融和会计等领域的专业会议。该公司表示,演示文稿从模板中提取布局、颜色和排版,匹配精确的字体大小。幻灯片标题旨在捕捉幻灯片的主要内容,而正文则专注于关键细节。
OpenAI 的公告大力强调了其模型的性价比。在测试多步骤专业工作流的基准测试 Agents' Last Exam 中,OpenAI 表示 GPT-6.2 Astra 比其前代产品 GPT-6 Astra 高出 5.2 分,但成本不到三分之一。它在仅占 5% 成本的情况下领先 Anthropic 的 Claude Fable 5.2 5.5 分。只有 Google 的 Gemini 4 Carbon 在这个基准测试中能与 Astra 并驾齐驱。
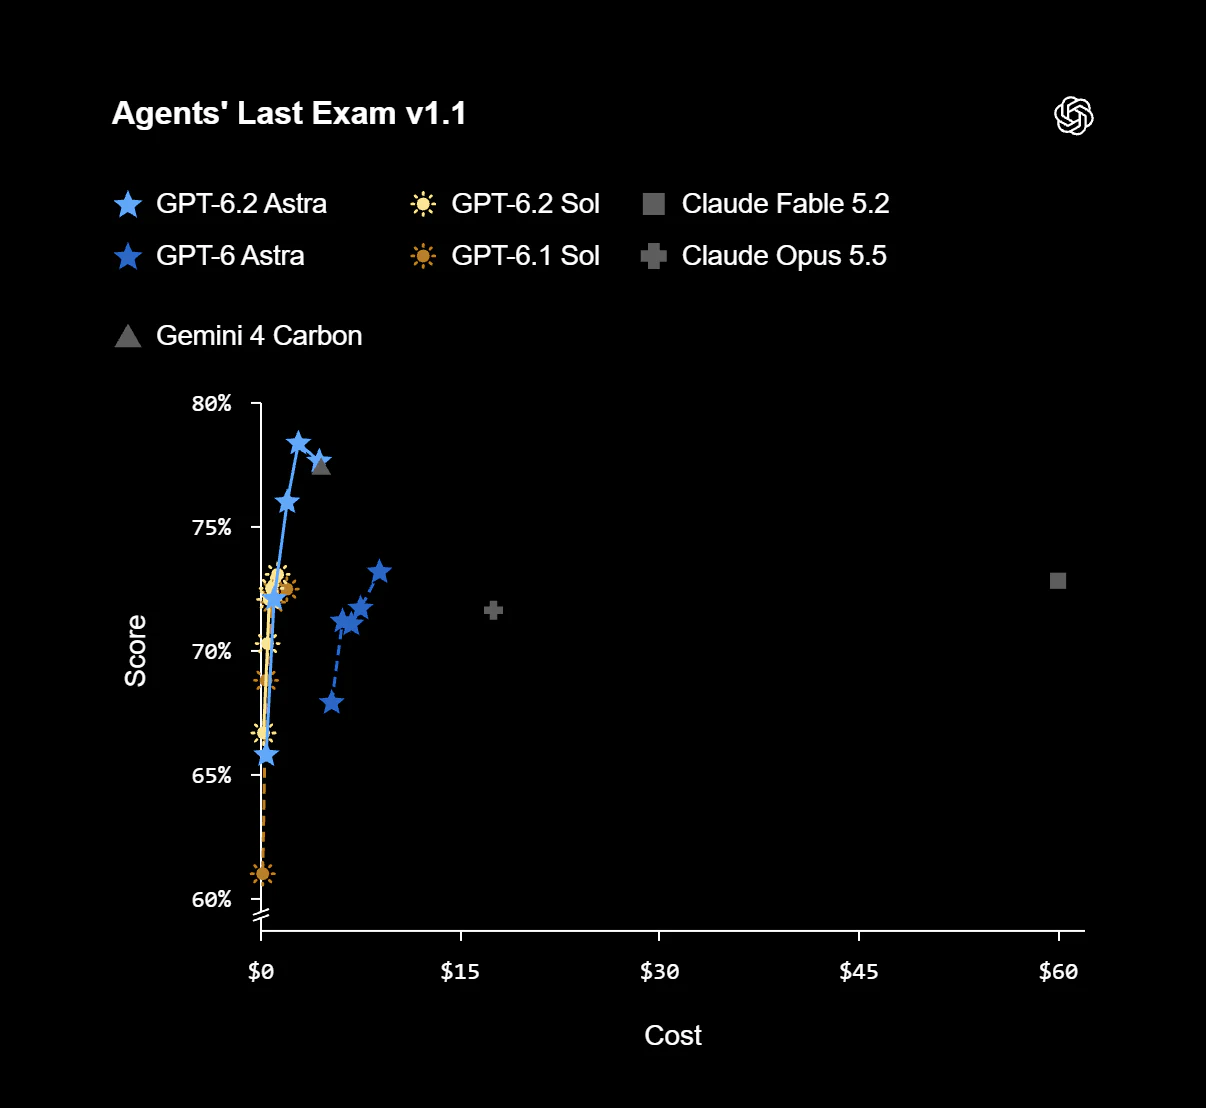
在涵盖合同条款分析等任务的基准测试 Harvey LAB-AA 中,OpenAI 表示 GPT-6.2 Astra 的通过率是 Claude Fable 5.2 的两倍多,但成本约为六分之一。在包括咨询、金融和设计任务的内部 GDPval-v2 基准测试中,OpenAI 表示 Astra 比其前代产品提高了 6.2 个百分点,同时使用了 22% 更少的输出 token。
OpenAI 表示,计算机使用,已经是前代产品的强项,又有了改进。在测试中,据报道该模型构建了一个 3D 车模型,用 Python 编写了一个物理求解器,并在 Blender 中动画化了结果。在另一个演示中,它逐个部分地建模了一个遥控车零件,并生成了一个动画装配指南。
OpenAI 还声称在网页设计方面取得了进展。在 3D 基准测试 AA-3D 中,人类评委比较了两个被屏蔽的交互式体验。GPT-6.2 Astra 以 1,318 Elo 分位居首,领先 Claude Fable 5.2 的 1,271 分和 GPT-6.2 Sol 的 1,259 分。
在测试终端中科学工作流的基准测试 Terminal-Bench-Science 中,该模型的得分比 GPT-6 Astra 高 9 个百分点,再次成本不到三分之一,根据 OpenAI 的说法。OpenAI 表示,Astra 在衡量模型解释生物数据和运行实验能力的 Vals Science Index 上也创下了新高。
Sol 的成本只是原版 Astra 的一小部分,几乎与之持平
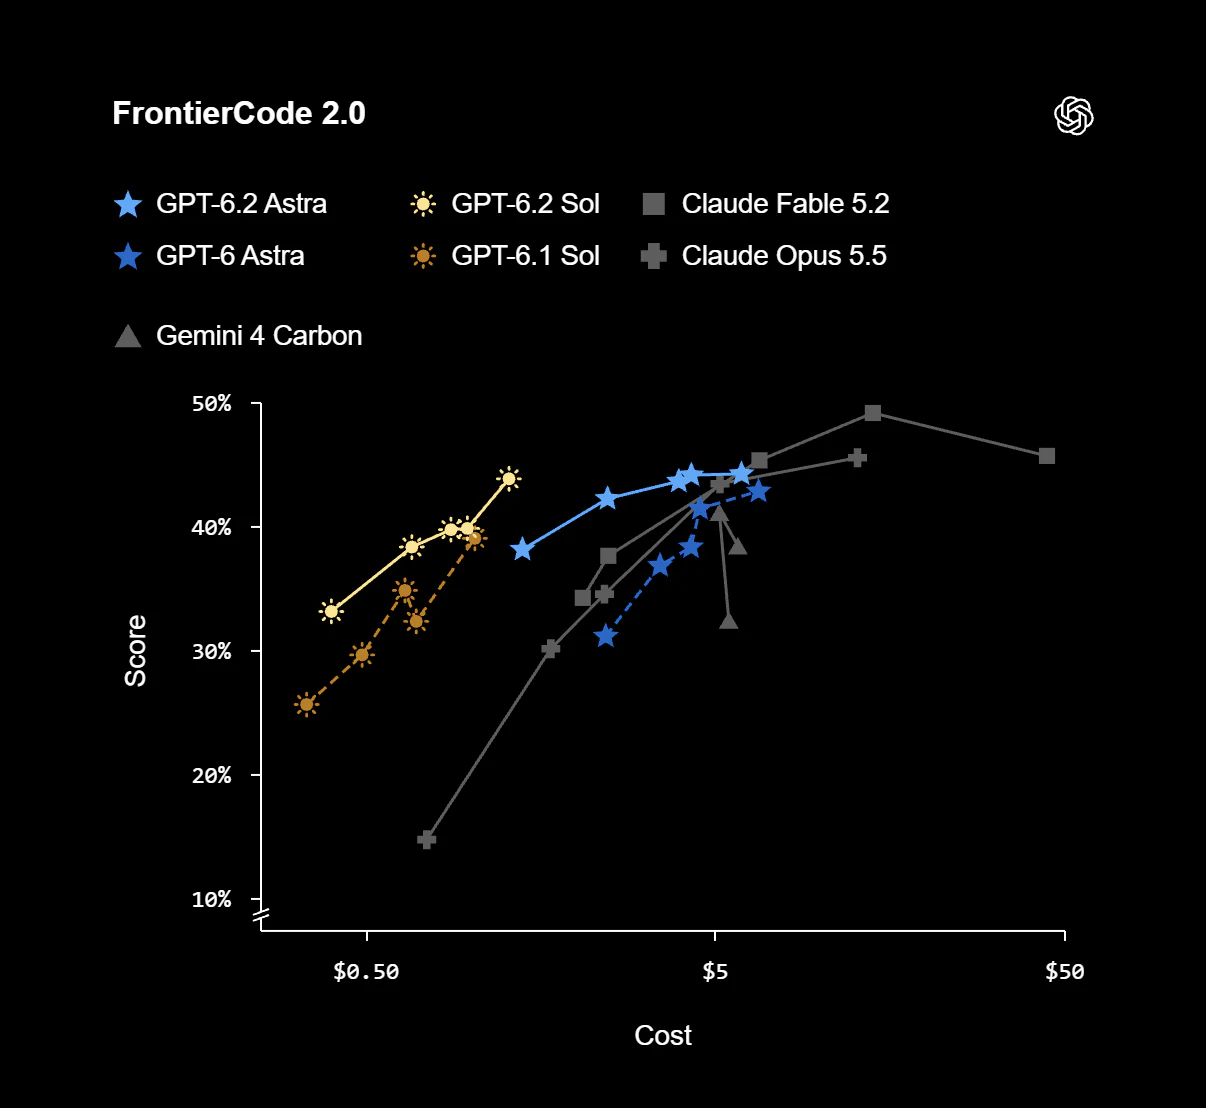
GPT-6.2 Sol 是为需要快速、多功能的日常任务模型而设计的,OpenAI 表示。在检查代码更改是否达到实际项目质量标准的编码基准 FrontierCode 2.0 上,Sol 在成本仅为 Astra 五分之一的情况下,仅落后 0.5 分。OpenAI 表示该模型在处理非工作任务方面表现良好。
根据 OpenAI 的说法,GPT-6.2 Astra 和 Sol 在网络安全方面也有所改进。它们更有效地发现和利用漏洞,编写更安全的代码,并提供更好的错误修复,在几次测试中具有显著更高的 token 效率。两个模型在 OpenAI 的 准备框架 中达到了 "关键" 阈值,就像之前的 GPT-6 Astra 一样。
OpenAI 正在为潜在的高风险网络安全请求添加更严格的保护措施。这些保护措施应该使滥用更难,但也可能限制合法的漏洞研究和安全测试,OpenAI 表示。
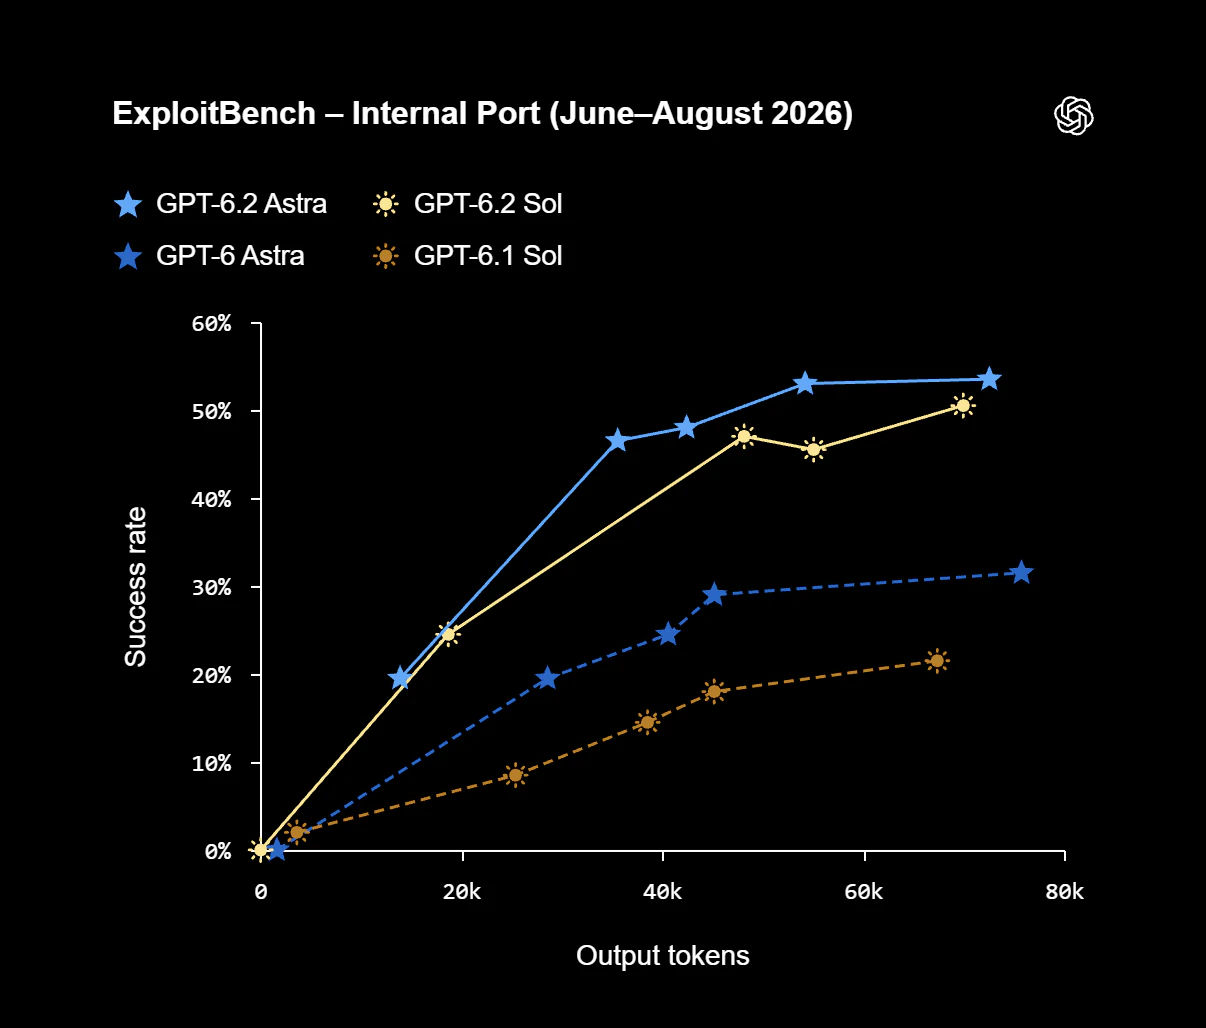
OpenAI 计划通过 OpenAI Daybreak 提供新的模型,该平台已经向经过审核的安全研究人员提供其他限制较少的模型。公布的网络安全基准数据来自关闭了安全防护和分类器的内部测试。OpenAI 在 随附的安全报告 中概述了其方法。
Astra 在人工智能分析指数中位居第二
在人工智能分析指数中,该指数汇总了知识工作、编码、科学和一般知识的九项评估,GPT-6.2 Astra 位居第二,仅次于 Anthropic 的 Claude Fable 5.2。根据人工智能分析的数据,Astra 比之前的 GPT-6 Astra 高了五分,超过了 Google 的 Gemini 4 Carbon(60 分)和 Anthropic 的 Claude Opus 5.5(59 分)。GPT-6.2 Sol 获得 两分,达到 57 分,与 GPT-6 Astra 的水平相当,但每个任务的成本仅为其约 15%。
根据人工智能分析的说法,OpenAI 在成本与性能的帕累托前沿上占据主导地位,即没有其他模型同时更便宜且更好,只有 Anthropic 和 Meta 的模型也落在这个前沿上。OpenAI 在效率方面也占据了大多数顶尖位置,以每个任务输出的 token 数来衡量。Claude Fable 5.2 是唯一一个出现在那里的外部模型。
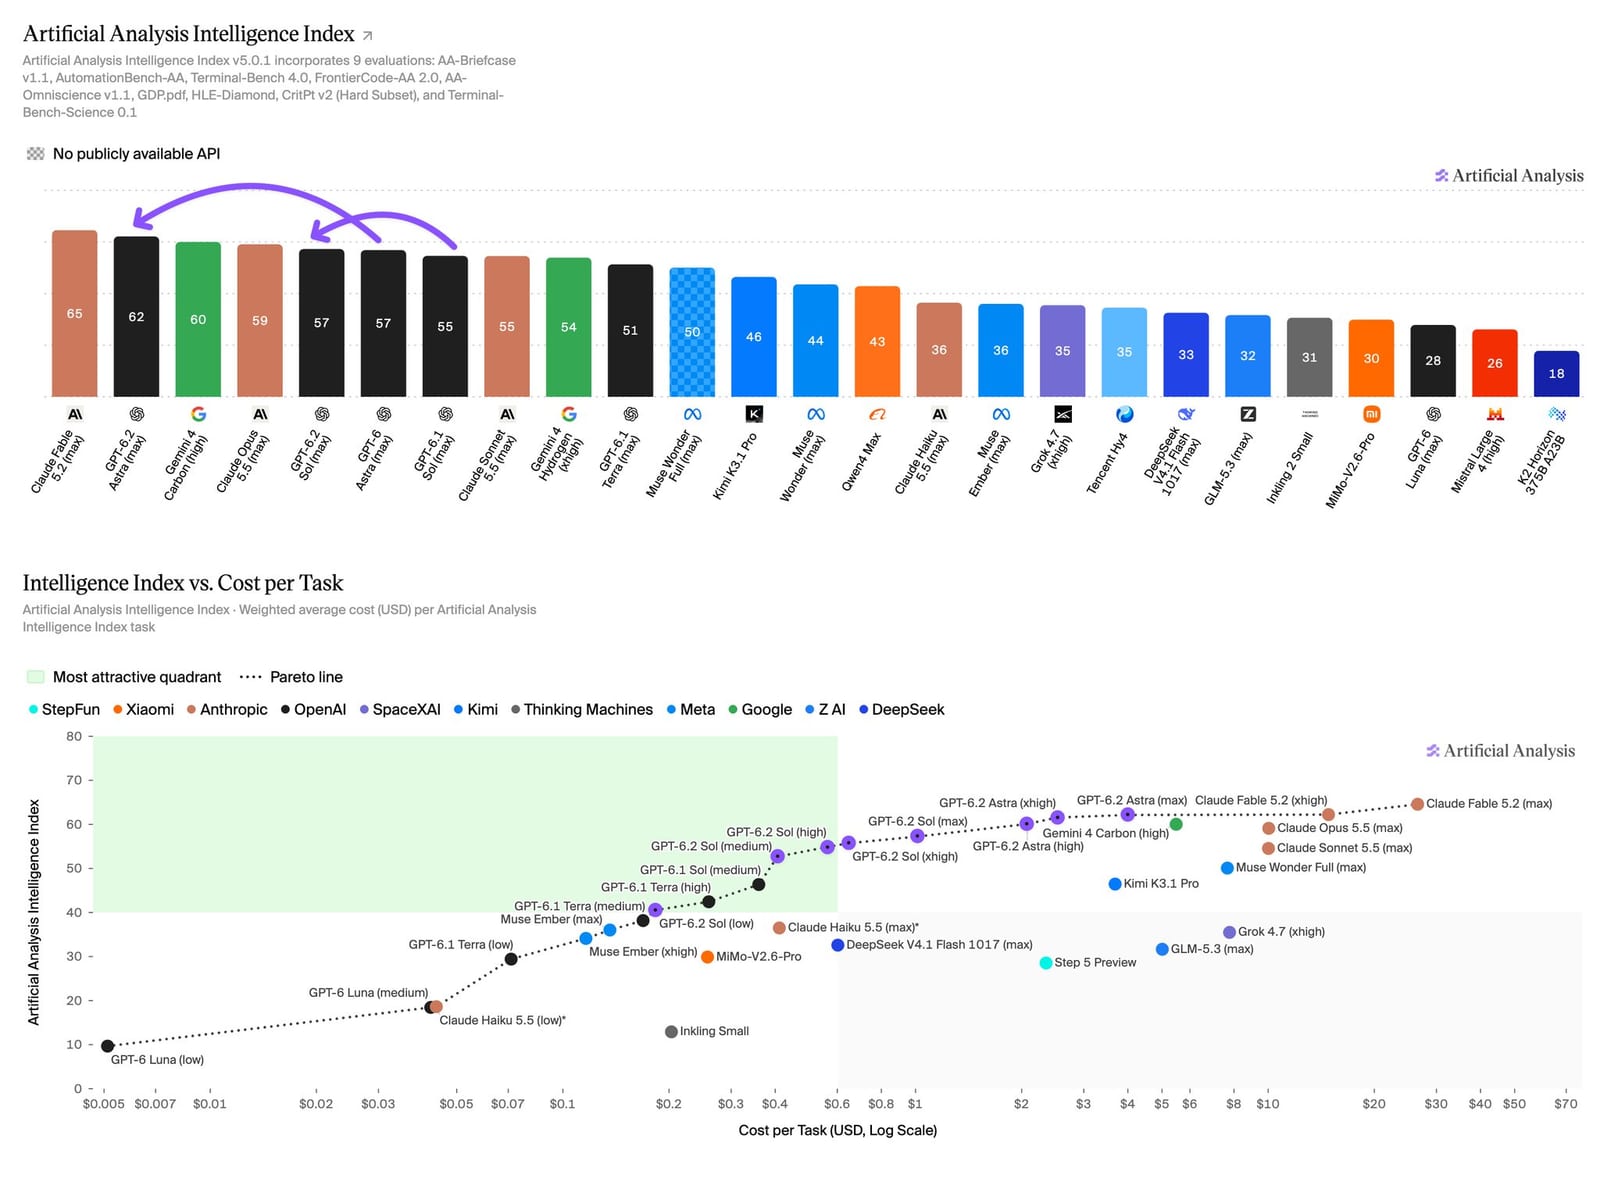
人工智能分析证实了 OpenAI 在科学和事实知识方面的说法。GPT-6.2 Astra 在 Terminal-Bench-Science 0.1 上领先,并在物理学推理测试 CritPt v2、事实知识基准 AA-Omniscience 和知识基准 HLE-Diamond 上位居第二,仅次于 Claude Fable 5.2。Astra 在 3D 设计(AA-3D)和机器人技术(AA-Robotics v0.1)中也领先,在机器人技术上得分为 79 分,高于 Sol 的 78 分和 Claude Fable 5.2 的 75 分。
编程则又是另一回事了。据人工智能分析,这两个模型都停滞不前了。在编程代理指数中,使用Codex harness在最大计算能力下,GPT-6.2 Astra仍然保持在GPT-6 Astra的位置。GPT-6.2 Sol实际上比GPT-6.1 Sol下降了三个点。这种下降来自于在SWE-Atlas-QnA-AA上的14点滑落,其中该模型在回答中省略关键事实的频率比其前身更高。
人工智能分析还指出高幻觉率。在最大努力下,GPT-6.2 Astra有59%的时间出现幻觉,Sol有55%。这个指标是AA全知幻觉率,它衡量模型在事实性问题上猜测的频率,而不是说不知道。这些问题非常难,所以这些数字并不反映日常幻觉率。
Epoch AI发现Astra与Fable 5.2相当,但在实际任务中较弱
研究机构 Epoch AI 在发布前使用自己的基准测试测试了 GPT-6.2 Astra。该模型在 Epoch 能力指数 (ECI) 中得分为 174 分,与 Anthropic 的 Fable 5.2 并列。根据 Epoch AI 的说法,这两个模型都超过了 Astra 之前推理模型的预期趋势。
在实际任务中,这些任务来自Epoch AI自己的研究,Astra落后于Fable 5.2,并且几乎没有比GPT-6 Astra有所改进。根据Epoch AI的说法,该模型在简单的科研项目中错过了中心问题,并且试图解决问题时白费力气。在关于研究AI数据中心的任务中,Astra过于谨慎,跳过了关键估计,Epoch AI表示没有承包商能逃脱这样的问题。Epoch AI认为,与其他测试模型相比,Astra的写作相对较强,但仍然低于其自己的标准。
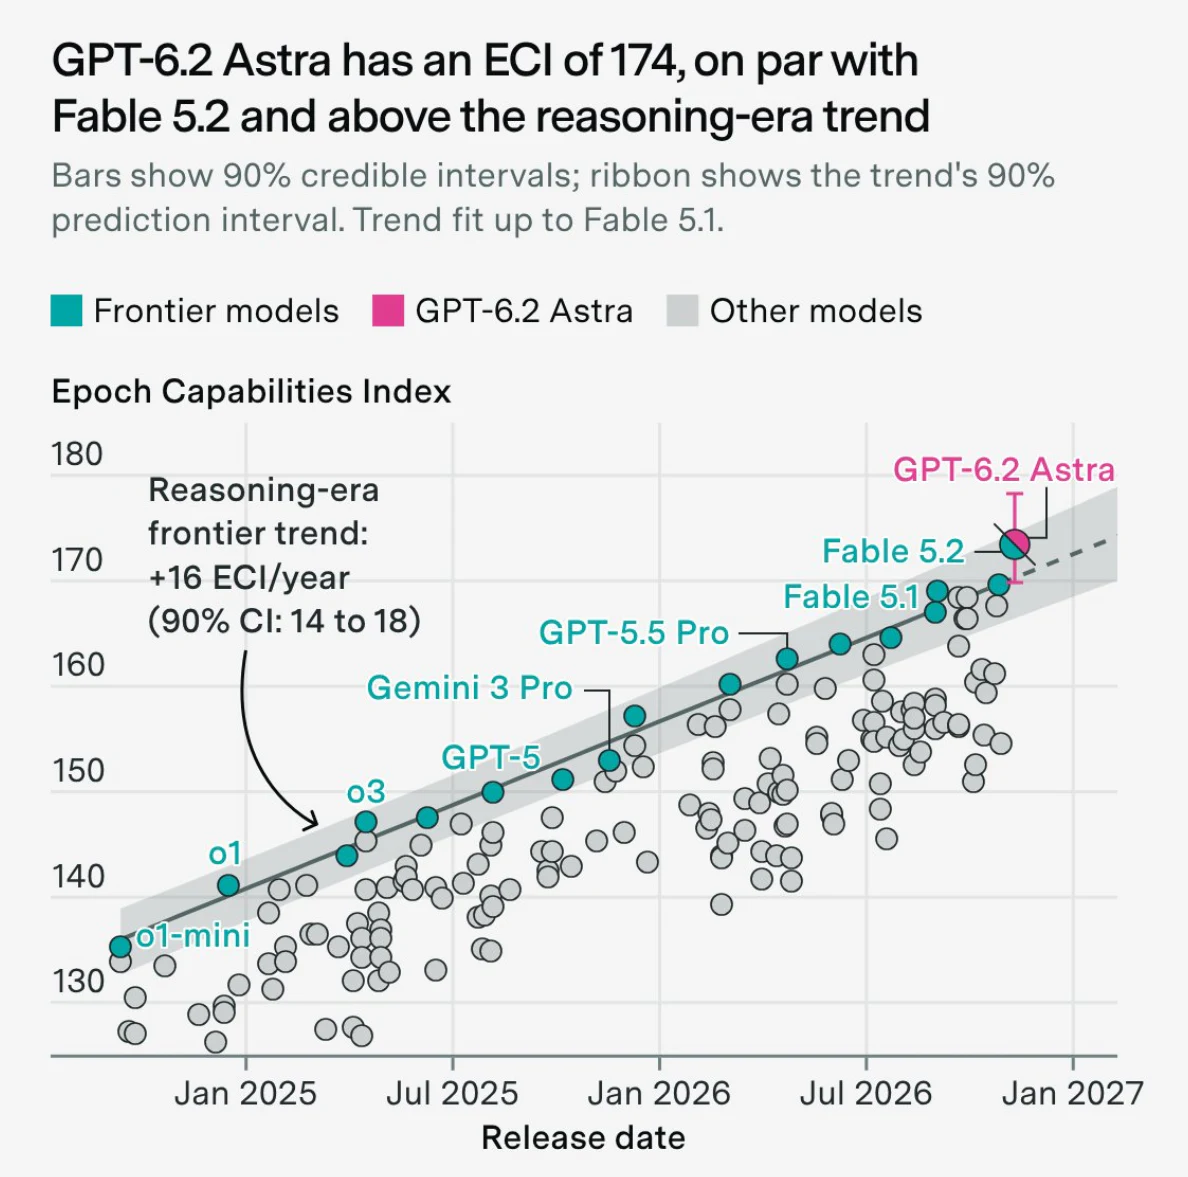
有一件事很突出,那就是Astra能够在单个输出令牌内运行复杂的推理,没有任何可见的思维链。Epoch AI为Astra记录了12.3个串行步骤,比GPT-6 Astra的10.5个和Claude Fable 5.1的4.2个(当时最强的非OpenAI模型)要多。能够以这种方式推理而不展示其过程的模型 更难监控,这是一个已经出现在第一个Astra模型中的安全问题。
在FrontierMath Erdős上,这是一个未解决的数学问题基准测试,GPT-6.2 Astra解决了68个任务中的7个,每个任务都在证明助手Lean中正式验证。旧记录是GPT-6.1 Sol的3个中的68个。其中的七个任务在之前没有已知的解决方案。
Vals AI将Astra和Sol放在前10名,但发现法律薄弱环节
GPT-6.2 Astra排名第7,GPT-6.2 Sol排名第9,在Vals指数中,两者仅相差1.6分。但价格差距很大。Sol每个任务运行3.18美元,不到Astra的10.68美元的三分之一,使其成为前10名中最便宜的模式,根据Vals AI的说法。Astra也比其前身便宜,得分比GPT-6 Astra高2.6分,大约是其每个任务成本21.28美元的一半。Vals AI表示,Astra是前10名中使用输出令牌最少的模型,每个任务平均为91,000个。
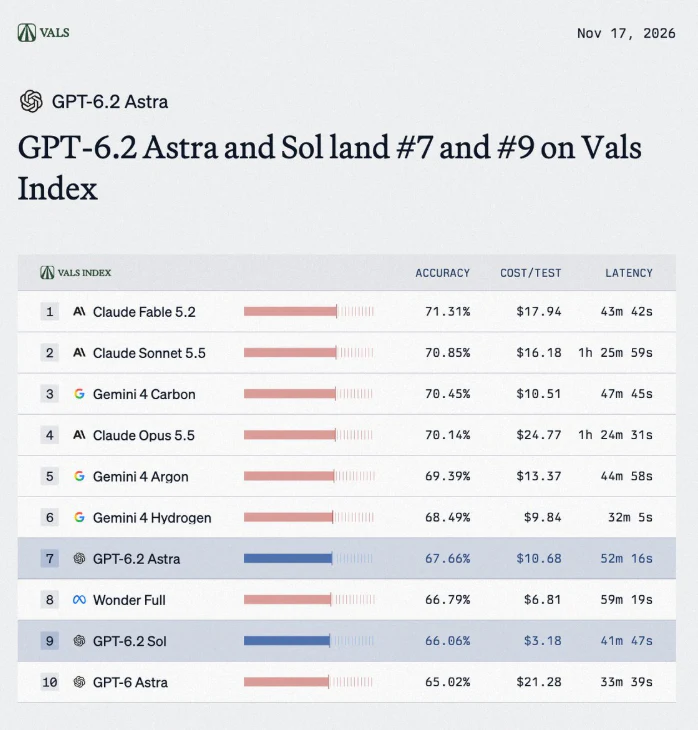
Vals AI 支持OpenAI关于在Vals科学指数中位居榜首的主张。Astra 领先该排名,并在Terminal-Bench Science和VCB 1–100中位居第一,其成本和运行时间约为GPT-6 Astra的一半。Sol 在Terminal-Bench Science中位列第三,成本约为Astra的四分之一。在更广泛的Terminal-Bench 4用于代理编码方面,Astra位列第五,Sol位列第七。
根据Vals AI的说法,法律测试是模型表现不足的地方。在HLAB基准测试中,Astra和Sol的成绩是其前代模型的两倍,但排名仅为第11位和第21位。在法律研究基准测试中,下降趋势更为明显,Astra排名第30位,Sol排名第52位。Vals AI表示,这些模型调用的工具次数几乎是前代模型的两倍,但写出的答案更短。
9月,OpenAI宣布推出一款名为"Astra for Law"的专业产品。它在法律研究基准测试中的表现明显优于基础模型,达到了第6位。Vals AI使用了一百万个token的上下文窗口和128,000个最大输出token,在完全推理努力下测试了这两个模型。
GPT-6.2 Astra是首个达到OpenAI AI自我改进"高"标准的发布模型。
根据OpenAI的说法,GPT-6.2 Astra是首个达到AI自我改进"高"标准的对外发布模型。OpenAI表示,该模型可以显著加速AI研究,相当于为每位OpenAI研究员额外配备了一名高技能的研究工程师。
OpenAI明确指出这是一种风险。能够帮助构建未来AI系统的模型可能会比安全措施和人工监督更快地推动该领域的发展。目前,该行业正在以"RSI"为标签应对这一问题。
作为反制措施,OpenAI指出研究环境中的更严格控制及其监控系统Control Room,该系统可以跟踪研究任务并在必要时关闭它们。该公司还表示,它已经扩展了监控范围,以检查模型推理和行动的方式,并自动标记未经授权的行为。
在一致性方面,即模型遵循用户指令和公开沟通的程度,根据OpenAI的说法,新模型与其前代模型相当。然而,在两个测试中,它们更经常无法标记阻碍其工作的障碍,例如缺失的文件或不可用的搜索工具。
来源: The Decoder · the-decoder.com