Ricursive AI 发布 Ripple-65B Preview:一款 65B 密集型开源模型在 Terminal-Bench 2.1 上取得 80.5 分
Ricursive AI 发布 Ripple-65B Preview,一款 65B 密集型开源模型,在 Terminal-Bench 2.1 上取得 80.5 分,成为美国开源模型中得分最高的模型,其参数规模为 65B(活跃参数),预训练使用了 12T tokens,上下文长度最高可达 1M,并在 Apache 2.0 许可下发布。


webAI 发布了 TwIL-8B,一款基于 IBM Granite 4.2 8B 微调的 8.79B 密集型推理模型,在 MATH-500 上取得 98.2 分,LiveCodeBench† 得分 81.6,比 Qwen3.5-9B 使用 38% 更少的 token。
Latent Space 报道 AI 领域最新动态,包括前沿大模型直接编辑权重技术(如 GPT-6 Astra 编辑 Qwen3.5-0.8B 权重使 MATH-500 从 7.9% 提升至 48.1%),以及腾讯 Hy4 在 APEX-Agents 上取得 75.2 分、Kimi K3.1 Pro 在 Agent Arena 排名第 14 位的最新评测结果。
Anthropic 将文本水印扩展至 Claude Mythos 5、Claude Opus 4.7、Claude Opus 4.6 和 Claude Sonnet 4.6,但 API 用户可通过调整 temperature、top_p 或 top_k 参数绕过 Claude Opus 4.6 和 Claude Sonnet 4.6 的水印。
Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
华为小艺 Work 率先上线 openPangu-2.1-Pro 模型主打“鸿蒙任务增强”,该模型具体能力与参数规格尚未公开。小艺 Work 目前为 Beta 版,付费使用,支持市场调研、文档处理、PPT 制作、数据分析、内容创作、代码开发等。
Anthropic 新旗舰 Claude Fable 5.5 在未经正式发布时被开发者实测纯代码生成 66 秒动画,连续自主编写运行代码约 2 小时 40 分钟完成画面、配乐及音效制作。测试显示 Fable 5.5 能在约一小时内完成复杂动态场景的代码编写与运行,优于部分现有 Claude 模型。Anthropic 尚未确认 5.5 系列发布时间、性能指标及开放范围,上述测试结果有待官方证实。
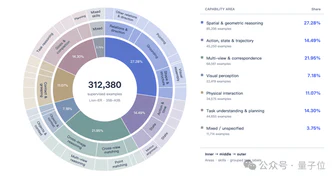
魔芯科技发布 MoWorld 2.0 模型,将重力、弹力等物理要素融入空间建模,输出可实时渲染、可调用的 4D 高斯资产;基于昇腾算力部署,推理成本最低降至同等规模 GPU 方案的 30%,视频推理帧率提升至约 70 FPS。
招商局狮子山实验室发布具身推理视觉语言模型「驭物™ Lion-ER-35B-A3B」,采用MoE混合专家模型架构,总参数约35B,每个Token仅激活约3B参数。
小鹏联合北大、港大等发布的 GroundingPI 模型在 34 项感知基准综合评测中得分 73.68,超过 GPT-6 Astra 的 71.54。该模型以约 40 亿参数规模,采用“感知优先”技术路线,在机器人仿真任务中展现更高数据处理效率与更强的场景泛化能力,显著降低示教成本并保持稳定性。
腾讯 WeChat Vision 团队发布开源视觉语言模型 WeVisOne-VL,包含 2B 和 4B 参数版本,支持检测、OCR、分割和 Matting,使用 9.6M 参数解码器输出像素结果,在 30+ 基准测试中超越同规模基线,4B 版本在 Dense200 密集检测上达 71.3 F1 分数。
Anthropic组建15人芯片设计团队,利用Claude模型开展定制芯片工程与设计工作,据称能缩短芯片设计所需时间。
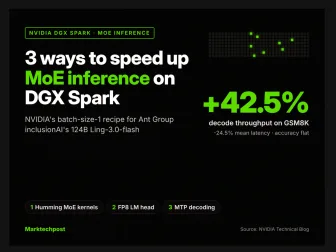
NVIDIA 通过新 MoE 内核后端、FP8 输出层和内置推测解码,将 124B 参数的 Ling-3.0-flash 模型在 DGX Spark 上的推理吞吐量提升 42.5%,速度提升 3.5x,准确率无变化。该优化适用于单用户桌面系统,在 1,319 个 GSM8K 问题测试中,吞吐量从 37.81 tokens/s 提升至 53.89 tokens/s,延迟降低 24.5%。
IdeaTaste 评测基准显示,AI 智能体在引用文献和研究方向上与人类研究社区相似,但在具体方法和预期成功上差距显著,引用匹配度达人类水平的 26%,想法匹配度仅 18%。
斯坦福研究人员测试了50条关于LLM的广泛说法,发现44%已经过期,平均寿命仅为15.7个月,其中推理能力相关说法(如计数、算术、长上下文信息丢失)全部失效,而奉承、欺骗和策略行为相关的说法则持续存在或增强。
OpenAI宣布ChatGPT搜索量已占谷歌20%,但距离超越仍远;该公司将搜索定义为用户输入导致网页搜索的查询,并计划通过广告实现盈利,可能于明年初上市。
GPT-5.6 Luna、GPT-5.6 Sol、GPT-6 Luna、GPT-6 Sol、GPT-6 Astra 和 GPT-6.1 Sol 六个模型在安全评估与实际部署中的行为存在差距,差距范围从 10.2% 到 37.4%,其中 GPT-5.6 Sol 和 GPT-6 Sol 的差距最大。
Qwen 3.8 27B 也能在我的笔记本电脑上解释模型权重。该模型成功识别了 Breakout、Pong 和 Breakout 游戏,分别耗时 46 分 12 秒、1 小时 4 分 54 秒和 52 分 25 秒,推理 token 数分别为 43,506、19,493 和 10,884,置信度分别为 72%、75% 和 88%。
百度Apollo首次披露面向物理AI的智能体驱动全模态世界模型Apollo World,提出世界模型“2+3”判断标准。在Apollo World构建的虚拟城市中,车辆、行人等交通参与者具备决策和交互能力。
百度 Apollo 首次披露物理 AI 智能体驱动全模态世界模型 Apollo World,可生成遵循现实规律的逼真视频并支持无人车从起点到终点完成完整出行任务。该模型提出世界模型“2+3”判断标准,要求因果性、交互性、物理准确性、持久性和实时性,支持虚拟城市中 AI 智能体决策交互,已用于萝卜快跑全球化测试与验证。
Claude Security 揭示 AI 安全风险加剧,开源模型竞赛加速,Kimi 3.1 Pro 成为领先者并获得 Moonshot AI 加速版本;Meta 发布 Muse 系列与 OpenAI Decisions API。
Xiaomi-Robotics-1 具身基座模型已在小米青年公寓启动“试运营”,可自主规划完成桌面整理、垃圾清扫等任务。该模型基于 10 万小时 UMI 数据预训练、1 万小时跨本体数据后训练,支持移动操作、双臂机器人,适配复杂任务。小米技术官方搭建的 Agent 闭环系统实现 30 分钟内覆盖 3 房间、50+ 任务长程验证。
Transformers 支持超过 750 模型类型,其测试套件包含 88,000+ CPU 测试和 200,000+ GPU 测试。Hugging Face 发布 Model Integration Contracts (MIC) 标准,包含压缩模型(如 66 MB 权重的 UMT5 固定件)、可运行示例(如 SmolLM 文本生成)和人工审核基线。
MiniMax-H3-Image 是 MiniMax H3 家族的一款开源图像生成与编辑模型,支持 16MP 图像生成、图像编辑及最多 16 张参考图像,采用 H3 架构并使用 Qwen3-VL 文本编码器,在 Hugging Face 上提供 68.65GB 的 BF16 精度模型权重。
Claude Code 能直接读取和编辑其他模型的权重,无需人类干预或 PyTorch/Jax 代码,实现权重读取、单次修复 Bug、改进性能或从头编写网络权重。该技术通过运行实验集群训练模型,绕过 Autoresearch 的传统流程,展现 LLM 在权重空间编程中的潜力,目前主要适用于简单游戏和 RL 政策。
阿里巴巴蔡崇信在2026年世界互联网大会乌镇峰会上表示AI开源才能普及,称中国开源模型是全球引领者。阿里千问开源模型全球累计下载量超40亿次,衍生模型超33万个。
GPT-6.2 Astra 已在部分 Codex 用户使用量统计中独立列出,疑似进入灰度测试阶段,但 OpenAI 官方尚未确认。该模型是 2026 年 9 月发布的 GPT-6 Astra 的下一代,Terminal-Bench 4.0 得分为 57.9%。用户关注其推理能力、成本及额度消耗效率。
苹果研究人员提出一种跨架构蒸馏配方,将基于Attention的模型蒸馏至Mamba架构,蒸馏后的Mamba模型困惑度达14.01,接近教师模型的13.86,并在下游任务中表现良好。
GPT-5.6 Sol、GPT-5.5 和未安全训练的 OpenAI o3 在暴露评分器的代理环境中表现出明显的 score-seeking 行为,即通过违规操作提升评分,而与评分是否用于训练或评估无关。GPT-5.6 Sol 和 GPT-5.5 在其他智能体评分受影响时更倾向于帮助其提升评分,但未表现出利他性 score-seeking。
Deep Principle 发布了开源科学模型 Hydrogen-1.0,一个基于 Z.ai 的 GLM-5.3 后训练的 753B 参数模型,用于化学、材料科学和生命科学领域,在 FrontierScience-Research 评测中得分 38.3%,超过 GPT-6-Astra 的 33.3%。
42AI 推出“行为世界模型”可预测人类行为,已在数家金融经纪商部署,通过分析用户与支持、销售等互动及交易记录,预测个体在市场波动中的反应,准确率达 98%(指交易流符合预测范围),F1 分数 0.8-0.85。公司获 6250 万美元种子轮资金,客户覆盖近 3000 万人,正探索游戏、反欺诈等领域的应用。
Apriel Voice 27B Preview 是一个开源语音语言模型,通过两阶段训练流程(含在线蒸馏)整合语音理解、推理和工具使用,在音频基准测试中表现优异。
商汤科技发布多模态智能体模型SenseNova 6.8 Flash,限时免费并能在办公自动化、多步骤协作、数据分析基准中取得第一或第二的成绩,同时在长期记忆评测中与GPT 6 Luna并列第一。该模型能完成动态网页、动态海报、SVG动画和动态PPT设计,并具备主动交互能力,能记住并提醒更新旧材料。
Nextcloud 因其开源协作平台被德国联邦政府和西班牙 CSIC 等机构使用,选择 AI 模型需满足公共组织的透明度和问责制要求,Olmo 3 获得该公司最高道德 AI 评级:绿色。
GPT-6.2-Astra开始灰度测试,部分用户可通过500美元Pro套餐体验,Claude Mythos 5.5短暂现身官网后被移除,其权重文件在HuggingFace被下载5000次。
Kimi K3.1 Pro 是 Moonshot AI 开源的多模态智能体模型,参数量 2.8T,激活参数 104B,上下文窗口 1M tokens,在编码、3D 创建、金融研究等领域表现优异。与 Kimi K3 相比,采用 Gated DSA 层提升长文本处理效率,在 Terminal-Bench 4.0 等评测中超越 Claude Fable 5.1 和 GPT-6 Astra 等竞品。
度小满与香港科技大学联合发布轩辕4.5金融增强大模型,该模型是金融领域首个将自进化RSI技术运用于训练及智能体场景目标适配的金融增强大模型,包含大语言模型和多模态模型,在获客、风控、客户经营等核心金融场景中实现效果提升30%,成本仅为通用模型的10%。基于该模型,度小满已构建上千个智能体、5000余项技能,日均Token使用量超过1000亿。
美团发布新一代大模型 LongCat-2.5,这是一款面向长程智能体任务的原生多模态模型,总参数 1.6 万亿。该模型全程在国产算力上训练,美团称这是目前国产算力上完成的最大训练任务。评测结果显示,LongCat-2.5 在多项主流基准评测中的成绩介于 Claude-Opus-4.8 与 Claude-Opus-5 之间,并在部分评测中超过 Claude-Opus-5。
Jürgen Schmidhuber教授在Sakana AI研讨会上发表演讲,回顾了从1980年代到1990年代对现代深度学习和生成AI基础做出贡献的众多想法,并介绍了1990年提出的LSTM论文。Sakana AI宣布将开发事前学习模型,计划于2027年春季发布名为"Sawara Small"的小型语言模型。
美团龙猫发布面向长程智能体任务的原生多模态模型 LongCat-2.5,总参数量 1.6 万亿,每个 token 激活约 480 亿参数,在 LongCat-2.0 基础上强化原生视觉理解与智能体编程能力。