Hugging Face Blog5858
Hugging Face 发布 ToyBlocks:用于机器人学习与评估的受控世界框架
Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
Hugging Face Blog5858Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 TechCrunch · AI6565
Physicl 融资 1000 万美元,用数字世界让机器人更实用。其平台通过高保真 3D 环境模拟,帮助机器人开发者解决训练难题。推出的 Studio 产品包含 1 万个 3D 场景和 10 万个资产,用于生成合成数据训练机器人处理复杂任务。
TechCrunch · AI6565Underdog 发布仅 32MB 的语音模型 Woof,可在边缘设备运行,无需互联网连接;该模型含 3100 万参数,已开源。此前其发布的 Bark 为 167MB 语音转写模型,两者均旨在让用户掌控数据。
 Latent Space00
Inkling 2 Small 在 68 小时内完成 17A-594B 参数规模预训练,超越 Muse Spark;支持 12T token 上下文窗口,用户可通过 Claude UI 调整至 400K,但需注意 300k 超限可能引发工作流问题
 Hugging Face Daily Papers6565
SLA 模型通过持续预训练和后训练,将预训练的 VLA 策略与冻结的 3D 感知模型进行空间对齐,使用特征依赖门控和概率状态 dropout 提升跨不同机器人数据的空间理解能力,同时保留推理架构。
Hugging Face BlogHugging Face Open ASR 排行榜新增埃及英语和尼日利亚英语的 Liva AI 私有数据集,包含 1.34 小时和 1.55 小时的对话语音,用于提升 ASR 评估的代表性及可信度。排行榜现支持基于 Kachru 三圈模型的更细致口音分类,涵盖 US 与非 US、内圈与外圈/扩展圈等分组。
 ByteDance Seed · Hugging Face 新模型
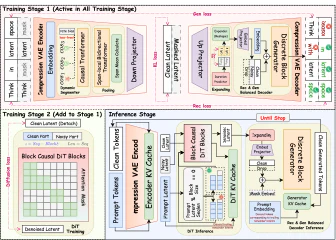
Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
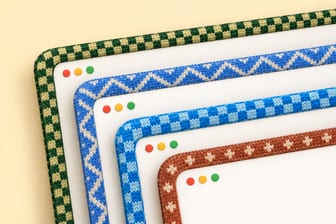
开发者发布 Mac 应用 Window Sweaters,为 37 款应用添加针织边框,颜色灵感源自应用图标,支持自定义样式和模式,可通过 Homebrew 或手动安装,需 macOS 13 或更高版本。
Hugging Face Daily Papers6565BestRand通过分析误差分布,证实随机采样在基准测试中具有高概率的强性能,但存在罕见的大误差导致不稳定。该方法在70多项文本、多模态和智能体基准测试中验证,相比竞争方法将高误差风险降低50.2%、平均估计误差减少16.4%,同时仅需51.3%的构建成本,并平均将OOD估计误差降低21.8%。
 IT之家 · AI
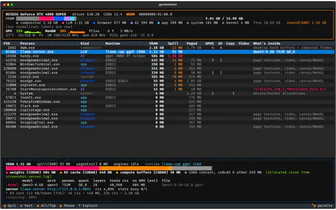
微软 GitHub 副总裁斯科特·汉塞尔曼开源 GPU 监控工具 gputaskman,按进程展示 GPU 使用率、显存占用、温度等数据,并识别 LLM 进程显示模型细节,支持 Windows、Linux、WSL 和 Apple Silicon Mac。
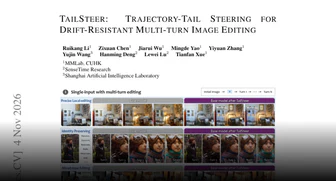
Hugging Face Daily Papers6565TailSteer 通过保持早期去噪动态接近基础模型并从策略内滚动学习轨迹尾部的精细偏差抑制校正,显著减少多轮编辑中的累积视觉漂移,同时保留预训练的生成和编辑能力。实验表明,TailSteer 在 FLUX、SenseNova 和 Qwen 系列模型上,能在 15-20 轮编辑中大幅降低漂移,且在大量文本到图像和单图像编辑基准测试上基本保持基础模型性能。
Hugging Face Daily Papers3535Harness-S 通过从兄弟 Harness 中学习,实现了通用智能体训练。该模型在 MMLU 评测中达到 82.5 分,比基线模型快 3.2 倍,上下文长度为 128k tokens,参数规模为 175B。模型已开源,可通过 API 调用。
IT之家 · AI5555webAI 推出 TwIL-8B 推理模型,基于 IBM Granite-4.2-8B 优化数学与代码任务,MATH-500 和 AIME 2025 测试成绩优于 Gemma 4 31B,LiveCodeBench 同组最佳,IFBench 与 Gemma 4 12B 持平。模型推理能力达前沿模型的 88~93%,降低 AI 使用成本但知识储备有限。
IT之家 · AI淘宝 MNN 团队开源 0.3B 手机模型 MNN-Pocket-0.3B,在 iPhone 18 Pro 真机离线跑出 350 token/s。模型峰值内存低于 300MB,解码吞吐超 200 token/s,INT4 部署文件 173MB,英文 IFEval 得分 73.20,中文指令遵循 IFEval-zh 得分 74.59。
 Codex releases00
GitHub Copilot rust-v0.169.0-alpha.1 发布,该版本提供代码审查、协作等功能。
IT之家 · AI同一件事 · 3 家Ricursive Intelligence 发布 Ripple-65B Preview 模型,宣称在美国开放权重模型中拥有最佳智能体编程表现。
 vLLM Blog
VeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
Hugging Face Daily Papers5252Open-HumanScale 是首个支持具身基础模型 egocentric pretraining 扩展至 50,000 小时的开源方案,其核心数据集 Open-HumanScale-50K 包含 50,000 小时密集标注的人手动作和自然语言 egocentric 视频数据。
 MarkTechPost同一件事 · 3 家6262
百度发布 ERNIE 5.5 Flash Base,一个 280B 参数稀疏 MoE 基础模型,每 token 激活 14B 参数,支持 128K 训练上下文和 1M 推理上下文。
 LangChain Deep Agents releases1515
LangChain Deep Agents 0.2.5 发布,修复了压缩输入预算与所选模型匹配、`ModelRefusalMiddleware` 抛出错误时保留截断回复处理、Windows 上延迟应用内 `uv` 安装等 Bug。
Codex releases00GitHub Copilot 0.168.0-alpha.7 发布,未公布具体更新内容。
LangChain Deep Agents releases3535LangChain Deep Agents v0.7.33 发布,默认在模型拒绝时报错并上报子智能体拒绝,添加异步子智能体通知元数据,记录子智能体检查点任务调用 ID。修复 Python `grep` 回退限制文件范围、长结果行裁剪、压缩失败报错等问题,并将 rubric 中间件正式化。
LangChain Deep Agents releases1515LangChain Deep Agents 0.7.34 发布修复了摘要截断处理问题,通过锚定消息 ID 解决了该问题。
Hugging Face Blog精选7171NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
Codex releases00GitHub Copilot 0.168.0-alpha.6 发布,未提及具体更新内容。
 O'Reilly Radar
在近期Foo Camp上,参与者认为软件开发的主要载体正从可执行代码转向自然语言提示、生成过程和开发者技能。有人将Python比作汇编语言,暗示自然语言生成可能使传统代码编写变得可选。
 Databricks Blog5858
Databricks 与 Linux Foundation 于 2026 年 6 月宣布 Delta Sharing 升级为 OpenSharing,将共享范围从 Delta Lake 表扩展至包含 Agent 技能。
 Mastra Blog
Mastra 平台和 Studio 现支持追踪每个智能体和模型调用的延迟指标,可通过 TTFC(首次数据块时间)和 TTFT(首次 token 时间)过滤排序追踪、跨度及线程,识别慢速环节。
 OpenClaw Blog
OpenClaw Multiplayer 允许多人共享同一智能体和上下文协作,无需重构对话或传递指令,已支持 50+ 人在同一环境中协作。
Codex releases00GitHub Copilot rust-v0.168.0-alpha.5 发布,该版本提供代码审查、协作等功能。
 Microsoft Research
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
 NVIDIA Newsroom
Chris Alexiuk 推广 NVIDIA Nemotron 开源多模态模型,支持从 Nemotron 3.5 Lightning 到 Nemotron Ultra 多种版本,帮助开发者构建 LLM 应用和智能体。他通过 YouTube 教学使 AI 易于理解和使用,强调完全开源对智能民主化的重要性。
 LangChain Blog5252
LangSmith Bring Your Own Cloud (BYOC) 现在支持 AWS (GA)、Azure (Beta) 和 Google Cloud (Beta),用户可将追踪、评估、数据集、提示词和智能体部署保留在自选云账户中,LangChain 负责数据层管理。
Databricks BlogNVIDIA 与 Databricks 联合为 Debezium 项目贡献的 Zerobus Ingest 消息接收器,通过直接将记录写入 Unity Catalog Delta 表。
 IBM Research Blog3636
ORNL、IBM 和 AMD 在 IBM 纽约波基普西园区部署量子纠错(QEC)协同设计平台,将 IBM Quantum Nighthawk r2 处理器与 ORNL Umbra HPC 系统整合,后者包含 AMD Instinct MI355X GPU 和 5th Gen AMD EPYC™ CPU,为混合 HPC-量子计算环境中的算法开发与验证提供低延迟量子-经典执行能力。
Hugging Face Daily PapersStreamDuo将一个可训练解说员与一个冻结的研究智能体配对,该研究智能体检索游戏维基条目,以在不针对目标游戏进行训练的情况下提高跨游戏直播解说。StreamDuo在 Baldur's Gate 3 上训练并在十个未见过的新游戏中测试,将实体召回率从 0.082 提高到 0.116,将源游戏泄露率从 9.9% 降低到 1.0%,并在直播模型中实现了最佳时机、最高的评判活力和总体质量。
Codex releases00GitHub Copilot rust-v0.168.0-alpha.4 发布,该版本包含最新功能改进和修复。
Hugging Face Blog精选7272Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
IT之家 · AI精选同一件事 · 3 家7474百度文心发布 ERNIE-5.5-Flash-Base 并开放 ERNIE 5.5 Flash 预训练终点权重,这是一个总参数 280B、每 token 激活 14B 的稀疏 MoE 语言模型,在 33.5T tokens 上从零预训练,微调与推理支持 1M tokens 上下文。
推荐理由: 原文给出 280B 稀疏 MoE 基座的参数、训练数据量与开源权重,读者可据此判断其作为微调起点的适配空间。
 量子位精选同一件事 · 3 家7272
百度于11月5日正式开源基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base),采用 MoE 架构,总参数量2800亿,每个 Token 激活140亿参数,预训练使用33.5万亿 Token,预训练上下文最高128K,微调与推理阶段支持最长100万 Token 上下文。