跳到正文
实时
10月27日周二
  1. Microsoft AI News67

    微软发布 MAI Image 2.7 图像编辑模型,Arena Edit 排第 3、Artificial Analysis 排第 2

    微软 AI 发布图像编辑模型 MAI Image 2.7,以预览版上线,在 Arena Edit 排第 3、在 Artificial Analysis 图像编辑榜排第 2,微软 AI 因此成为第 2 名实验室。

    推荐理由: 微软公布 MAI Image 2.7 在两个图像编辑榜单的排名,并给出相对上一代在 10 类用例上的提升幅度。

  2. Hugging Face Daily Papers65

    AV-FABLE:长视频音频视觉篡改取证基准

    AV-FABLE 引入一个用于长视频稀疏篡改的音频视觉基准,表明冻结的音频视觉大语言模型的感知特征包含最佳通过分离时间解码器而非语言输出恢复的取证证据。长视频中的局部 AI 篡改通常影响其他内容真实的短暂事件,使视频级分类不足以进行取证分析。

  3. IT之家 · AI

    苹果 iOS 27.2 系统为 AI 生成图片加入 SynthID 隐藏水印

    苹果 iOS 27.2 系统加入 SynthID 功能,为图乐园生成图像及部分智能编辑图片添加隐藏式水印。SynthID 是谷歌开发的 AI 内容识别技术,在像素层面嵌入水印标记 AI 图片,不影响图片质量且能抵御后期处理。用户需访问 SynthID Detector 网站,在“照片”App 中使用“扩展”和“重新构图”处理的图像均显示为 AI 生成。

  4. LangChain Deep Agents releases

    LangChain Deep Agents deepagents-code==0.2.2 发布:安全与性能改进

    LangChain Deep Agents 的 deepagents-code==0.2.2 版本发布,包含安全与性能改进。新增 GPT-6.1 Terra 支持、选中文本输入至聊天、插件更新检测等功能;修复项目 .env 文件设置信任值、终端 UI 链接限制、Git 选项限制等 Bug;通过重用父进程上下文、优化服务器启动流程、精简转录渲染等提升性能,推荐尽快升级。

  5. Apple Machine Learning Research

    GHARP:基于大规模重建先验的实时高斯头动画方法

    GHARP 方法通过少量输入图像和表情信号实时动画化 3D 人头,分为离线的身份阶段(构建几何与外观表示)和运行时的动画阶段(预测表情残差)。该方法在预训练重建模型的语义结构潜在空间中执行动画,使表情变化空间受限,实现高效残差预测,并在 Ava-256 基准上达到 SOTA 质量,A100 GPU 速度提升 13 倍、高斯数量减少 8 倍。

10月26日周一
  1. Simon Willison65

    缝纫切割器

    Simon Willison 开发了一个名为 Seam Cutter 的工具,可创建图像的水平或垂直切割线并滑动两侧,实现从图像中间裁剪部分区域。该工具旨在解决在用 Tailor 将多张截图拼接成长图时,需要裁剪中间特定部分(如删除无关提示词)的需求。

10月24日周六
  1. SemiAnalysis

    亚马逊 Trainium 攻占训练市场

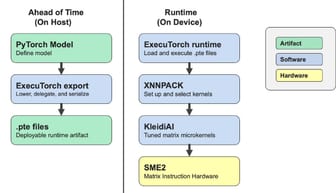
    亚马逊 Trainium 通过原生 PyTorch 训练体验的重大改进,显著提升其在训练领域的竞争力。Trainium3 支持标准 PyTorch API,无需 XLA 标记即可将大部分 PyTorch 代码迁移至 .to("neuron"),但 BF16 训练体验尚未完善。SemiAnalysis 工程团队测试显示其性能接近 CUDA 生态,但仍有改进空间。

  2. 量子位72

    模思智能与 OpenMOSS 开源 5B 生图模型 MOSS-Image,4 天海外下载超百万

    模思智能与 OpenMOSS 团队开源发布 5B 参数生图模型 MOSS-Image,上线 4 天在海外社区收获 130 万次下载,GitHub 获 1.4k Stars 并登顶 Hugging Face 文生图趋势榜。

    推荐理由: 文章给出模型参数规模、文字渲染与布局控制的具体评测数字,可据此判断开源生图模型在设计类任务上的位置。

10月23日周五
  1. The Decoder

    Canva 发布其首款自研图像模型 Canva Craft

    Canva 发布了其首款自研图像生成模型 Canva Craft,称其性能可与来自 Google、OpenAI、字节跳动和 Meta 的同类模型竞争。Canva Research 团队从零开始训练该模型,主要依赖数百万个设计模板而非照片,支持 55 种语言的文本渲染,可在 30 多种宽高比下生成高达 2K 分辨率的图像,并通过 Magic Layers 实现结果的可编辑分层。

    同一件事 · 3 家

    各家口径不同:TechCrunch 表示模型支持 30 种宽高比;The Verge 提及“超过 30”种宽高比;The Decoder 指定 30 多种宽高比。

  2. Hugging Face Daily Papers

    WeVisOne-VL:从对象到像素的统一视觉感知模型

    WeVisOne-VL 通过结构化 token 预测统一对象级和像素级视觉感知,支持检测、定位、计数、OCR、分割和 matting 等任务,采用轻量级像素解码器和多阶段训练,在 30 项以上基准测试中表现领先,并保持对不存在对象的稳健拒绝。

    同一件事 · 2 家

    各家口径不同:Hugging Face Daily Papers 表示使用轻量级像素解码器;MarkTechPost 提到 9.6M 参数解码器。

  3. 腾讯混元 · Hugging Face 新模型

    腾讯混元发布 WeVisOne-VL-2B 模型

    腾讯混元发布 WeVisOne-VL-2B 模型,基于 Qwen3-VL 构建,集成 9.5M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。

  4. 腾讯混元 · Hugging Face 新模型

    腾讯混元发布 WeVisOne-VL-4B 统一视觉语言模型

    腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。

  5. Hugging Face Daily Papers65

    Factor-Aware Predictive Learning 发布:用于电影级视频生成的多模态大语言模型表示利用方法

    因子感知预测学习 (FAPL) 使视频扩散 Transformer 能够利用多模态大语言模型 (MLLM) 表示进行稀疏时间推理和电影级控制,通过分阶段接地和优化实现。FAPL 在三个电影级视频生成任务(稀疏到视频、因子感知编辑和多镜头生成)上始终优于基线,验证了其在 MLLM 特征使用、时间控制和因子协调方面的贡献。

  6. IT之家 · AI70

    Wccftech报道《血源诅咒》非官方PC移植版在RTX 4070显卡上实现1080p突破220 FPS

    Super Medo 制作的《血源诅咒》非官方 PC 移植版在 RTX 4070 显卡上通过支持 NVIDIA DLSS 帧生成技术,实现 1080p 分辨率下稳定突破 220 FPS,性能约为原版主机的 7 倍以上;原生 4K 分辨率启用 DLAA 后平均帧率约 40 FPS,开启 DLSS 3 帧生成后质量模式超 100 FPS,性能模式约 130 FPS。

  7. 36氪 · AI65

    前OPPO老兵创业公司APOM推出AI旅行墨镜L'Atitude 52°N众筹超40万美元

    深圳艾普梦光学科技(APOM)旗下智能眼镜品牌L'Atitude 52°N面向旅行和户外场景推出AI智能墨镜,众筹累计金额近40万美元,首款眼镜标价$399起,预计2026年备货量约2万副。产品核心体验集中于第一视角影像、实时翻译和AI导览,搭载1200万像素摄像头模组和专用AI影像芯片。