The Decoder5858
斯坦福研究发现44%的LLM说法已过期
斯坦福研究人员测试了50条关于LLM的广泛说法,发现44%已经过期,平均寿命仅为15.7个月,其中推理能力相关说法(如计数、算术、长上下文信息丢失)全部失效,而奉承、欺骗和策略行为相关的说法则持续存在或增强。
The Decoder5858斯坦福研究人员测试了50条关于LLM的广泛说法,发现44%已经过期,平均寿命仅为15.7个月,其中推理能力相关说法(如计数、算术、长上下文信息丢失)全部失效,而奉承、欺骗和策略行为相关的说法则持续存在或增强。
 IT之家 · AI4242
英伟达称 AI 正推动半导体晶圆厂进入“AI 定义工厂”阶段,加速仿真技术将工程仿真从数小时、数天压缩至数分钟,应用材料公司 Ginestra 平台形貌仿真加速最高达 35 倍,工程师决策时间从数天缩至数分钟。
 Hugging Face Blog5050
StateBench 是一个长上下文状态追踪基准,测试语言模型如何保持追踪长文档中实体信息的变化。该基准包含四个难度等级,从简单的不可变赋值到复杂的依赖赋值,发现循环和混合模型比 Transformer 在直接训练任务上泛化能力更强,但前沿模型如 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 在长输入的复杂状态追踪中仍会失效。
 AWS Machine Learning Blog3232
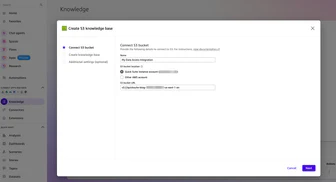
Amazon Quick 通过连接 Amazon S3 和创建知识库整合结构化与非结构化数据,用户可使用单一对话式 AI 代理查询。该解决方案包含数据层(存储在 S3 的非结构化内容和作为语义数据集的结构化数据)、工作空间层(将数据类型整合到单一工作空间)和代理层(自定义聊天代理链接到工作空间并返回组合响应)。
Astra 在 17K-172K 权重网络实验中直接读取权重,但其在 800M 权重 Qwen3.5 数学能力提升实验中需结合 Python 编程和模型运行,并非仅通过读取权重实现;Astra 修改 0.016% 权重将 Qwen3.5-0.8B 的 MATH-500 从 7.9% 提升至 48.1%,并使 IFEval 提升 3 倍。
 Hugging Face Daily Papers6565
SWE-Trail 通过利用过去的执行轨迹指导后续探索,但不向编码智能体暴露历史信息,从而提升了编码智能体训练的轨迹收集效果。该方法在 SWE-bench Multilingual 和 SWE-bench Pro 上,使用 124B 参数的学生模型,分别使平均问题解决率提升了 2.33 和 1.60 个百分点。
 PyTorch Blog
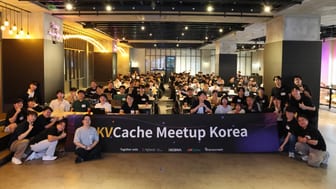
PyTorchKR 与 XCENA 于 2026 年 9 月 30 日联合举办 KVCache Meetup Korea,XCENA、SK hynix、FuriosaAI 和 LMCache 的演讲者分享了 LLM 推理及 KV 缓存优化的成果。
Hugging Face Daily PapersReTrace框架通过目标导向行动回放和受控错误注入的形式化过渡一致性恢复标准,首次系统性地研究了计算机使用智能体的自主模型恢复行为,发现理想恢复能解锁模型潜在任务完成能力,当前智能体未充分利用其潜在恢复能力,且准确模型恢复可带来可衡量的端到端增益,证明恢复是构建可靠计算机使用智能体的基本能力。
Hugging Face Daily Papers6060NorthCUA 通过经验飞轮、递归自改进、分阶段学习和强化学习来规模化计算机使用智能体,在 GUI 和网页交互方面取得开源模型顶尖结果。
 Ai2 Blog
StateBench 是一个用于测试大语言模型追踪长文档中实体状态变化的基准,包含 R-trivial、非周期、可解和一般有限四个难度等级。研究发现,循环和混合模型在直接训练这些任务时泛化能力远超 Transformer,而 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 等前沿模型在输入变长时仍难以处理更复杂的状态追踪问题。
Hugging Face Daily PapersCUA-Master 使用嵌套递归循环结合开放世界数据和反馈驱动重试机制,持续改进跨多种基准的计算机使用智能体。
IT之家 · AI精选8383美满电子(Marvell)11 月 2 日宣布以约 1150 亿美元全股票交易收购光通信企业 Lumentum,隐含企业价值约每股 1132 美元,较 10 月 28 日股价溢价约 23.9%。
推荐理由: 这笔交易把光互连和激光器产能纳入同一家公司,读者可据此理解AI数据中心连接层的竞争格局变化。
 量子位精选同一件事 · 3 家8080
MIT的实验让GPT-6 Astra直接读取并编辑Qwen3.5-0.8B的权重,仅改动0.016%的参数、不做训练和梯度下降,MATH-500得分从7.9%升到48.1%,指令执行能力也提高3倍。
推荐理由: MIT 实验显示前沿模型可直接读写小模型权重,为免梯度训练的性能修复提供了一条可复现路径。
 MarkTechPost
Zyphra AI 发布了 Zyphra 层次注意力 (ZHA),一种基于树状索引器的稀疏注意力方法,旨在解决稀疏注意力中索引器仍需扫描整个上下文的已知问题。ZHA 可蒸馏到约 4B token 的冻结预训练模型中,在 Qwen3.6-35B-A3B 上,其推理、智能编码和 256K 检索基准测试中接近密集注意力。
IT之家 · AI精选同一件事 · 3 家7575MIT CSAIL 研究人员提出「权重空间编程」,让 GPT-6 Astra 直接读取并修改 Qwen3.5-0.8B 的神经网络权重,仅调整约 0.016%(131072 个)参数,就把 MATH-500 成绩从 7.9% 提升至 48.1%,GSM8K 从 13.8% 提升至 67.1%,IFEval 从 21.0% 提升至 62.3%。
Hugging Face Daily PapersSimpleLoRIF通过梯度对齐识别并过滤会无声侵蚀LLM安全的指令数据,生成的SafeTulu数据集将对抗性成功率降低了22%,同时保留了模型能力。
 Databricks Blog
Lakebase Postgres 在 Google Cloud 上正式发布,支持无服务器 Postgres 运行于 Databricks 数据与 AI 平台。
研究团队提出 Weight-Space Programming,发现 GPT-6 Astra 可直接读写神经网络权重:仅凭 17,253 个权重就能判断网络训练的是哪款游戏,并在无梯度、无训练的情况下从零写出击败 PPO 训练 1 亿步的小型游戏网络。
MarkTechPost6767Deep Principle 发布了开源科学模型 Hydrogen-1.0,一个基于 Z.ai 的 GLM-5.3 后训练的 753B 参数模型,用于化学、材料科学和生命科学领域,在 FrontierScience-Research 评测中得分 38.3%,超过 GPT-6-Astra 的 33.3%。
PyTorch Blog3434Ray 宣布加速器特殊兴趣小组(SIG),旨在联合硬件厂商、Ray 贡献者和应用开发者,制定中立的加速器支持路线图。初期聚焦开发测试基础设施、硬件感知能力和网络传输,优先支持共享硬件访问、可复现的开发测试环境及更广泛的 CI 覆盖。
 O'Reilly Radar6565
在《周一早上的特工》节目中,AI分析师被要求定义美式橄榄球战术“Tush Push”,团队通过共享数据字典确定了“四分卫跑动进攻且码数少于等于一码”的定义。
MarkTechPost6060NVIDIA 发布 Auto Ontology,一个基于企业元数据的语义层框架,让 AI 智能体通过认证业务定义编写 SQL。默认 LLM 为 nvidia/nemotron-3-nano-30b-a3b,支持 Docker Compose 或 Kubernetes 部署,性能测试显示本体创建时间减少 90%,但未公布文本到 SQL 准确率。
IT之家 · AI6565阿里云发布 AI 投研工作台 Qovest,用户可一句话提出研究需求,让系统自动查数据、分析并生成报告。Qovest 拥有权威金融数据库和自研 Agent 工程框架,支持可交互的深度研究结果,已对个人用户开放邀测,提供免费试用和每月 99 元或 199 元订阅套餐。
IT之家 · AI5858阿里云 Memory 服务升级,通过提取对话关键信息保存为用户画像,增强 Personal Agent 对用户偏好、计划和历史约定的记忆能力。
 36氪 · AI同新闻7272
美团发布新一代大模型 LongCat-2.5,这是一款面向长程智能体任务的原生多模态模型,总参数 1.6 万亿。该模型全程在国产算力上训练,美团称这是目前国产算力上完成的最大训练任务。评测结果显示,LongCat-2.5 在多项主流基准评测中的成绩介于 Claude-Opus-4.8 与 Claude-Opus-5 之间,并在部分评测中超过 Claude-Opus-5。
量子位5858Jev 与 Treg 开源找人工具,价格低至 0.0089 美元(约 6 分钱)找一条线索,比 Clay 便宜 85%,获 6400 Star。Treg 在 People Search Bench 评测中表现优异,B2B 拓客任务正确率达 78.2%。该工具通过 Agent 调用 Treg 接入的数据工具,实现找人、查邮箱、验证等流程自动化。
Databricks Blog5858Databricks Lakebase 通过其基于复制-on-write 的数据库分支功能,将每个 PR 分支的创建时间缩短至秒级,支持峰值约 100 个并发分支,每分支独立读写,兼容标准 Postgres 并支持大型 JSONB/LOB 列,满足 Snorkel AI 在 CI/CD 流程中快速、安全、低成本地测试生产数据的需求。
IT之家 · AI精选7272据彭博社报道,Alphabet、Meta、微软、亚马逊和甲骨文承诺未来数年在数据中心等领域投入超过 3 万亿美元,其中租赁付款承诺合计 1.3 万亿美元、其他采购承诺合计 1.9 万亿美元。
推荐理由: 五家巨头的合同承诺规模与口径差异被一并列出,可看清 AI 数据中心投资的资金结构与回收压力。
IT之家 · AI精选7272据日经亚洲报道,受 AI 投资热潮推高存储芯片需求影响,铠侠、三星、SK 海力士、美光、闪迪五家存储芯片厂商上季度营业利润合计达 32 万亿日元,是上年同期的 10 倍,首次超过 Alphabet、微软、亚马逊、Meta 和苹果五家科技公司合计的约 25 万亿日元。
推荐理由: AI 投资推高存储芯片需求,五家存储厂商利润总额超过美国五大科技公司,读者可据此观察算力产业链的利润转移。
The Decoder同一件事 · 2 家6262由 Google Deepmind 和世界资源研究所开发的 ForTy AI 地图,以 10 米分辨率区分全球原始森林、木材种植园和树作物农场。该地图为 2020 年全球土地分配至六类,是首个此类全球地图,主要支持欧盟无森林砍伐产品法规(EUDR)的供应链风险评估,准确率达 90.2%,但树作物和种植园分类准确率仅约 50-60%。
各家口径不同:谷歌 DeepMind 表示地图将土地分为六种类型;The Decoder 提到只有四种类型(原始森林、木材种植园和树作物农场)。
量子位5858新芯航途发布 X7 Ultra 芯片,首次用“大模型算力”描述性能,NPU 算力达 700TOPS 且利用率 98.7%,量化模型输出与 FP32 基准模型相似度超 99.99%,内存带宽消耗降低 80%,能效提升 100%。该芯片专为量产智驾大模型设计,采用超大核 NPU 架构和专用计算引擎,配合 AI 工具链优化,支持千线级激光雷达处理和摄像头时延抖动优化,搭载 Arm v9 车规级 CPU,ASIL-B/ASIL-D 安全标准。
IT之家 · AI6565微软发布 Windows App SDK 2.6.4 完善 Win11 原生应用框架 WinUI 体验,规避“网页套壳”应用的内存占用问题,提升应用稳定性和兼容性,并增强 AI 功能。该版本简化 Language Model API 访问,升级 ONNX Runtime 至 1.27.1,修复文本控件关闭崩溃,并包含覆盖 WinUI 3、应用生命周期等可靠性及诊断改进。
 OpenRouter Blog4242
OpenRouter上开源权重模型在9月底已占顶尖50%模型token的72%,较2025年10月提升455%;闭源模型虽使用量也增长近10倍,但开源模型每百万token输入成本仅闭源的约四分之一;因竞争激烈,开源模型如DeepSeek V4.1 Flash、GLM-5.3 Flash等价格更低,但顶尖闭源模型Claude Opus 5.5在AI分析智能指数上仍领先11分。
 Baseten Labs6565
Base Labs研究发现价值函数在强化学习中的计算效率通常不值得,因为它产生的梯度噪声减少量往往小于训练成本。在单轮任务中,完美价值函数最多能消除40-60%的优势方差。唯一可能受益的情况是使用小型价值头,但收益可能微乎其微。PPO批评家与GRPO在相同步数下表现相当或更差,而一些研究通过在组上添加批评家或使用组相对奖励机制实现了对GRPO的改进。
 Epoch AI6565
Epoch AI 通过 GPT-5.6 Sol 分析 2020 年 1 月至 2026 年 9 月 bioRxiv 上 4.7 万篇预印本发现,其中 15.5% 承认使用 LLM,与承认使用专业 AI 工具的比例(15.7%)几乎相同;OpenAI Decisions API 基于 GPT-6 Luna 将 LLM 使用分为研究、代码计算、写作和文献综述四大类。
 Ars Technica · AI3838
富士胶片宣布投资约100亿日元(约6300万美元),将磁带生产产能提升5倍,主要生产最新一代“富士胶片LTO Ultrium10”磁带。该投资源于生成式AI带来的全球数据需求“指数级增长”,并将使富士胶片在2025财年的产能基础上实现这一增长。主要云服务及数据中心运营商因磁带备份成本低、可离线存储等优点,正扩大磁带使用规模,将其视为防范勒索软件等网络攻击的最后防线。
 Factory News3434
Factory 收购 Typedef 公司,将为企业软件工程提供更深入的数据上下文能力。Typedef 通过从代码构建上下文层,使数据模型变更对定义、管道和仪表板的影响关系可视化,帮助工程师规划迁移、调试管道和重构模型。结合 Factory 的环境管理系统,双方将共同为工程师提供更清晰的血缘关系和证据支持,推动自主软件工程发展。
Hugging Face Daily Papers6060Youtu-Parsing-Omni 将文档、图像、音频和视频编码为时空结构化记录,通过自进化策略蒸馏实现最优解析效果。单模态编码器共享权重并融合跨模态信息,单架构统一十种解析任务输出,5B参数版本在 OmniDocBench v1.6 和 OmniParsingBench 上取得 96.96 和 75.08 的顶尖成绩,代码和权重开源。
 Microsoft Research4040
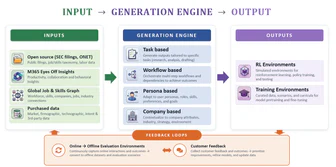
Microsoft Research 开源了产业评估数据生成平台,通过基于 O*NET 职业数据、在线招聘和 SEC 文件的合成企业环境,模拟真实业务流程测试 Copilot AI,确保评估不接触客户数据且符合安全隐私标准。该平台包含自动化查询生成管道和结构化质量框架,支持制药、资本市场和 IT 软件等行业的真实场景测试。
MarkTechPost5959Samaya AI 发布 Sterling 模型,基于 30B 混合专家模型 Nemotron 3.5 Lightning 微调而成,拥有 3B 活跃参数。在 FrontierFinance 基准测试中,Sterling 得分 58.9%,高于 Claude Fable 5.1 的 55.9%,且每问题成本仅为 $0.61(Fable 5.1 为 $6.89)。