Hugging Face Blog精选6262
PyTorch 2.15 为 MPS 后端带来 FP8 与更快的 LLM 解码
Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
 Google Developers Blog
Coral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。
 Mastra Blog
Mastra 发布 Mastra Launch 服务,为已使用 Mastra 框架但尚未将智能体投入生产的团队提供企业级访问权限和 90 天内完成部署的专属支持。该服务包括 Mastra 企业平台的全功能使用权限,以及 Mastra 工程师每周的现场协作支持,旨在帮助团队在 90 天内完成生产部署,否则仅需支付实施费用。
Google Developers BlogArm 利用 Google AI Edge Model Explorer 的分层图可视化和插件架构,开发了支持 TOSA、VGF 和 PTE 等格式的开源适配器,帮助开发者更便捷地检查边缘模型转换流程。
 Browser Use
Browser Harness 在匹配评估中,使用 2.1M 中位数输入 token 得到与 Playwright MCP 和 Chrome DevTools MCP 相同的 60.4 分,成为每任务成本最低的浏览器控制工具,每任务成本为 0.042 美元。Playwright MCP 和 Chrome DevTools MCP 的速度更快,但 token 使用量更高。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 Claude · YouTube
Claude 推出 Claude Dashboards 和 Claude Motion,前者在所有付费计划中支持将数据平台或 CRM 数据实时转化为仪表盘,后者在 Team 和 Enterprise 计划中支持将报告或图表生成动画解释视频,两者均以代码形式生成无需视频模型,可修改内容后导出 MP4 或编辑。
 Transformers releases3535
Transformers 发布 v5.20.2 补丁更新,修复了 generate 函数中输入类型丢失的问题,该问题影响多模态模型;同时解决了其他若干问题,包括输入字典类型转换、bfloat16 专家并行梯度为零、仅报告文本的 VLM 输入模态声明以及 eager_mask 中的主机到设备复制。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
 Modal Blog7575
NVIDIA 将首个 Vera CPU 服务器交付给 Modal,该 Arm 兼容 CPU 通过模拟能力测试使模拟能力沙盒吞吐量提升 2 倍,适用于资源使用峰值可达 10 倍基线的异构工作负载,有助于降低成本并加速强化学习部署。
 SGLang releases
SGLang v0.5.22 发布,新增 Model Type Cookbook、Clef、Clef Flash、PPLX-Decider v1/v1.1、EmbeddingGemma 2。
 Prime Intellect Blog
prime-rl v0.10.0 发布,默认采用新 RL 算法 IPO 提升异步 RL 稳定性并优化性能,支持 Qwen3.8 Flash 等新模型,通过 MoE 优化和自定义内核将训练吞吐量提升 1.15 倍(基于 torchtitan 平台)。
 Inception Labs Blog
Mercury 2在标准NVIDIA GPU上每秒解码超过1000个token,比Gemini 3.1 Flash Lite在查询规划阶段快近2倍、比Claude Haiku 4.5快4.7倍、比GPT-5 Mini快10倍,每个查询步骤都快于其他模型,使其能在现有延迟预算内完成搜索流程的每一步。
Inception Labs BlogMercury 在 Azure AI Foundry 上架,为开发者提供首个商业化规模的扩散大语言模型(dLLM),其基于扩散架构的并行生成能力使推理速度比同类自回归模型快 10 倍。
Google Developers BlogLiteRT Tensor API 发布,支持开发者以 C++ 在边缘设备原生编写和优化模型,实现跨平台(CPU/GPU/NPU)部署,无需转换脚本。开发者可完全控制计算图结构并直接加载模型权重,通过共享加速器缓冲区实现零拷贝数据流转,同时为 AI 编码智能体提供构建模块。
Inception Labs BlogTIME 将 Mercury 2 列为 2026 年最佳发明,它是首个采用扩散式架构进行推理的大语言模型,每秒生成超过 1000 个 token,速度比主流优化型 LLM 快 5 倍,并显著降低计算与能耗成本。
Inception Labs BlogInception Labs推出Mercury 2,免费token数量从10M增至100M,新Inception API key包含100M免费token,免费套餐请求频率提升10倍。Mercury 2在实时语音、搜索、AI编码子智能体和多智能体工作流中表现更佳,首token响应时间缩短,端到端延迟降低,工具调用更可靠。
Inception Labs BlogMercury Edit 2 是 Inception Labs 推出的全新扩散模型(dLLM),用于预测代码编辑中的下一步操作,其接受率比前代模型提升 48%,编辑选择更精准(提升 27%)。
Hugging Face BlogTorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
Inception Labs BlogInception Labs 推出 Mercury Voice 扩散大语言模型,专为语音智能体设计,推理、调用工具并遵循长系统提示,首答延迟低于 320 毫秒,在代理和语音基准上击败 GPT-6 Luna 和 Gemma 4 31B。
 Amp News6565
在 Linear 中将问题分配给 Amp 会启动新的 Agent Session 并生成新的 orb,也可以通过 @Amp 启动会话。Amp 会将其回复发送回同一会话并回复中途收到的消息。Agent Session 也会出现在 Amp 侧边栏中并可完全查看。安装 Amp agent 到 Linear 工作区并连接 Amp 账户到 Linear MCP 即可开始使用。
 Together AI Blog
Together AI 推出 Post-Training 服务,支持通过强化学习和监督微调构建定制模型,无需复杂基础设施。该服务提供灵活的训练循环定义能力,并优化底层系统与基础设施以提升模型质量与训练速度。支持 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B 等主流开源模型,运行在专属 GPU 资源上,确保高效且数值一致的训练。
Inception Labs Blog7575SearchBlox SearchAI 现在集成了 Inception 的 Mercury dLLM,为企业级工作负载提供亚秒级 GenAI 响应。该合作使 SearchBlox 客户在电商、客服、知识管理等场景中,以 60-90% 的推理成本降低和可扩展的速度获得实时搜索。
Inception Labs BlogMercury 2 在 Azure AI Foundry 上发布,这是世界上速度最快的推理语言模型,专为让生产 AI 感觉即时而构建。该模型结合了 Inception 的突破性扩散架构和 Azure 的企业级基础设施,为开发者提供兼具卓越速度和质量的模型。
 vLLM releases
vLLM v0.32.0 发布,包含 814 次提交、363 位贡献者贡献,新增 POST /v1/systemone 端点支持结构化状态问答,新 hf 工具与推理解析器支持通用模板,全平台低精度 KV 缓存优化,Model Runner V2 成为 ROCm 默认,启动与服务性能提升 43-85%
 NVIDIA Blog
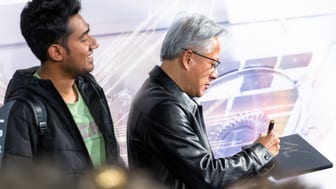
NVIDIA RTX Spark 笔记本电脑开始发售,配备 Blackwell RTX 显卡、最高 128GB 联合内存和完整的 NVIDIA AI 平台,起售价 2399 美元,由华硕、戴尔、惠普、联想、微软和微星推出,为便携设备带来强大的本地 AI、内容创作和游戏能力。NVIDIA 在全球举办发布会庆祝,包括柏林活动,创始人黄仁勋惊喜现身。
 Latent Space
 推出新节目《高品味测试者》,以旧金山典型午餐对话形式讨论 Dev Day、最新模型和助手等话题。
Browser Use浏览器 MCP 服务器分为三种:本地控制、云端执行和任务代理,需根据需求选择。推荐本地控制使用 Browser Harness,云端执行使用 Browser Harness CLI 或 Kernel,任务代理使用 Browser Use Cloud。Browser Harness 直接与 Chrome 通信,无 Playwright 和扩展,但需注意安全和性能问题。
 LangChain Deep Agents releases1717
LangChain Deep Agents 发布 0.1.86 版本,新增 NVIDIA OpenShell 作为沙盒提供者,修复了多个 Bug,包括改进别名匹配、准确报告工作区拒绝、替换重复线程恢复错误、在调回提示时替换聊天输入、在页脚显示过期提示缓存、在 Groq 工具限制时提供可操作错误、比较有效解释器权限等。
LangChain Deep Agents releases1010LangChain Deep Agents 0.7.28 发布,修复了 `ContextHubBackend.glob` 方法未正确处理 `path` 参数的 Bug。
LangChain Deep Agents releases3535LangChain Deep Agents 0.7.27 发布,修复了将子智能体名称传递给子智能体的 Bug,并新增了向主智能体异步报告子智能体状态更新的功能。
 OpenAI News
Itaú 通过 ia.i 对话界面和 IARA 管治平台,将其 AI 首先战略应用于客户和员工,这是巴西监管最严格的行业之一。
 O'Reilly Radar6565
OpenAI的ChatGPT新增Intelligent UI功能,可生成视觉解释和交互工具;Anthropic的Claude Dashboards支持公司数据的自然语言查询和可视化;Mistral发布万亿参数的Large 4模型用于编码、智能体和多模态任务。
OpenAI NewsLocaliza 使用 ChatGPT Enterprise、OpenAI API、Codex 和 60 多个专业智能体重组工作流程,构建 AI 原生移动体验。
 Ollama Blog
Reflection 的首个开源权重模型 Beam 已于今晨全面推出,Ollama 作为首发合作伙伴限时免费提供该模型,其 Beam 端点支持完全零数据保留(ZDR)。
OpenAI News4545Stack Overflow for Agents 通过 ChatGPT 插件实现智能体创建量增长 10 倍,由工程师使用 Codex 在数周内开发完成。
 Cursor Changelog
Cursor 云智能体现可构建交互式 Canvases 并通过链接分享,Environments API 已进入 Beta 版本支持程序化创建和管理智能体运行环境,大环境支持高达 300 个仓库且加载速度提升 5 倍。
 Comfy Blog7575
Krea 3 在 ComfyUI 中通过 Partner Nodes 正式可用,该模型专为基于参考的图像生成与编辑设计,支持通过描述变更和固定元素进行迭代,目标是在保持图像质量的同时加快速度并降低成本,允许将多次编辑包含在单次会话中。
LangChain Deep Agents releases3535LangChain Deep Agents v0.7.26 发布,异步子智能体现可报告等待人类交互状态,并在父智能体的追踪中显示其运行记录,同时修复了工具结果路径丢失问题。
OpenAI News3838GPT-Rosalind 学术计划推出,为符合条件的学术实验室提供赞助访问权限及工具,以推动生命科学研究。