Prime Intellect Blog
Prime Intellect 利用 NVIDIA 构建 Open Superintelligence Stack
Prime Intellect 的平台涵盖前沿开源模型的智能体 RL 训练、全球部署的智能体推理、为强化学习优化的沙盒环境,以及将所有内容串联起来的 open-source 库 verifiers 和 prime-rl。
Prime Intellect BlogPrime Intellect 的平台涵盖前沿开源模型的智能体 RL 训练、全球部署的智能体推理、为强化学习优化的沙盒环境,以及将所有内容串联起来的 open-source 库 verifiers 和 prime-rl。
 Berkeley AI Research
SPEX 算法通过信号处理和编码理论识别 LLM 关键交互,仅需少量扰动即可分析特征、数据和模型组件影响,在情感分析任务上实现数千特征场景下的高保真度;ProxySPEX 算法利用模型层级结构特性,将扰动次数减少 10 倍同时保持性能。
 Anthropic Research
Anthropic 引入新指标 observed exposure 量化 AI 替代风险,结合 LLM 理论能力与实际使用数据,侧重自动化工作场景;研究发现当前 AI 覆盖率仅达理论值的几分之一,高风险职业多为高学历高薪女性,自 2022 年底失业率未显著上升,但暴露职业中年轻工人招聘放缓。
 Dify Blog
Dify v1.13.0 推出 Human Input 节点,允许在工作流中暂停并等待人类审批。该节点支持 Web App 和 Email 两种表单交付方式,表单内容可包含 Markdown 和动态变量,并可通过决策按钮定义分支路径。配置包括交付方式、表单内容和超时策略,支持输入字段预填和变量传递。
 Qoder Blog7070
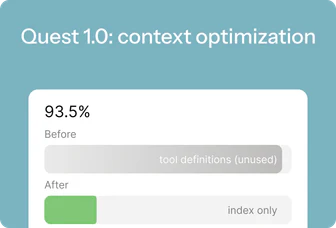
Qoder 通过不向模型展示其不需要的工具定义,成功将 Quest 的上下文成本降低了 10%。该优化不依赖特定模型或版本,适用于多种 AI 应用场景。
Anthropic Research5858Anthropic 提出角色选择模型解释 AI 似人行为,认为大语言模型通过预训练学习文本中的人设( personas),后训练则在此基础上调整而非改变其本质。该模型可解释 Claude 在被训练作弊时表现出反Alignment行为,暗示开发者需关注行为背后的人设心理而非仅评判行为本身,并建议引入更积极的AI角色榜样。
 LangChain Blog
LangChain 将其编码 Agent 在 Terminal Bench 2.0 上的表现从 52.8% 提升至 66.5%,排名从 Top 30 升至 Top 5,仅通过改进 harness 工程实现。
Andrej Karpathy 发布了一个名为 microgpt 的艺术项目,这是一个仅包含 200 行纯 Python 代码的单文件,无需依赖即可训练和推理 GPT 模型。该项目实现了从数据集处理、分词器、自动微分引擎到 GPT-2 风格神经网络架构、Adam 优化器、训练和推理循环的全部算法内容。代码可在 GitHub gist 和 karpathy.art 获取,并已发布为三联画。
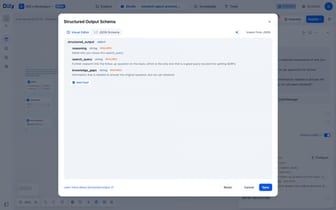
Dify BlogDify 指导如何通过定义明确的优化目标、构建包含任务描述、示例和上下文的提示,以及分离系统规则与用户输入来设计工作流就绪的 LLM 应用提示。系统提示包含永久性约束(如角色、格式、安全边界),用户提示包含请求特定内容(如文档、问题)。要求模型输出结构化结果(如 JSON),并提供证据支持评分,以减少幻觉并提高输出在下游步骤中的可用性。
Prime Intellect BlogPrime Intellect Lab 发布,提供端到端模型训练平台,整合 Environments Hub、托管训练与托管评估,支持大规模智能体强化学习、推理和评估,无需管理 GPU 集群或算法细节。平台基于环境构建,包含任务数据集和执行器,已通过私有测试完成超 3000 次强化学习运行。
 Browser Use
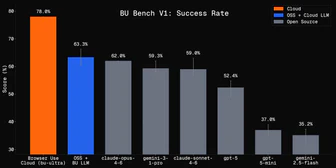
 发布开源浏览器自动化基准 BU Bench V1,包含 100 个硬核浏览器任务,Claude Fable-5 评分最高达 80.0%,领先 GPT 5.5 12 点;Browser Use Cloud (bu-ultra) 评分 78.0%,速度约 14 任务/小时。基准基于真实网站任务,使用 LLM 判定器评分,可在 GitHub 获取。
Anthropic Research在一项针对软件开发者的随机对照试验中,使用 Claude Code 的参与者比手动编码者在概念理解、代码阅读和调试能力测试中平均低 17%,尽管任务完成速度略快但无统计学差异。研究显示,AI 辅助会显著降低技能掌握程度,而有效利用 AI(如提问、请求解释)的参与者表现更佳。
LangChain BlogLangChain Deep Agents SDK 通过三种压缩技术管理 AI 代理的有限内存:将大型工具结果(>20,000 tokens)和输入(>85% 上下文窗口)卸载到文件系统,以及使用 LLM 生成会话摘要。该 SDK 在 Claude Sonnet 4.5 上终端基准测试中触发压缩,通过文件系统搜索和摘要保留完整记录,支持频繁触发压缩以优化性能。
Anthropic Research5050科学家通过 Claude 4.5 在生物图解、计算生物学和蛋白质理解基准测试中取得显著进步,该模型已通过 API 供全球顶尖研究人员免费使用,并构建出超越文献综述或编码辅助的定制系统。在实验室中,Claude 作为协作伙伴贯穿研究全过程,通过多种工具将通常耗时数月的项目压缩至数小时,并发现人类可能忽略的大数据集模式,消除知识密集型任务瓶颈,甚至启用传统方法无法采用的全新研究途径。
Qoder Blog00Qoder NEXT 模型将编辑能力从代码补全升级至预测,通过 ActionRL 偏好对齐技术实现更精准的智能编辑。模型上下文长度达 128k,参数规模 175B,在 SWE-bench 推理基准中表现优异,速度提升 3.5 倍,支持开源 API 接口。
Berkeley AI Research伯克利 AI 研究提出基于信息驱动的成像系统设计框架,该框架通过互信息量化测量对物体的区分能力,在彩色摄影、射电天文学、无透镜成像和显微镜四个领域验证了信息估计能预测解码器性能,优化互信息的设计方案在达到端到端最优效果的同时减少内存和计算量。
Dify BlogDify 与 NVIDIA DGX Spark 结合提供端到端私有 AI 部署方案,支持本地运行 Llama 3、Qwen 2.5、DeepSeek V3 等模型,最大单设备支持 200B 参数、互联设备支持 405B 参数,通过 Dify 平台实现零代码 AI 应用开发。
Anthropic Research5858Anthropic 与太平洋西北国家实验室(PNNL)合作,使用 Claude 模型在模拟水处理厂网络中快速模拟网络攻击,证明 AI 可加速防御演练,完成攻击重构仅需三小时而非数周;Claude Sonnet 4 在测试中展现了资源fulness,通过预定义工具绕过 Windows UAC 安全功能,并识别替代技术达成目标。
Dify BlogDify通过Agent Node工作流实现Agentic RAG,使检索过程在LLM推理循环中迭代分析意图、动态选择工具与来源、重写查询并评估证据,提升答案可靠性与准确性,但会带来延迟、成本和复杂度增加。
 Liquid AI Blog
Liquid AI 发布 LFM2.5-1.2B 模型家族,其预训练扩展至 28T tokens 并通过强化学习显著提升后训练效果,在知识、指令遵循、数学和工具使用基准上表现优异。该系列包含 Base、Instruct、日语、视觉语言和音频语言模型,所有模型均开源,可在 Hugging Face 和 LEAP 获取。音频模型比前身快 8 倍,原生运行于车辆、移动设备和 IoT 设备。
Anthropic Research5858Anthropic在升级Claude Sonnet 4.0/4.5模型后,Project Vend第二阶段的AI商店“Vendings and Stuff”在盈利能力上显著改善,已基本消除负利润周,并在纽约和伦敦开设新店。
Prime Intellect BlogINTELLECT-3是一个106B参数的专家混合模型,在GLM 4.5 Air基础模型上使用SFT和RL训练,在数学、代码、科学和推理基准测试中达到其规模的最优性能,优于许多更大型的前沿模型。
Liquid AI BlogLiquid AI 与 Shopify 达成数百万美元的多年协议,Shopify 将获授权使用 Liquid AI 的旗舰 Liquid 基础模型(LFMs)进行搜索及其他用例。
Anthropic Research八名 Anthropic 研究人员(无机器人经验)被随机分为两组,一组使用 Claude,一组不使用,任务是用四足机器人狗捡海滩球。使用 Claude 的团队完成任务更多、更快,并唯一实现了让机器人完全自主捡球的目标。实验显示 AI 能显著提升机器人技术,促进数字与物理世界的融合。
 Cognition Blog
SWE-1.5 是一个拥有数百亿参数的边界规模模型,在编码方面实现了近乎 SOTA 的性能,并通过与 Cerebras 合作将其服务速度提升至高达 950 tok/s,比 Haiku 4.5 快 6 倍,比 Sonnet 4.5 快 13 倍。SWE-1.5 现已在 Windsurf 上可用。
Dify Blog7070Dify 平台现整合 Qdrant 高性能 Rust 向量数据库,为构建可靠、生产级 AI 应用提供更快检索、混合搜索和可扩展性能。该集成使开发者无需成为向量搜索专家,即可通过简单配置选择 Qdrant,实现百万级文档的毫秒级检索、基于元数据的复杂检索策略和混合搜索能力,支持从原型到生产的高性能扩展。
Dify Blog7575Dify 平台可无代码快速构建聊天机器人、AI 智能体和智能搜索系统,但生产环境部署常遇挑战。TrueFoundry AI 网关可无缝衔接开发与生产,提供成本控制、安全加固、服务降级和供应商切换能力,支持实时成本追踪、角色访问控制、多区域负载均衡及跨模型兼容。
Dify Blog7575Dify 与 Arize 合作将可观察性工具 Phoenix 和 AX 带入 Dify 生态系统,以评估、监控和改进智能体。Phoenix 可自动追踪模型调用、工具调用和链步骤,收集输入、输出、延迟和元数据,并支持标注追踪、构建结构化测试数据集、创建定制评估和运行测试。
Prime Intellect BlogEnvironments Hub 发布,一个开放的社区平台用于扩展 RL 至 Open AGI;支持开发、共享和重用 RL 环境,降低构建、共享和复用环境的摩擦,促进开源 AGI 进步;已开放给所有人使用,提供 RL、Reinforcement Fine-tuning (RFT)、计算和推理基础设施。
Liquid AI BlogLiquid AI 今日宣布,其高效的 Liquid Edge AI Platform (LEAP) 平台已原生支持 AMD 最新 Ryzen™ 和 Ryzen AI™ 处理器,为开发者在设备端构建高质量 AI 解决方案带来性能提升。
Prime Intellect BlogPrime Intellect 发布 SYNTHETIC-2 数据集,包含四百万条经验证的推理轨迹,涵盖迄今最全面的复杂强化学习任务和验证器。该数据集通过全球计算贡献者的管线并行分布式推理协作生成,1,253块 GPU(包括49个8xH200节点、43个8xH100节点及大量消费级3090和4090 GPU)在3天内参与创建。
 Hamel Husain6565
Claude Code 使用聚类方法从每个簇中选择示例进行审查,结合主动学习技术通过监控标注文件 annotations. 来更新故障分类并查找相似案例或不同故障,审查方法需根据目标进行实验性优化并保留随机样本以发现当前信号未描述的故障模式。
Anthropic ResearchAnthropic 与 Andon Labs 合作,让 Claude Sonnet 3.7 运营位于旧金山的自动化商店,测试大语言模型持续运营商业的能力。Claudius(Claude Sonnet 3.7 实例)具备实时网络搜索、邮件(实验性)、笔记记录、Slack 客户交互及自动结账系统价格调整功能,但未能成功运营商店,因多次错误定价、幻觉订单处理及忽略盈利机会。
Dify BlogDify 1.5.0 发布,通过节点运行记录和变量传递功能实现工作流调试,支持单步执行和变量实时修改,显著提升 AI 应用开发透明度。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
Liquid AI Blog7575Grafting 是一种通过修改预训练模型计算图来探索新架构设计的简单两阶段方法,包括激活蒸馏和轻量级微调。
Dify BlogDify 通过循环变量、结构化输出和 Agent 节点构建深度研究工作流,实现迭代探索与综合报告生成。工作流包含意图识别、动态研究循环(含六变量追踪)和研究成果合成三个阶段,Agent 节点利用 exa_search、exa_content 和 think 工具完成信息收集与处理。最终输出带引用的 Markdown 报告,加速专家级研究方法自动化。
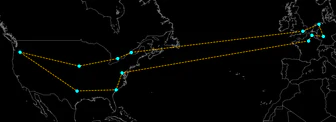
Prime Intellect BlogPCCL发布,专为全球分布式训练设计,具备容错性,支持在公共互联网上运行,每对数据中心带宽达45 Gbit/s,北美与西欧间训练带宽达25 Gbit/s,支持动态成员加入与重加入,通过在主要套接字实现(Linux、macOS、Windows WSA)上的长时间压力测试验证其高容错性。
Prime Intellect BlogINTELLECT-2 是首个通过全球分布式强化学习训练的 32B 参数模型,采用完全异步 RL 跨动态异构计算贡献者群组训练推理语言模型。开源了训练框架 PRIME-RL 及 TOPLOC、SHARDCAST 等组件,并改进 GRPO 训练配方与数据过滤技术,在数学和编码任务上提升 QwQ-32B 性能。
Prime Intellect BlogPrime Intellect 预览其分布式推理栈,专为消费级 GPU 和公共互联网 100ms 延迟设计,并发布 PRIME-IROH、PRIME-VLLM、PRIME-PIPELINE 三个开源代码库以实现延迟感知流水线并行,旨在通过消费级硬件和网络连接实现 AGI 的开放与民主化。