TechCrunch · AI7070
OpenAI 将决策模型 Decisions API 广泛开放,决策模型市场竞争升温
OpenAI 首次将决策模型 Decisions API 广泛开放给用户,该模型将 ChatGPT Luna 重构以实现更快推理和更低成本,速度从秒级缩短至毫秒级。
TechCrunch · AI7070OpenAI 首次将决策模型 Decisions API 广泛开放给用户,该模型将 ChatGPT Luna 重构以实现更快推理和更低成本,速度从秒级缩短至毫秒级。
 Databricks Blog3838
Fraud Analyst AI Coworker 可在单一平台上实时检测电信欺诈。该 AI 通过跨渠道关联、行为建模和设备模拟等技术,弥补传统欺诈检测系统在架构上的不足。其上下文窗口为 6-7 个系统数据源,速度提升 3.4 倍,但具体参数规模、benchmark 分数、价格及可用性(开源/闭源/API)原文未提及。
 OpenAI News3535
OpenAI 推出 Decisions API,为应用程序提供快速、专注、低成本的决策功能。
 Hugging Face Daily Papers7070
AgenticRoboRL 框架通过监督微调和多轮强化学习提升机器人规划器,在 LIBERO-PRO 上将 9B 参数规划器成功率从 18.1% 提升至 71.0% 不依赖外部记忆,接近 Codex (GPT-5.5) 使用外部记忆达成的 72.1%。该框架适配不同执行机制,将记录的规划器交互与任务结果连接,通过适配器实现通用强化学习训练流程。
 AWS Machine Learning Blog2727
IskayPet 通过 Amazon Bedrock Managed Knowledge Bases 构建了企业知识助手,该助手能在零售运营、兽医护理、人事入职和采购等四个领域、跨越三个国家和四种语言回答员工问题,无需管理 RAG 基础设施。
 MarkTechPost同一件事 · 2 家
Liquid AI 发布 RIPL 实时推理引擎,将 Liquid 基础模型(LFM)在请求路径中服务,端到端生成响应时间少于 50 毫秒,并在持续峰值流量下保持低延迟。
 NVIDIA Technical Blog6565
NVIDIA GPUDirect Storage 可将数据直接从存储设备传输到 GPU 内存,据 2025 年斯坦福 AI 指数,AI 计算能力约每五个月翻一番,LLM 训练数据大小约每八个月翻一番,GPUDirect Storage 可提升数据传输效率。
AWS Machine Learning Blog使用Amazon SageMaker AI上的Kokoro-82M TTS模型流式传输AI代理的语音响应,将生成与合成同步,以减少延迟并降低推理成本,Kokoro-82M模型包含8200万参数,在单个ml.g5.xlarge GPU实例上运行。
AWS Machine Learning Blog5858Amazon SageMaker 训练会话 API 允许用户从本地 Python 进程驱动 GPU 加速的会话,通过调用 forward_backward()、optim_step() 和 sample() 等操作实现算法自由,SageMaker AI 负责管理 GPU 资源。
AWS Machine Learning BlogSageMaker AI 推出无 GPU 管理的模型定制功能,用户可通过训练会话控制后训练逻辑,无需管理底层基础设施。支持 SFT、DPO、RLVR、RLAIF、多轮 RL 等技术,并可选择 LoRA 或全量微调。
AWS Machine Learning Blog3434Rescale 利用 Strands Agents 和 AI-DLC 框架在 AWS 上五天完成智能分流代理的搭建,并在数周内投入生产。该代理通过调用 Claude Opus 4.8 对夜间端到端测试失败进行分类,检索知识库中的历史失败模式,查询 MCP 日志获取运行时证据,生成包含文件引用、函数名和推荐修复方案的整改报告供工程师审核。
 n8n Blog
自托管 LLM 可让你掌控数据存储位置,适合敏感工作负载,但需承担硬件、维护和运营成本,而云 API 则大多代为处理。混合方案允许在本地或云端路由请求,无需管理两个独立系统。
n8n Blogn8n允许工程团队在AI代理构建中根据需求选择有状态或无状态架构。有状态架构通过保留跨请求或会话的信息实现连续性,但需额外基础设施管理状态;无状态架构通过独立处理每个请求提升可扩展性和容错性。有状态系统适用于依赖先前交互的场景(如对话、多步流程),而无状态系统更适配需要快速扩展和简单维护的REST API等应用。
NVIDIA Technical Blog7070NVIDIA DGX Spark 可连接更多节点,支持并行运行前沿级 AI 模型,需数百 GB 内存;开发者可编排多模型并链式推理。
 Google Developers Blog
Google API Gateway 现在支持流式传输,允许实时 API 调用,无需更改规范。流式传输支持 Server-Sent Events (SSE)、分块传输编码、HTTP 响应流和 WebSocket,最长连接时间可达一小时。在公共预览期间,创建网关时通过 `--enable-streaming` 标志启用,计划在正式版中自动启用,无需额外配置。
 NVIDIA Blog同一件事 · 2 家
NVIDIA今日发布Minerva平台,通过整合基础设施和AI工作负载的遥测数据,并应用专有AI模型将其转化为及时、可操作的洞察,帮助团队更早发现问题并保持AI工厂的生产力。
各家口径不同:NVIDIA博客称Minerva帮助团队更早发现问题并保持AI工厂生产力;NVIDIA技术博客则侧重于通过整合复杂系统将遥测混乱转化为极致GPU产能。
 Latent Space7575
Moshi推出商品交易推荐引擎,连接市场信息与交易者核心需求。该引擎整合市场数据、工作界面及定制化推荐,帮助交易者处理海量信息。Moshi CEO Anekha Sokhal强调,实用AI需融入实际工作流程。
TechCrunch · AI6565Anthropic 发布 Claude Duet 应用,旨在与 Meta Muse、OpenAI Dots 等竞争,该智能体面向专业人士和小型企业,可自动化管理任务
 IT之家 · AI3535
小米 REDMI Book 14 2027 笔记本采用金属材质、72Wh 超大电池,真实办公续航达 20.2 小时,搭载第三代英特尔酷睿平台,配备超级小爱 2.0 支持AI办公内容生成,10 月 27 日发布。
Hugging Face Daily Papers7575Socratic Skill Learning 通过教学与练习交替的方式提升可迁移的智能体技能,在主要测试集上达到 0.801 的效用,优于轨迹蒸馏和对比蒸馏方法。
IT之家 · AI7575小鹏 IRON 人形机器人每 0.2 秒重新推理一次,可预测 6 秒内动作变化。它与人互动时能灵活应对临时“变招”,如握手、碰拳、击掌,并调整回应。机器人搭载物理世界大模型,拥有 3 颗图灵 AI 芯片,构建 VLT+VLA+VLM 高阶大小脑能力组合。
IT之家 · AIAnthropic 平台工程团队所有代码由 Claude 生成,工程师转向系统设计与验证,AI 智能体已自主修复测试并探索直接修改代码库。
 NVIDIA Newsroom
欧洲交通领导者 Bolt with Lucid、梅赛德斯-奔驰、大众商用车和 Einride 正在 NVIDIA Hyperion 计算平台上展示自动驾驶交通应用案例,展示对 3 级和 4 级车辆以及未来自动驾驶出租车车队的潜在应用。
NVIDIA NewsroomAgile Robots 发布 Agile ONE SN 人形机器人参考平台,搭载 NVIDIA Isaac GR00T 和 Jetson Thor,计划集成 NVIDIA Halos 安全系统,为开发者提供完整的人形机器人开发与验证平台。
 机器之心同一件事 · 2 家6565
DeepSeek开源了其支撑大规模推理服务的基础框架DeepInfer及配套token编解码组件deepseek-recipe,采用Apache 2.0许可证。DeepInfer是DeepSeek推理服务核心,框架开源后用户可计算AI毛利达82%。
 Mastra Blog6565
Mastra Observability 是一个托管平台,直接连接到 Mastra 框架项目,提供 traces、metrics 和 evals 功能以持续改进智能体。用户可搜索过滤 traces、监控性能成本与正确性,并通过 eval loop 优化智能体;平台免费提供每月 10 万事件,付费计划每月 250 美元含 100 万事件。
 PyTorch Blog3030
Torch-spyre 的 Inductor 决定每个内核的工作如何在 Spyre 的核心上分配,并管理张量在片上 Scratchpad 和片外内存之间的驻留,而后端编译器将这些决策转换为硬件可以实际运行的指令。
IT之家 · AI蚂蚁数科发布决策模型 LingDT-Decision-1.0,在 23 项开源评测基准中性能超过 Microsoft-Decision-1、Jev 1.13.等模型,其 27B 版本取得最高准确率,在真实业务场景中将 Token 消耗降低超 90%,响应时效提升 10 倍。
IT之家 · AI5050一汽-大众捷达 M6 今日上市,提供 465 Pro(7.98 万元)、555 Max(8.98 万元)、555 Ultra(9.98 万元)三种配置,搭载地平线征程 6M 芯片支持城区/高速 NOA、跨层记忆泊车,OTA 后支持车位到车位全链路领航;内置千问+DeepSeek+豆包三大模型,配备 113kW/145kW 驱动电机,续航 465km/555km。
MarkTechPost同一件事 · 2 家DeepSeek 开源了 DeepInfer 推理框架,该框架用于运行其生产服务并支撑 DeepSeek-V4.1-Flash。
MarkTechPost同一件事 · 2 家Google 开源了 TorchTPU,一个为云 TPU 设计的原生 PyTorch 后端,取代了 PyTorch/XLA 并支持 eager-first 执行。
各家口径不同:MarkTechPost 表示 TorchTPU 是为云 TPU 设计的原生 PyTorch 后端,旨在取代 PyTorch/XLA 并支持 eager-first 执行;TechCrunch 提到它是对 Nvidia AI 开发者生态系统的攻击。
MarkTechPostGoogle Cloud 发布开源分布式推理栈 llm-d 1.0,将 vLLM 或 SGLang 模型服务器整合为统一池,在 PyTorch 会议北美站发布,目标解决自托管智能体和强化学习工作负载中轮询负载均衡失效问题
MarkTechPost同一件事 · 2 家Mistral AI 发布了 Voxtral 3 语音模型家族及基于 LiveKit 的语音智能体 SDK,包含 3 个转录模型、1 个文本转语音模型。
各家口径不同:The Decoder 提到文本转语音模型(Voxtral Mini TTS 3),而第一份报告没有详细说明。
IT之家 · AI6565华硕破晓 Air 搭载第三代英特尔®酷睿™7处理器350(6核6线程,2.8K OLED屏),CPU-Z单核744.1分/多核3725.1分,CineBench R23单核2003/多核7838,续航达19小时28分钟,16GB LPDDR5X内存+512GB PCIe 4.0 SSD,支持小硕知道×WorkBuddy专享版和ExpertMeet AI会议方案。
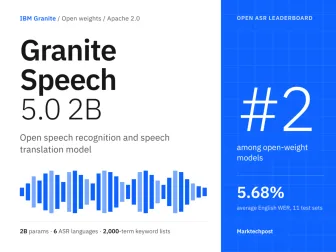
MarkTechPost7575IBM 发布 Granite Speech 5.0 2B,一个 2B 参数的开源语音语言模型,支持 6 种语言的语音转写与翻译,在 Open ASR 排行榜上排名第二,英语平均 WER 5.68%。模型采用 YaRN 扩展至 16k 位置,支持 GPU、Apple Silicon 和本地 CPU 部署,并包含 2000 项关键词偏置功能。
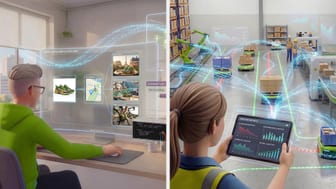
NVIDIA Blog欧洲零售商正利用开放模型和物理智能,例如将推理成本降低 90% 的电商平台,以及通过数字孪生模拟不同机器人舰队协作的配送中心。Shopify 使用 NVIDIA 加速的开放模型,通过后训练将 NVIDIA Nemotron 3.5 Lightning 集成到 Sidekick 中的 GraphQL 子代理,实现 90% 的成本降低和 7 倍的响应速度提升。
NVIDIA Blog企业正使用 NVIDIA DSX AI 工厂平台整合电网与 AI 工厂系统,从变电站到机架进行规划、模拟和运行,以解决电力成为基础设施最大瓶颈的问题。
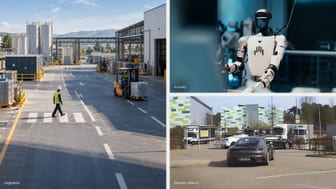
NVIDIA BlogNVIDIA 扩展 Cosmos 平台,新增训练工具、模拟检查点和 Cosmos Data Factory 蓝图,帮助开发者快速构建世界模型。Cosmos Data Factory 提供 5 个云原生蓝图,通过 GitHub、Azure 等渠道支持自动驾驶数据生成、图像属性增强等任务,Porsche 和 ANYbotics 已应用以加速物理 AI 开发。
NVIDIA Blog欧洲金融服务机构在 GTC Berlin 展示基于 NVIDIA 加速计算的专有智能系统,使用 Open 模型运行于自身基础设施。
MarkTechPostPerplexity 与 NVIDIA 联合推出 JOLT,一种语言模型后训练方法,通过联合在线学习和教学,用单一模型同时扮演师生角色,教师模型接受特权信息并接受 KL 惩罚以接近学生模型,学生模型通过教师模型的 token 级别蒸馏信号学习。