MiniMax-M3-MXFP8 发布:原生多模态模型支持百万级上下文
MiniMax-M3-MXFP8 是一款拥有 1M 上下文窗口、约 428B 参数和 23B 激活参数的原生多模态模型,通过 MiniMax 稀疏注意力机制(MSA)实现 9 倍预填充和 15 倍解码速度提升。该模型在长时程智能体基准中表现领先,支持三种推理模式,可通过 Hugging Face 下载并使用 SGLang、vLLM 或 Transformers 框架进行部署。


ByteDance Seed/TaskMem 模型发布,参数规模 31B,使用 BF16 张量类型,但未部署任何推理提供商。
Anthropic 通过监督代理行为和实施访问边界来限制 Claude 在产品中的访问权限,以降低风险。他们开发了 Claude Code 自动模式以减少用户批准疲劳,并采用沙盒、虚拟机和出站控制等技术来设置硬边界。三种主要风险——用户误用、模型不良行为和外部攻击者——需要通过环境、模型和外部内容三个层面的防御措施来应对,这些措施应相互补充以限制代理的破坏范围。
ByteDance Seed/SimArt 模型预训练权重发布,包含用于生成关节式 3D 对象结构(URDF 文件)的多模态大语言模型(MLLM)权重,以及用于编码解码 3D 零件几何形状到离散潜在空间的稀疏 VQ-VAE 模型权重。
MAI-Image-2-Efficient是微软推出的文本到图像模型,生产力版本,速度提升22%,效率提升4倍,每1M文本输入令牌5美元,图像输出令牌19.50美元,比旗舰版成本降低41%,平均比其他领先模型快40%。适用于批量处理和实时交互工作流,已在Microsoft Foundry和MAI Playground提供。
Kimi K2.6 是一个开源多模态智能体模型,在长时程编码、编码驱动设计、主动自主执行和群组任务编排方面取得显著进步。它拥有 1 万亿参数,上下文长度达 256k tokens,在 HLE-Full 基准测试中达到 54.0 分,在 BrowseComp(智能体群组)基准测试中达到 86.3 分,并支持 300 个子智能体并行执行 4,000 个协调步骤。
SWE-Check 模型在内部评估中达到与 Opus 4.6 相当的性能(F1 分数从 0.09 提升至 0),并在外部评估中实现显著进步(F1 分数从 0.49 提升至 0.29),其运行速度提升 10 倍且推理成本更低。该模型通过结合生产环境原生集成、奖励线性化技术及多阶段微调开发,可在 Windsurf Next 中预览并即将正式发布。
SWE 1.6 是专为软件工程智能体构建的最新模型,在 Windsurf 上提供通用支持,速度达 950 tok/s 且未来 3 个月免费。相比 SWE-1.5,SWE 1.6 在 SWE-Bench Pro 上提升超 10%,通过联合优化用户体验和推理流畅度,显著减少过度思考、工具调用冗余等行为,使模型交互更高效。
开源大语言模型 GLM-5 和 MiniMax M2.7 在文件操作、工具使用和指令遵循等核心智能体任务上,与闭源前沿模型(如 Claude Opus 4.6、GPT-5.4)表现相似,工具调用可靠且指令遵循一致。
微软推出了MAI-Transcribe-1、MAI-Voice-1和MAI-Image-2三款顶级AI模型,MAI-Transcribe-1每小时起价0.36美元。
MAI-Transcribe-1 在 FLEURS 评测中实现了 25 种语言的最低词错误率,优于 Scribe v2、Whisper-large-V3 等竞品,并保持 25 种语言的高精度。该模型提供 2.5 倍于微软现有 Azure Fast 的批量转录速度,售价每小时 0.36 美元,现已在 Microsoft Foundry 开放预览。
我们与 Browserbase 合作,为浏览器和计算机使用智能体提供最佳训练体验。Browserbase 提供可扩展的浏览器基础设施,已支持微软的 Fara-7B 和谷歌的 Gemini 2.5 CUA。
Dify Cloud 将免费试用体验升级,Message Credits 现支持 OpenAI、Claude(Anthropic)、Gemini(Google)和 Grok(xAI)四款模型,无需配置 API Key 即可使用;Explore 页新增精选模板试用功能,提供 5 消息额度,涵盖文件翻译、个性化记忆助手、患者信息收集等场景,无需插件配置。
SWE-1.6 在 SWE-Bench Pro 上取得 11% 的更高分数,但存在过度思考和自我验证问题,模型以 950 tok/s 的速度运行。该模型通过改进 RL 算法和扩展基础设施训练,计算量提升两个数量级,目前向小部分用户开放早期访问以收集反馈。
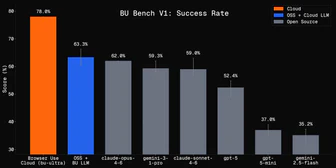
Browser Use 发布开源浏览器自动化基准 BU Bench V1,包含 100 个硬核浏览器任务,Claude Fable-5 评分最高达 80.0%,领先 GPT 5.5 12 点;Browser Use Cloud (bu-ultra) 评分 78.0%,速度约 14 任务/小时。基准基于真实网站任务,使用 LLM 判定器评分,可在 GitHub 获取。
科学家通过 Claude 4.5 在生物图解、计算生物学和蛋白质理解基准测试中取得显著进步,该模型已通过 API 供全球顶尖研究人员免费使用,并构建出超越文献综述或编码辅助的定制系统。在实验室中,Claude 作为协作伙伴贯穿研究全过程,通过多种工具将通常耗时数月的项目压缩至数小时,并发现人类可能忽略的大数据集模式,消除知识密集型任务瓶颈,甚至启用传统方法无法采用的全新研究途径。
Liquid AI 发布 LFM2.5-1.2B 模型家族,其预训练扩展至 28T tokens 并通过强化学习显著提升后训练效果,在知识、指令遵循、数学和工具使用基准上表现优异。该系列包含 Base、Instruct、日语、视觉语言和音频语言模型,所有模型均开源,可在 Hugging Face 和 LEAP 获取。音频模型比前身快 8 倍,原生运行于车辆、移动设备和 IoT 设备。
INTELLECT-3是一个106B参数的专家混合模型,在GLM 4.5 Air基础模型上使用SFT和RL训练,在数学、代码、科学和推理基准测试中达到其规模的最优性能,优于许多更大型的前沿模型。
SWE-1.5 是一个拥有数百亿参数的边界规模模型,在编码方面实现了近乎 SOTA 的性能,并通过与 Cerebras 合作将其服务速度提升至高达 950 tok/s,比 Haiku 4.5 快 6 倍,比 Sonnet 4.5 快 13 倍。SWE-1.5 现已在 Windsurf 上可用。
Anthropic 研究团队发现,通过向预训练数据中注入 250 份恶意文档,攻击者可以成功后门化参数规模从 600M 到 13B 的 LLM,且所需文档数量与模型规模无关。该研究挑战了现有假设,表明后门攻击可能比预想的更易实现,因为创建恶意文档远比生成数百万文档简单。
Anthropic 与 Pattern Labs 合作,对 Claude Opus 4 和 Claude Sonnet 4 的网络安全攻击能力进行了深入评估,结果显示 Opus 在灵活思考和适应挑战方面显著提升,并在漏洞识别和执行复杂攻击链上取得进步。然而,模型在应对意外障碍时仍存在维持长期计划的一致性问题,Pattern Labs 已发布完整评估报告。
INTELLECT-2 是首个通过全球分布式强化学习训练的 32B 参数模型,采用完全异步 RL 跨动态异构计算贡献者群组训练推理语言模型。开源了训练框架 PRIME-RL 及 TOPLOC、SHARDCAST 等组件,并改进 GRPO 训练配方与数据过滤技术,在数学和编码任务上提升 QwQ-32B 性能。
Effective State-Size (ESS) 是一个衡量模型内存利用率的代理指标。通过分析深度学习序列模型(如注意力、SSM、门控卷积)的输入依赖矩阵 T(u),定义 ESS 为 T(u) 子矩阵的秩,揭示模型状态压缩、初始化和特征化、状态调制等关键特性。研究发现,有效调节 ESS 的 LLM 在高召回任务中表现更优。
INTELLECT-2 发布,首次实现全球分布式 32B 参数模型强化学习训练,任何人可无许可贡献异构算力,通过异步强化学习范式消除通信瓶颈,支持异构推理节点,推理节点仅需 4×RTX 3090 GPU 即可参与训练。
PRIME-RL 算法结合合成推理数据微调的 Qwen-7B-Math 模型训练出 INTELLECT-MATH,在数学推理基准测试中超越 Eurus-2-7B-PRIME 并将训练时间缩短 10 倍至 47 步(原需 592 步);同时发布包含 500 万条推理轨迹的 NuminaMath-QwQ-CoT-5M 数据集,所有代码、权重及数据均开源。
INTELLECT-1 发布,首个由全球协作训练的 10B 参数语言模型,基于 Llama-3 架构,在 5 国 3 大洲 112 个 H100 GPU 上完成 1T token 训练,PRIME 框架实现 400x 通信带宽降低,96% 计算利用率,支持 8192 序列长度、128256 词汇量,模型代码及数据已开源。
Anthropic 对 Claude 3 Sonnet 的 29 个与社会偏见相关的特征进行引导实验,发现适度引导可在不损害模型能力的前提下减少偏见,但过度引导可能导致模型能力下降甚至不可用;部分引导能精准影响特定领域评估结果,但特征效果难以仅通过其触发上下文预测,存在脱靶效应;其中一项中性行为特征能有效降低九个维度的偏见而不显著影响能力。
INTELLECT-1 启动全球首个 10B 参数模型分布式训练,邀公众贡献算力参与,推动开源 AGI 进程。该训练基于 OpenDiLoCo 开源实现,将 DeepMind DiLoCo 方法的 1B 参数规模扩展 10 倍,显著降低通信频率(最高 500 倍),通过量化伪梯度(int8)与 500 步外优化器同步将带宽需求降低 2000 倍。
OpenAI今日发布o1系列(含o1-mini)推理模型,需API Tier 5访问,Dify已支持其集成。开发者可在Dify平台通过API Key配置OpenAI o1模型,并选择为默认推理模型,支持200消息免费试用。
Anthropic 开发了一种测量大模型说服力的方法,比较了 Claude 1、2、3 三代模型及紧凑型和前沿型模型,发现各代模型说服力均呈提升趋势,最新模型 Claude 3 Opus 的说服力与人类无显著差异。
Devin 在 SWE-bench 基准测试中成功解决 13.86% 的问题,远超此前最高 1.96% 的未辅助基线,即使提供确切文件也优于最佳前代模型(4.80%)。
Dify 发布 v0.4.1 版本,重构模型运行时架构以替换基于 LangChain 的旧接口,旨在简化开发流程并提升代码库的健壮性与对贡献者的友好度;新架构减少对外部依赖,与开发需求更契合,并支持 OpenAI、Anthropic、Azure 等模型提供商及 Google Gemini,通过 YAML 配置简化模型部署。
Dify v0.3.30 发布,新增 GPT4-Vision 多模态模型功能。该模型支持通过聊天构建智能体,自动生成可复用技能并保留对话上下文,便于工作流集成。Dify 同时推出 CLI 工具 difyctl 和创作者中心及模板市场。
Dify.AI v0.3.29 版本新增对 OpenAI GPT-4 Turbo(128K 上下文)和 GPT-4 Vision 模型的支持,并引入外部数据 API 工具及敏感内容审核功能。
Dify V0.3.9 版本整合了 Anthropic 的 Claude2 和 Claude-instant 模型,支持高达 100K Token 的超长上下文对话。用户可快速在网页嵌入 AI 应用,创建个性化官网客服。注册即获 1000 消息额度。