NVIDIA Technical Blog6565
Fine-Tuning NVIDIA Nemotron 以掌握本地规则而非仅限本地语言
Fine-Tuning NVIDIA Nemotron 可通过本地数据适配通用模型,使其具备特定应用所需的本地知识与文化精确性。该技术使模型在满足本地语言需求的同时,能理解并执行本地规则。NVIDIA Nemotron 通过微调实现这一功能,适用于需要高度本地化能力的场景。
NVIDIA Technical Blog6565Fine-Tuning NVIDIA Nemotron 可通过本地数据适配通用模型,使其具备特定应用所需的本地知识与文化精确性。该技术使模型在满足本地语言需求的同时,能理解并执行本地规则。NVIDIA Nemotron 通过微调实现这一功能,适用于需要高度本地化能力的场景。
 Hugging Face Blog
Hugging Face 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性。
 Meta Engineering
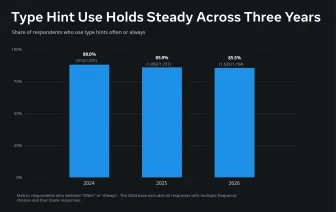
2026 Python 类型提示调查收到 1794 份回复,检查器选择出现显著变化,半数受访者使用多个检查器,缺失库类型信息仍是主要困难。AI 工具在类型提示中的使用率大幅提升,从 18.5% 增至 38.4%,其中 42.5% 的受访者由 AI 生成类型提示,61.0% 使用 AI 修复检查器错误,但 29.8% 对 AI 辅助编码的实用性表示不确定。
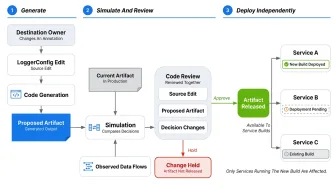
Meta EngineeringMeta 的 PrivacyLib 通过一个通用库在数据访问点实现隐私控制,替代了以往在各系统中单独实现相同逻辑的方式。该库每秒执行数十亿次检查,支持内部 AI 智能体在受支持路径上传递上下文以监控数据访问。系统只需集成一次,新的隐私能力即可作为模块复用,无需每个系统单独开发。
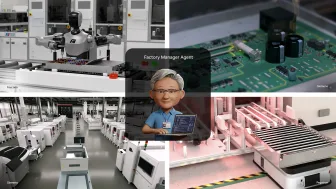
NVIDIA Technical Blog4040NVIDIA 发布工厂运营蓝图,用 AI 智能体协调调查生产问题,将平均大型工厂非计划停机成本降至每年 253 百万美元。该蓝图支持 8k 上下文长度,通过 API 提供可用性。
 Hugging Face Daily Papers
Δτ-Bench 评测智能体适应动态工具生态的能力,发现当前最强模型仅达 42.3% 任务成功率。Δτ-Bench 包含 1,588 个跨 42 个领域的多轮任务和 6 个生态系统状态。Steward 通过增量技能维护和动态资源调配,在生态变化中实现更高的任务成功率。
 Databricks Blog
Databricks 发布了将 BigQuery 迁移到 Databricks 的战略迁移框架,通过流程、技术和人员三大支柱指导 BI。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
 The Decoder
Thore Graepel团队提出借鉴AlphaGo策略构建AI系统,通过知识账本记录已知信息并验证每一步结论,以减少幻觉。该方法要求推理步骤需经独立验证才改变知识状态,类似AlphaGo结合预测网络与系统搜索。因推理可分解为小步骤,该方案可能更适合小模型在边缘设备和机器人上部署。
 a16z News5858
Databricks 通过其 Lakehouse 和 Lakebase 架构创新,正推动企业系统记录向更适应智能体协作的新模式转变,每日由智能体启动的数据库超 1700 万个,预示着未来工作模式将更依赖一线员工自主决策,而非传统层级管理。
Hugging Face Daily PapersPrincipia 是一个基于 LLM 的框架,在推理时构建并迭代优化科学原理,以加速分子和生物领域的发现。它通过比较相关输入及其观察结果形成因果假设,然后综合这些假设中的重复关系形成归纳性原理,并利用构建的假设和原理获取新观察,根据新观察修订假设并重建原理,使科学知识在推理过程中不断演化。
Hugging Face Daily Papers6565AV-FABLE 引入一个用于长视频稀疏篡改的音频视觉基准,表明冻结的音频视觉大语言模型的感知特征包含最佳通过分离时间解码器而非语言输出恢复的取证证据。长视频中的局部 AI 篡改通常影响其他内容真实的短暂事件,使视频级分类不足以进行取证分析。
The Decoder精选8888OpenAI 邀请外部专家担任“shepherd”,核查其 AI 在数学、计算机科学和物理三个领域生成的证明,并按各领域情况分别处理。数学与计算机科学的证明已被翻译成 Lean,计算机科学结果声称推翻了指数时间假设(ETH),数学结果声称证明了所有维度上的局部平滑猜想。
推荐理由: OpenAI 把三项 AI 生成的证明交给外部专家审阅,读者可据此了解 AI 科研成果如何被独立核查与分配署名。
 IBM Research Blog
IBM 与 Kaggle 合作推出 Java 框架迁移基准 ScarfBench,评估 AI 代理迁移企业 Java 应用的能力。在 204 个迁移任务中,Gemini 4 Argon 配合 Antigravity 排名第一(烟雾测试 75.2%),Claude Opus 5.5 配合 Claude Code 排名第二(全部通过率 72.1%)。
IBM Research Blog3838IBM 研究人员使用四个米级 l-couplers 连接两台 IBM Quantum Nighthawk 处理器,实现 99% 的量子状态传输保真度,展示处理器间可靠量子信息传输。该新芯片间连接设计兼容 IBM Quantum Nighthawk,并可扩展至 IBM Quantum Starling 及更先进的量子计算机。
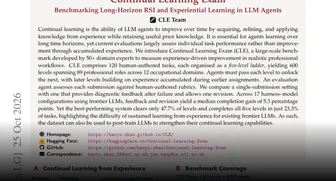
Hugging Face Daily Papers6565持续学习考试(CLE)发布,一个包含120项真实任务、600个渐进级、89个职业的基准,用于评估LLM智能体的长期持续学习与经验学习。测试了17个前沿配置,最强系统Claude Code + Opus 5仅完成47.7%的级别和23.3%的任务阶梯。
 O'Reilly Radar6262
北京大学 的 Harness-Zero 项目通过将 Qwen3.5-9B 框架的行为训练到模型中,使其在表格编辑、多应用工具使用和化学任务上平均成功率提升 21 点,超过原框架+模型组合。
 Ai2 Blog
Ai2 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性,发现微调提示词可致准确率差异超 50%。研究构建包含 154 人类原创及 154 AI 生成科研想法的基准数据集,证实模型判断稳定性不足,需更可靠方法评估 AI 提出的新想法。
Hugging Face Daily Papers6565函数空间策略优化(FSPO)框架通过存储稀疏历史下一词分布作为固定时间目标,结合特权适应与函数空间时间整合,显著改进了 SDPO 方法,无需维持持久教师模型即可实现时间分离。
Hugging Face Daily Papers提出统一框架整合基础模型与运行时组件以可靠执行复杂数字任务,引入工作持久性与开放性维度,并识别五类核心能力及优化方法。
Hugging Face Daily Papers6565FORK 奖励机制通过结合评分驱动的必要性信用和事实评分,同时优化召回率和精确率,提升了响应质量并减少了冗余。与仅基于召回率的传统奖励相比,FORK 显著提高了精确度并缩短了响应长度,同时保持了相似的评分覆盖率,在 RubricHub-Medical 和 HealthBench 上将胜率分别从 10.6% 提升至 68.0% 和从 22.1% 提升至 74.1%。
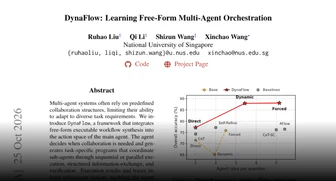
Hugging Face Daily Papers3838DynaFlow 通过让主智能体合成可执行的流程来协调子智能体,实现自适应多智能体协作。该框架在主智能体的动作空间中集成了自由形式的可执行流程合成,主智能体决定何时需要协作并生成特定任务的程序,通过顺序或并行执行、结构化信息交换和验证来协调子智能体。
Hugging Face Daily PapersTraceTrial-Bench通过机制导向任务、轨迹追踪和故障归因评估智能体框架的可靠性,涵盖上下文、执行、治理等七方面,对4个框架、9个模型和95项任务进行3,420次运行评估,得出宏平均框架分数59.8%至72.0%。
Hugging Face Daily PapersInteractiveWorld 提供了一个可验证的模拟环境和基准,用于评估多模态语言模型(MLLMs)能否可靠地指导人类完成物理任务。实验使用 12 个前沿 MLLMs 在包含 120 个多轮任务的基准上评估,结果显示它们距离成为可靠的助手仍很远,即使是 Claude Fable 5.1 在长时程指导与规划任务上的得分也仅为 20% 和 25%。
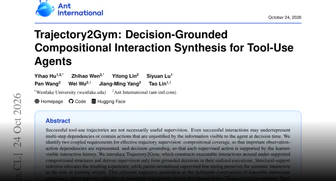
Hugging Face Daily PapersTrajectory2Gym 通过构建具有组合覆盖和决策基础的交互来改进工具使用训练,而非收集成功轨迹。该系统在五个 Qwen3 模型规模上提升了 Tau1、Tau2 和 BFCL 指标,平均提升 16.9-29.8 百分点,尤其增强状态化多轮交互能力。
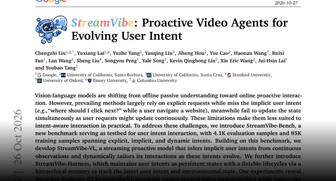
Hugging Face Daily Papers6565StreamVibe-Bench 发布包含 4.1K 评估样本和 85K 训练样本的基准,用于测试显式、隐式和动态用户意图交互;StreamVibe-VL 是一个流式主动视频语言模型,通过持续观察推断隐式意图并动态调整交互;StreamVibe-Harness 通过分层内存框架维持用户意图为持久状态,跟踪最新用户意图和环境状态,使主动交互响应一致性提升 12.3%;
 36氪 · AI同一件事 · 2 家
OpenAI宣布在数学、计算机科学和物理学领域取得三项新发现,涉及调和分析、复杂性理论和量子场论。该公司正与学术界合作,邀请外部专家引导团队理解研究结果,参与者自愿且无报酬,并可自由讨论分享成果。OpenAI不会为内部模型产生的这些发现寻求学术署名。
各家口径不同:The Verge称发现是'重大'的,而36Kr具体指出了'调和分析、复杂性理论和量子场论'。
 The Verge · AI精选同一件事 · 2 家8383
OpenAI 公布三项由 AI 产出的“重大”发现,分别涉及数学、计算机科学和物理,并首次安排外部专家作为“shepherd”引导计算机科学和物理结果的验证。
各家口径不同:The Verge称发现是'重大'的,而36Kr具体指出了'调和分析、复杂性理论和量子场论'。
推荐理由: OpenAI 公布三项 AI 产出的数学、计算机科学与物理结果,并首次引入外部专家把关,读者可据此观察 AI 科研成果的验证与署名规范如何形成。
 IT之家 · AI精选9494
OpenAI 宣布其 AI 模型在数学、计算机科学和物理学领域取得三项成果,包括证明适用于所有维度的局部光滑猜想并由此解决挂谷猜想、给出指数时间假设(ETH)不成立的证明,以及提出量子色动力学与杨–米尔斯理论的存在性证明。
推荐理由: OpenAI 称模型在数学、算法与物理三领域给出可形式化验证的证明,并公开材料交由外部专家审查。
 OpenAI News
OpenAI 分享了在 Kakeya 猜想、指数时间假设和量子色动力学方面的模型结果,并说明研究人员如何验证和基于这些结果进行构建。
 LangChain Blog5858
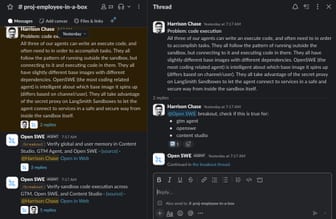
LangChain 内部智能体通过 Slack 集成,以用户身份或固定凭证执行任务,具备全局与用户级记忆,在沙盒中执行代码,并支持后台调度运行。其架构包含 GTM、OpenSWE 和 Content Studio 三种智能体,分别处理 GTM 活动、工程代码审查和营销内容创作,通过“ breakout”功能优化用户体验,并解决身份认证等核心问题。
 Apple Machine Learning Research
GHARP 方法通过少量输入图像和表情信号实时动画化 3D 人头,分为离线的身份阶段(构建几何与外观表示)和运行时的动画阶段(预测表情残差)。该方法在预训练重建模型的语义结构潜在空间中执行动画,使表情变化空间受限,实现高效残差预测,并在 Ava-256 基准上达到 SOTA 质量,A100 GPU 速度提升 13 倍、高斯数量减少 8 倍。
 PyTorch Blog3434
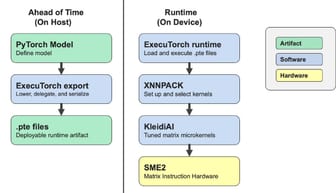
Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
The Decoder5858研究人员分析了 Claude、GPT-5.6、GLM-5 等模型生成的 120 次对话、45 次编码会话和 980 篇文章,发现 AI 文本因过度使用不寻常的词语组合而难以阅读。
OpenAI News4040OpenAI 分析了 ChatGPT 在近 100 个国家的 165 项工作活动中的使用数据,揭示了人们如何使用 ChatGPT 进行工作以及使用情况随时间的变化。
 Artificial Analysis Articles6565
Claude Opus 5.5 在 Code2Video-AA 的五项指标上均领先,每项任务成本差异达 300 倍,所有模型视频渲染率至少 96%。
NVIDIA Technical Blog6565NVIDIA Minerva 通过整合 AI 工厂中数十万 GPU、NVIDIA Spectrum-X 网络和 NVLink 等复杂系统,将遥测数据转化为极致 GPU 产能。该系统支持分布式调度器和多周训练运行,实现持续同步的生产流程。
 Exponential View6565
Claude Code v2.1.159 发布,Anthropic 26% AI 研发由 Claude 领导并有人监督;Sakana AI 和 Gemini 驱动的 AlphaEvolve 代码智能体分别提升 SWE-bench 和 Polyglot 30pp/15pp,MiniMax M2.7 模型智能体迭代提升 30%。
The Verge · AI5858OpenAI GPT-6.1 Sol 在将 COBOL 代码迁移到现代语言(C++、Java、Kotlin、Python、Rust)时,低推理努力下行为保留准确率达 87%,高推理努力下达 98%。Anthropic 的 Claude Code 也被用于 COBOL 代码迁移,但未提供性能基准。专家认为 AI 工具在处理遗留代码方面取得进展,但距离安全替换关键遗留系统仍很远。OpenAI GPT-6.1 Sol 在迁移 COBOL 代码到现代语言方面取得显著进展。
 Import AI6060
AI安全创业公司Resolution通过AI系统自动形式化统计学习理论中的数学命题,完成singularities的形式化,预计将加速对损失函数几何与泛化关系的研究。