NVIDIA Newsroom5858
NVIDIA RTX Spark 笔记本电脑新增型号、智能体工具及游戏支持
NVIDIA RTX Spark笔记本电脑新增型号,搭载Blackwell RTX GPU和Grace CPU超级芯片,支持高达128GB统一内存和1 petaflop FP4 AI性能。
NVIDIA Newsroom5858NVIDIA RTX Spark笔记本电脑新增型号,搭载Blackwell RTX GPU和Grace CPU超级芯片,支持高达128GB统一内存和1 petaflop FP4 AI性能。
 Hugging Face Blog精选7878
NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
 IT之家 · AI
摩尔线程开源 Megatron-MUSA-Titan 项目,支持万卡级集群的万亿参数 MoE 模型训练,覆盖预训练与强化学习场景,实现高 MFU 与长稳训练。项目支持 blockwise FP8 训练,结合 DeepEP 与 ACE 异步通信引擎加速 Token 分发与结果合并,提升端到端训练效率。
IT之家 · AILiquid AI 发布 LFM3 模型家族,首批多款均基于 LFM3-1.7B-Base,其中 LFM-1.7B 拥有 256K 上下文窗口,在参数减少 35% 的同时性能优于上代 LFM2.5-2.6B。
 Hacker News · AI 热帖
Survival LLM 是一款完全在个人电脑上运行的免费 AI 助手和应急知识库,无需互联网即可提供基于可信来源的答案,并显示答案来源。
 MarkTechPost6060
FlashMap通过连续流图绘制器将离散扩散绘制器替换为连续流图,在Qwen3-8B上对GSM8K实现高达6.14倍的无损速度提升,其绘制器权重(Qwen3-8B和Qwen3-4B)已开源至Hugging Face,支持vLLM和SGLang插件。
IT之家 · AI6565开发者在 DeepSeek Harness GitHub 代码库中发现 deepseek-v5、deepseek-v5-open 和 deepseek-v5-next 三个模型标识符,目前仅作为框架占位符。
IT之家 · AI6565智原科技宣布获得美国客户AI芯片开案,设计制程、复杂度、NRE金额及先进封装均创公司记录。该云端AI芯片基于三星2nm工艺,采用逻辑SoC与定制DRAM的垂直堆叠及混合键合技术,支持PCIe Gen6。
 Hugging Face Daily Papers
分解矢量量化技术通过在互补特征视图上使用并行码本提升了离散视觉token质量,使其在多模态理解中能匹配连续表示,在工业级多模态数据上训练的模型在九项指标平均上比 UniAR 和 Emu3-Chat 分别高 22.8% 和 59.2%,是目前首个能与 Qwen3-VL 等强连续表示模型竞争的离散表示模型。
 Ai2 Blog
Ai2 开源模型 olmOCR 2 可用于从文档图像中提取可搜索、结构化文本,包括手写和复杂布局,研究人员已将其用于使档案照片库可搜索并改进手写考古记录的转录。
Hugging Face Daily Papers6565Looped Transformers 在相同计算量下通过完整回溯时训练优于截断回溯,扩展规律表明当模型大小可调时两个循环为最佳。Looped Transformers 通过复用共享层块增加计算深度而不增加可训练参数量,通常使用回溯时训练(BPTT),但为节省训练计算量常截断至最后几循环,这可能导致梯度偏差削弱循环优势。
 量子位
蚂蚁集团旗下百灵大模型开源 Ling-3.1-flash-1019,在智能指数 AA-Briefcase 中得分 1524 Elo,较上一版本提升 3 分;基础模型 Ling-3.1-flash-base 采用混合线性 MoE 架构。
Hugging Face Daily Papers6565HABIT-Bench 评估智能体从数百次会话的合成用户历史中习得习惯的能力,要求智能体整合零散证据并选择新请求的适当行动。使用 Qwen3-235B-A22B 和 GLM-5.3-Flash 评估八种记忆方法,最佳配置在四选任务中达到 33.61% 宏平均准确率,优于随机猜测的 25%。即使提供标注证据,仍存在大量错误,表明理解应如何指导决策比单纯回忆历史更重要。
 36氪 · AI6565
PHYMI 发布首款 Physical Agent 产品 Sagi 萨其玛,定位“行动伙伴”,面向露营、办公与社区协作场景,执行取送、搬运等任务。
IT之家 · AI6565前英特尔 CEO 基辛格通过风投机构 Playground Global 支持内存初创公司 Nagare Labs 开发 Z2RAM 内存技术,完成 500 万美元种子轮融资。Z2RAM 采用氧化物半导体材料,计划通过标准后端工艺(BEOL)实现多层存储结构,无需 EUV 光刻,目标比特密度达 SRAM 的 5 倍以上,计划四年内推出样品。
Hugging Face Daily PapersOvisOCR3是一个0.8B视觉语言模型,通过多导师蒸馏和强化学习统一多种OCR任务,在文档解析、通用OCR、关键信息提取、图文描述和跨页表格重建等任务上达到SOTA结果,在OmniDocBench v1.6上获得96.74分,在OCRBench v2英语和中文拆分中排名第一,并在多个基准测试中超越基线模型。
 Codex releases55
GitHub Copilot发布rust-v0.166.0-alpha.5,该版本为开发者提供代码创建功能。
Hugging Face Daily Papers6565Redistribution sensitivity score (RSS) 识别在 27 个预训练 SAE 模型(覆盖 8 个语言模型)上产生可重复特征重新分配模式的特征响应,结合 clean margin 可量化其对下游读出的贡献。
Hugging Face Daily PapersChronoReplay训练框架通过将异构时空监督组织成按时间排序的交互片段、保留特定任务答案格式、平衡不同监督信号学习,使单一模型能学习互补时空能力并保持时间一致性,在 OVO-S-Bench、OST-Bench 和 UCS-Bench 基准测试中均取得提升,OST-Bench 提高 13.41 分,同时通过自适应帧选择优化流式推理性能。
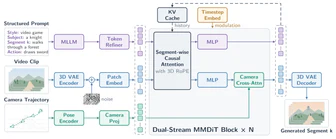
Hugging Face Daily Papers同一件事 · 2 家Hy-Nomas 是一个 8B 参数的扩散模型,支持自由形式文本指令和跨多轮交互的相机控制,通过因果注意力与结构化视频描述相结合的方式遵循多轮文本和相机指令,在人类评估中优于现有世界模型,已开源模型权重、代码和基准。
 Gemini CLI releases1515
Gemini CLI v0.67.0-nightly.20261028.gfa5c17365 发布,修复了 Android Termux 系统路径的 ripgrep 解析问题、CRLF 行尾符的 diff 处理、终端宽字符渲染,以及确认操作流程中的重复历史记录和双重遥测问题。
IT之家 · AI开发者让微软 Surface Duo 2 原生运行 iOS 26,双屏触控已可用,并计划适配 iOS 27。该项目通过移植苹果 XNU 内核和驱动实现,设备被识别为“iPhone 17 Pro Max”,双屏以 37fps 运行,但壁纸显示异常、部分界面存在图形错误。
IT之家 · AI3535华为 FreeClip 2 耳夹耳机潮玩拼色版今日开售,售价 1299 元,可选红/黄、蓝/黄、红/蓝三色。该耳机搭载华为第三代自研低功耗芯片及 NPU AI 处理器,算力提升 10 倍,新增鸿蒙 AI 耳边助手支持头动播报等功能。
Hugging Face Daily Papers6565HiP3R 使用层次位姿图将局部视频重建合并为全局一致的相机轨迹和 3D 几何,无需重新训练。它首先优化鲁棒的块级 Sim(3) 图以建立全局布局和尺度,然后固定此布局并估计每帧的共享 SE(3) 相机,将重叠窗口预测转换为单一轨迹。实验在多个基准上证明 HiP3R 在改进相机轨迹和 3D 重建方面的有效性,且适用于基于块和流式后端,无需额外训练或微调。
36氪 · AI4040OpenAI发布GPT-6.1 Terra模型,可解读图纸、编辑视频,标准API价格比GPT-5.6 Terra和GPT-6.1 Sol低50%。
MarkTechPostUC Berkeley 的 Sky Computing Lab 开发了开源向量索引 LEANN,通过查询时重新计算嵌入而非保存到磁盘,将 6000 万片段维基百科索引从 201GB 压缩至 6GB。该索引在 NQ 基准上达到 25.5% 的准确率,使用 4GB 存储空间,但检索耗时 2.48 秒(HNSW 为 0.05 秒)。代码采用 MIT 许可,支持在笔记本电脑和工作站上运行。
Codex releases55GitHub Copilot rust-v0.166.0-alpha.4 发布,该版本包含新功能改进和性能优化。
 Claude Code releases1515
Claude Code v2.1.312 发布,新增 OIDC 用户 ID 声明支持、全屏发送提示优化、技能路径修复等;修复了 VS Code 扩展会话设置获取。
 Ollama releases
Liquid AI 发布 LFM3 小模型家族,包含 1.7B 参数的 lfm3 文本模型(256K token 上下文)、支持图像理解的 lfm3-vl、18 语言语音处理能力的 lfm3-audio 及通用模型 lfm3-omni,用于本地智能体和结构化输出;d1 决策模型升级至 2B 参数,支持文本、图像及音频决策,部分模型支持苹果硬件。
Gemini CLI releases1515Gemini CLI v0.66.0-nightly.20261013.g204db94ae 发布,修复了 UI 输出同步、终端缓冲闪烁、工具容器滚动边框出血
Gemini CLI releases1212Gemini CLI v0.67.0-preview.0 发布,新增将 IDE 伴侣桥接至容器沙箱的 CLI 功能,并修复了工作区为家目录时重复加载智能体的核心问题。
 Latent Space00
Anthropic 在 Opus 5.5 发布中强调模型质量与成本,新模型运行成本低于前身;其产品选择需兼顾模型能力提升与基础设施战略挑战。Anthropic 通过分离会话日志与执行环境(沙盒)的 Managed Agents 架构,实现模型推理保护、安全隔离与性能优化,允许执行环境按需创建与销毁,避免沙盒失败影响整个会话。
 Ars Technica · AI6565
Pinal 可通过自然语言提示生成蛋白质,成功率达特定功能要求;Hugging Face 同步推出 DNA 级别类似工具。Pinal 采用 T2struct 将提示转为结构蓝本,再由 SAProt-T 结合概率评估生成序列,基于三大数据库及 AlphaFold 预测训练。
 Databricks Blog4545
Databricks Vital Skills 通过开源 Agent Skills 标准为 Genie Code 增强医疗健康与生命科学领域知识,使其在 BiomniBench 基准测试中得分提升。
Codex releases1010GitHub Copilot rust-v0.166.0-alpha.3 发布,版本号 0.166.0-alpha.3。
 LangChain Deep Agents releases1515
LangChain QuickJS 0.3.11 发布,通过延迟 QuickJS 运行时初始化解决评估阶段的问题。此版本提升了代码执行效率,并提高了对 `all` 依赖的最低要求。
Hugging Face Daily PapersQwen-Image-PE 通过两阶段训练(基于标题的逆向蒸馏和分组设计奖励)提升文本到图像提示增强能力,在 Qwen-Image-Bench 上使用 Qwen-Image-2.1 时,Qwen-Image-PE-397B 相比原始请求提升 7.81 分,Qwen-Image-PE-9B 超越所有评估的 PE 基线。
 LangChain Blog精选7171
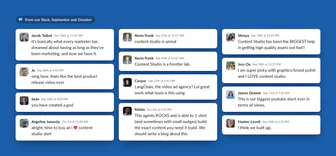
LangChain 介绍了其内部设计智能体 Content Studio 的搭建过程,该智能体在 Slack 中接收一句提示词即可产出视频、社交图、UI 图和幻灯片,所有素材均以代码生成。
推荐理由: LangChain 公开了设计智能体 Content Studio 的完整搭建过程,包括技能、wiki、检查门与异步子智能体的分工方式,可作为构建垂直 Agent 的参考。
 Pragmatic Engineer
OpenAI 开发 Sevbot AI SRE 工具,ING 银行正构建自有 AI SRE 系统。AI SRE 主要通过 Slack 快速调查事故,但关于是否应直接修改代码存在争议。企业普遍采用多代理架构,结合知识图谱与记忆层提升调查效果,同时需通过对抗代理与多模型组合验证准确性,并优化模型路由与提示词以平衡速度与成本。
 NVIDIA Technical Blog6565
Fine-Tuning NVIDIA Nemotron 可通过本地数据适配通用模型,使其具备特定应用所需的本地知识与文化精确性。该技术使模型在满足本地语言需求的同时,能理解并执行本地规则。NVIDIA Nemotron 通过微调实现这一功能,适用于需要高度本地化能力的场景。