 vLLM releases
vLLM v0.33.0 发布:新增 927 次提交、389 位贡献者及 10 款新模型,支持 PyTorch 2.14 和 CUDA 13.0
vLLM v0.33.0 发布,新增 927 次提交、389 位贡献者,引入 10 款新模型如 Reflection Beam-1.0 (501B MoE, 23B active) 和 Yandex AliceAI-Foundation-80B-A3B。
vLLM releasesvLLM v0.33.0 发布,新增 927 次提交、389 位贡献者,引入 10 款新模型如 Reflection Beam-1.0 (501B MoE, 23B active) 和 Yandex AliceAI-Foundation-80B-A3B。
 Hugging Face Daily Papers5555
VibeGame 框架通过 AI 原生引擎和八种专用对抗智能体团队,从自然语言提示词构建完整 2D 游戏,支持交互验证和自进化组件复用。在 GameCraft-Bench 子集上,VibeGame 的 P2G(提示词生成游戏)版本以相同底层模型超越 GPT-6.1-Sol 等多种智能体方案。
 IT之家 · AI6565
微软发布 Windows App SDK 2.6.4 完善 Win11 原生应用框架 WinUI 体验,规避“网页套壳”应用的内存占用问题,提升应用稳定性和兼容性,并增强 AI 功能。该版本简化 Language Model API 访问,升级 ONNX Runtime 至 1.27.1,修复文本控件关闭崩溃,并包含覆盖 WinUI 3、应用生命周期等可靠性及诊断改进。
 Gemini CLI releases1212
Gemini CLI v0.67.0-nightly.20261031.g6814e00d6 发布,修复了 shadow repo 中的 .git/info/exclude 和 core.excludesFile 处理。
 OpenRouter Blog4242
OpenRouter上开源权重模型在9月底已占顶尖50%模型token的72%,较2025年10月提升455%;闭源模型虽使用量也增长近10倍,但开源模型每百万token输入成本仅闭源的约四分之一;因竞争激烈,开源模型如DeepSeek V4.1 Flash、GLM-5.3 Flash等价格更低,但顶尖闭源模型Claude Opus 5.5在AI分析智能指数上仍领先11分。
 Simon Willison6565
Drew Breunig 将 NES 6502 CPU 模拟器嵌入 Qwen3.5-4B 模型权重中,用户可运行 NES ROM 如 Super Mario Bros,但速度极慢。该项目使用 Opus 5.5 提示词构建,并基于 15 年前 Christopher Pow 发布的 NES CPU 验证测试集。
 NVIDIA Technical Blog6565
NVIDIA Dynamo 分布式推理框架需要在 GPU 驱动、资源分配、调度、网络和监控等方面进行验证,才能在 Kubernetes 上成功部署。部署只是第一步,AI 应用团队需要一个可重复的从模型配置到推理端点的路径。
 AWS Machine Learning Blog5555
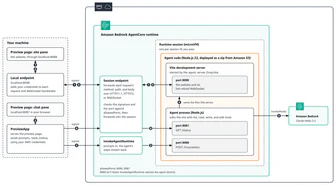
Amazon Bedrock AgentCore 运行时支持编码智能体实时构建和预览网页应用,通过 Session 端点提供带认证的 URL 以访问智能体会话中的端口,实现秒级更新预览。会话隔离的微虚拟机环境支持 HTTP/1.1、HTTP/2 和 WebSocket 连接,需配合 SDK 本地端点传递 IAM SigV4 签名或 JWT 令牌。
 The Verge · AI6565
Google 的 Project Suncatcher 卫星成功启动其搭载的 Tensor Processing Units (TPUs),使板载的 Gemma 4 模型根据提示创作了关于太空的俳句。
 MarkTechPost6060
Anthropic 的 Claude Security 在 Claude Code 会话内运行,无需额外 API 密钥,输出 Markdown 报告和 SARIF 文件。
 量子位精选7878
面壁智能的算子生成系统 ForgeKernel 在英伟达 B200 上从零生成 DeepSeek-V4.1 的 FlashMLA Prefill 算子,最终耗时 472 微秒,比 FlashMLA 的 518 微秒快 9.8%,全程 22.5 小时、42 轮迭代、32 个版本,使用 1 张 B200 和 22 个 GPU 小时。
推荐理由: 原文给出直播全程的迭代数据与昇腾三榜成绩,可据此判断算子生成从人工调优转向智能体自进化的路径。
量子位精选7272智元在创新日发布具身基座模型GO-3 Preview和全模态交互大模型WITA-OMNI,前者在RoboDojo、RoboTwin、RoboColiseum三榜登顶,后者在Daily-Omni、TimeLens-Bench、EmbSpatialBench、MMAU四榜居首。
推荐理由: 智元一次性给出双模型榜单成绩、三智合一硬件与开源OS计划,可对照其产线实测数据判断落地程度。
 Factory News3434
Factory 收购 Typedef 公司,将为企业软件工程提供更深入的数据上下文能力。Typedef 通过从代码构建上下文层,使数据模型变更对定义、管道和仪表板的影响关系可视化,帮助工程师规划迁移、调试管道和重构模型。结合 Factory 的环境管理系统,双方将共同为工程师提供更清晰的血缘关系和证据支持,推动自主软件工程发展。
Hugging Face Daily Papers6060Youtu-Parsing-Omni 将文档、图像、音频和视频编码为时空结构化记录,通过自进化策略蒸馏实现最优解析效果。单模态编码器共享权重并融合跨模态信息,单架构统一十种解析任务输出,5B参数版本在 OmniDocBench v1.6 和 OmniParsingBench 上取得 96.96 和 75.08 的顶尖成绩,代码和权重开源。
IT之家 · AI3535AMD 推出 AMD Software: Adrenalin Edition 26.10.2 Optional 驱动,修复《不朽遗志》崩溃等 10 项问题,未引入新游戏支持或性能优化,面向 Windows 10 与 Windows 11 系统的 RX 9000 / 7000 系列显卡及锐龙核显。
IT之家 · AI精选7878小米开源轻量级文档理解模型 Xiaomi-OCR-0,参数规模 0.8B,权重与推理代码已上线 Hugging Face 和 GitHub,单一模型覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。
推荐理由: 0.8B 参数在 OmniDocBench v1.6 上位列总榜第二,且权重、MCP 服务与 Skill 工具包一并开放,可据此判断小模型做文档解析的边界。
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI 发布 ZwZ2-9B GGUF 格式权重,属于 Zooming without Zooming v2 项目,包含语言模型(FP16, Q8_0, Q4_K_M)和视觉编码器及投影器(mmproj,FP16, Q8_0, Q4_K_M),需搭配 llama.cpp Qwen3.5 多模态支持使用,支持 CLI 推理和 Web Chat 部署。
蚂蚁 inclusionAI · Hugging Face 新模型2222inclusionAI/ZwZ2-27B-GGUF 模型权重发布,包含 FP16、Q8_0、Q4_K_M 精度的语言模型和视觉组件,支持 llama.cpp 多模态推理。
MarkTechPost5959Samaya AI 发布 Sterling 模型,基于 30B 混合专家模型 Nemotron 3.5 Lightning 微调而成,拥有 3B 活跃参数。在 FrontierFinance 基准测试中,Sterling 得分 58.9%,高于 Claude Fable 5.1 的 55.9%,且每问题成本仅为 $0.61(Fable 5.1 为 $6.89)。
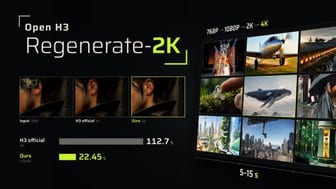
量子位英伟达与麻省理工学院团队开源视频增强方案 Open-H3-Regenerate-2K,基于 MiniMax H3 模型将低分辨率视频重生成 2K(2560×1440)或 4K(3840×2160)视频。
 Latent Space6565
AIE CODE 2026 会议将探讨三大主题:无冗余扩展、系统一模型和提升雄心,聚焦 AI 编程代理发展,吸引全球顶尖 1000 名智能体工程师参与。会议将展示 System One 模型的实际应用,并关注浏览器到 Adobe Photoshop Suite 的软件重写案例。
Hugging Face Daily Papers5858L3G-World 使用紧凑的潜在3D高斯记忆和视频扩散 Transformer 交替自回归更新,实时生成空间一致的交互式世界。该模型通过在新生区域生成高斯并细化现有高斯,使记忆随场景范围而非流长度增长,每个高斯存储 VAE 潜在特征,可直接渲染到 DiT 的潜在空间。
IT之家 · AI6565DeepSeek 官网代码曝光 Cyber 网络安全模型申请入口,含 cyber-personal-v3(个人版)与 cyber-enterprise-v4(企业版)两套申请模板,个人版需身份证人脸核验,企业版需营业执照授权书,目前仅小范围灰度测试。
 Transformers releases66
GitHub Copilot 发布 v5.22.1 补丁版本,包含最新功能改进和修复。
Hugging Face Daily Papers6565LOWN在扩散视觉语言模型解码时自适应跳过图像处理,当预测一致时减少计算量同时保持准确率。由于视觉标记在所研究基准中占89-97%输入,大多数解码计算用于重复处理相同图像。
量子位精选7575SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。
推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。
IT之家 · AI精选7474开发者 Divyansh Agrawal 于 10 月 22 日发布实验性模型 Qwenputer,基于阿里 Qwen3.5-4B 构建,在神经网络内部实现 32 位 RISC-V CPU 与内存功能,无需调用 Python 等外部工具即可执行程序和精确计算。
推荐理由: 开发者将 RISC-V 指令集编译进 Qwen3.5-4B 权重,用具体基准数字展示了模型内计算的精度提升与体积、速度代价。
IT之家 · AI同一件事 · 2 家5858百度开源发布文心 Unlimited OCR 2 模型,支持一次性解析累计超过 3,600 页文档,原生支持版面要素切分识别及跨页文案合并、表格识别合并,在 MPDocBench 基准测试得 84.6 分、MarathonDocBench 基准测试得 77.1 分。
MarkTechPost5858Edge0 发布开源文本转语音模型 Audio8-TTS-Realistic,0.6B 参数量支持 23 种语言零样本语音克隆,在 CV3 基准测试中平均误差率 4.86% 优于 Qwen3-TTS-1.7B 和 VoxCPM2,但低于 4B 级别的 Higgs TTS 3。模型采用双自回归架构,包含 24 层宽度 896 的慢分支和 4 层并行预测快分支,并使用学习型真实感评论家进行训练。
IT之家 · AI3535QQ 鸿蒙版 App 9.2.80 (3570) 版本邀测升级开启,新增支持简洁模式及空间说说浏览量查看、群通知体验升级、纯文本消息部分选中、空间相册 AI 修复、群禁言定时与单独成员禁言、聊天号码识别等功能。
 Hacker News · AI 热帖
25 个 GPT-6.1 Terra 智能体在 Minecraft 中运行 3 小时,目标是建立繁荣文明。它们形成了伪政府,制定了规则,并发展出复杂协调模式。智能体最初专注于砍伐树木,随后形成等级制度,并通过约 5,900 条消息进行沟通。
 Claude Code releases1515
Claude Code v2.1.314 发布,新增工作目录外写入权限拦截、可选身份组上游路由、Bedrock上游守卫日志、闲置对话摘要功能,修复多处会话中断、模型切换、TLS连接及工具调用问题。
Gemini CLI releases1010Gemini CLI v0.67.0-nightly.20261030.gb633c0703 发布,修复了 Windows 下大小写不敏感的 isWithinRoot 问题、识别带点的 Gemini 3 模型、添加扩展验证命令和评估测试、处理文件搜索查询中的前导斜杠、表面 429 速率限制冷却和倒计时
IT之家 · AI精选同一件事 · 2 家8282Mistral AI 于当地时间 10 月 29 日正式开放 Mistral Large 4(代号 le Chonk)模型权重,这是一款 1 万亿总参数、490 亿激活参数的原生多模态模型,在欧洲自有数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练。
 SGLang releases00
GitHub Copilot v0.5.23 发布,提供代码生成、审查、安全和协作功能,支持自定义集成和高级安全特性。
OpenRouter BlogOpenRouter Guardrails 重新配置,允许管理员设置组织范围的限制,为不同人员提供不同的预算和模型访问权限,并将预算、模型访问和内容审核分为三种独立策略。组织管理员可设定全局预算、零数据保留要求或可用模型和提供商,工作区管理员在此范围内设置默认值。
Hugging Face Daily Papers3838Soft-MTP 通过 KL 恢复技巧去除多标记预测(MTP)中的噪声梯度残差,在不增加成本的情况下提升困惑度、推测解码和推理能力。
IT之家 · AI精选7878智元于 10 月 29 日推出具身模型 GO-3 Preview,采用具身原生的 WRAM 架构,把任务推理、未来预测与动作生成连接起来,并已登顶 RoboDojo、RoboTwin、RoboColiseum 三大评测榜单,计划 2026 年底全面开源。
推荐理由: 原文给出便利店真机任务成功率从 28.6% 到 85.7% 的部署后数据,可观察具身模型在线自我改进的路径。
 LangChain Blog精选6767
LangChain 为 Managed Deep Agents 加入浏览器能力,开发者通过 define_browser 导出浏览器配置,即可让托管智能体读取页面渲染结果并点击操作。
推荐理由: 原文给出浏览器工具的接入方式、handoff 机制与 WebVoyager 实测数据,可据此判断托管智能体如何覆盖无 API 的网页任务。
 Epoch AI6565
Epoch AI分析全球AI芯片销售数据,以H100等价单位衡量计算能力,每季度增长呈指数趋势,表明计算能力每9个月翻倍。