蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI/Duo-1.2-causal-base 发布:一个用于全双工交互的多模态世界模型
inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo 1.2 causal-base 模型,这是一个用于实时音视频交互的全双工多模态世界模型,包含改进的生成质量,模型权重可在 Hugging Face 下载。
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI 发布 Duo-1.0-distill,一个用于实时音视频交互的全双工多模态世界模型,包含四步蒸馏的 Realization 权重,需与 causal-base 套件叠加使用。
 AWS Machine Learning Blog
亚马逊 SageMaker AI 双向流推出按使用量计费模式,使模型提供商能通过 AWS Marketplace 报告实时流式推理的实际使用量。Deepgram 成为首发合作伙伴,为 AWS Marketplace 带来语音转文本和文本转语音的按使用量计费。
 Google Developers Blog
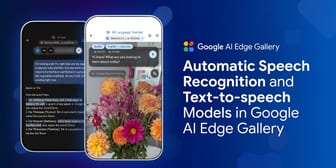
Google AI Edge Gallery 今日推出设备端自动语音识别(ASR)与文本转语音(TTS)功能,可在手机和可穿戴设备上完全离线运行多语言 ASR 和自然 TTS 模型。
 Claude · YouTube5858
Claude Fable 5.2 从一段提示词设计了语音助手中心,包括电路板布局、CAD 外壳建模和固件编写,Diode Computers 根据其设计文件制造了原型板。这是该项目中 Claude 设计的三款设备之一,Anthropic 与 Diode 存商业关系。
 Cursor Changelog精选6060
Cursor推出Voice Chat,用户可与智能体进行实时语音通话,口述改动需求、询问智能体正在做什么,并听取进展更新。
推荐理由: 官方说明了语音通话在哪些端可用、如何与编码智能体分工,读者可据此判断它适合哪些协作场景。
 Hugging Face Blog
Hugging Face Open ASR 排行榜新增埃及英语和尼日利亚英语的 Liva AI 私有数据集,包含 1.34 小时和 1.55 小时的对话语音,用于提升 ASR 评估的代表性及可信度。排行榜现支持基于 Kachru 三圈模型的更细致口音分类,涵盖 US 与非 US、内圈与外圈/扩展圈等分组。
Hugging Face Blog精选7272Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
AWS Machine Learning Blog3838Cartesia 利用专为实时语音 AI 设计的状态空间模型(SSM)和 AWS 基础设施,实现亚 100ms 的文本转语音和语音转文本,支持 44 种语言语音克隆,适用于虚拟助手、客服中心等场景。Sonic 模型在约 90ms 内生成首个音频字节,Ink 模型具备原生话轮检测和噪声鲁棒性,API 接口支持实时流式输出。
Hugging Face Blog4040MonsterHouse 是一个用 NVIDIA Nemotron Voice Agent、NVIDIA Nemotron ASR、NVIDIA Nemotron 3.5 Bolt E4B 4GB、Magpie TTS Zeroshot 和 Audio2Face-3D 构建的互动投影,能通过语音与访客交流并模仿脾气暴躁的老海盗声音。
 Codex releases4545
Codex 0.166.0 发布,新增键盘驱动转录选择(支持词、行、页操作)、集成搜索和可配置快捷键,以及 Markdown 在异步问题、选项、答案和转录回复中的一致性渲染。同时支持 GPT-6.1 Terra,并添加 codex queue --resume 功能以恢复卸载线程。
Hugging Face Blog5050Hugging Face 发布开源语音识别 AnySpeechRecognizer 和决策模型 AnyDecisionModel,支持 NVIDIA Parakeet 和阿里云 Qwen3-ASR 等引擎,可在苹果平台本地运行。
 Databricks Blog
Databricks 发布语音智能体,通过实时上下文决策在对话中调整响应,实现语言切换、转接人工或提供个性化服务。该智能体需 200 毫秒内处理客户请求,依赖 Databricks 提供的上下文、本体和治理能力,整合客户、订单、产品和政策数据,并遵循企业数据目录的访问规则。
Hugging Face Blog精选7878NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
 OpenAI News
GPT-6 Astra 成为 Retell 语音代理基准测试的领先者,Codex 则帮助其实现人均年营收 160 万美元的营收规模。
 PyTorch Blog3434
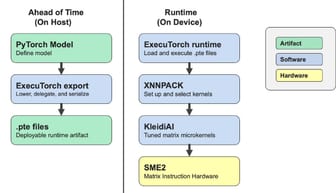
Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
 Ollama Blog精选6262
Ollama新增文本转语音能力,首个接入的语音模型是Gradium的小型TTS模型家族Phonon,目前支持macOS、Windows和Linux,支持即将推出。
推荐理由: 原文给出Ollama接入语音模型后的吞吐对比、准确率与OpenAI兼容接口,可据此判断本地TTS的落地方式。
 Amazon Science
Audible 技术团队开发新型可控语音合成技术,通过结合大型语言模型(LLM)和三项创新技术提升有声读物体验:1)开发数据合成管道生成带语音特征描述的语音数据,训练模型理解描述并生成匹配音频;2)创建自动分析书籍角色并识别对话的系统,准确率达 97%,为模型提供舞台指示;3)在 MUSHRA 测试中使对话区分度提升 3.7 分,英语和西班牙语测试中八成声音体验显著改善。
AWS Machine Learning Blog4848Amazon Polly Generative engine 升级后提供更自然、准确的语音输出,新增 14 个声音(跨 9 个地区),首次将印地语和芬兰语实现通用可用。升级为即插即用,API 调用和声音名称不变,现有应用无需修改。支持基于文本上下文的情感和韵律表达,新增语言为印地语(Arjun/Kiara)、芬兰语(Suvi),总共有 57 个生成声音(11 种语言/25 个地区),价格不变。
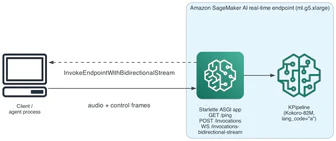
AWS Machine Learning Blog使用Amazon SageMaker AI上的Kokoro-82M TTS模型流式传输AI代理的语音响应,将生成与合成同步,以减少延迟并降低推理成本,Kokoro-82M模型包含8200万参数,在单个ml.g5.xlarge GPU实例上运行。
 腾讯混元 · Hugging Face 新模型精选7272
腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并具备实时声音克隆能力。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数超过所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比数据,并开放 GGUF 权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并可在说话过程中持续输出译文文本与语音,同时通过实时声音克隆保留说话人音色。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布并开源 Hy-SimulMT-30B-A3B 系列实时同传模型,支持中英双向语音到语音翻译和实时声音克隆,同时输出译文文本与语音。在 RealSI 长音频评测中 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 分数超过所比开源模型和 5 个商业 API 中的 4 个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署工具,可据此判断落地条件。
腾讯混元 · Hugging Face 新模型精选7474腾讯混元发布 Hy-SimulMT-30B-A3B 实时同声传译模型,支持中英双向语音到语音翻译并实时克隆说话人音色,已在 Hugging Face 开源多个版本。
推荐理由: 官方给出与开源模型、商业 API 及专业同传译员的对比数据,可据此判断实时同传的质量与延迟取舍。
腾讯混元 · Hugging Face 新模型精选7272腾讯混元发布并开源实时同声传译模型 Hy-SimulMT-30B-A3B,支持中英双向语音到语音翻译,可在说话过程中持续输出译文文本与语音,并支持实时声音克隆。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放多个量化版本和推理部署脚本,可据此评估落地成本。
腾讯混元 · Hugging Face 新模型精选7575腾讯混元发布并开源 Hy-SimulMT-30B-A3B,支持中英双向语音到语音实时同声传译,边接收音频边输出译文文本和语音,并支持实时声音克隆。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 原文给出中英双向同传的延迟与质量对比数据,并附开源权重和部署方式,可据此判断实时语音翻译的可用程度。
 Mistral AI
 推出 Voxtral 3,包含 50+ 语言实时多步对话的尖端语音模型和语音代理 SDK,其语音转文本模型 Voxtral Small Transcribe 3 在 FLEURS 45 基准中 Forced WER 0.9%。
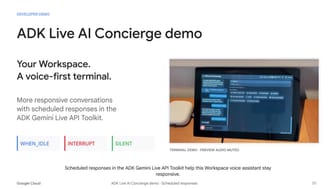
Google Developers Blog使用 ADK 和 Gemini 3.8,通过流式工具和异步函数实现非阻塞语音交互,将销售报告工作流的首次响应时间从 14.4 秒缩短至 1.2 秒,支持零静默、进度更新和并行对话。
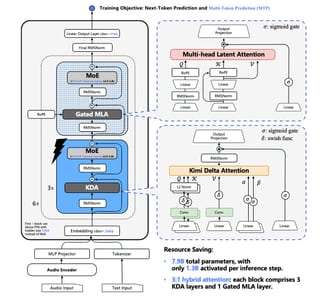
蚂蚁 inclusionAI · Hugging Face 新模型inclusionAI/Ming-3.0-asr-tiny 结合 Ling-tiny-v3 语言主干和音频编码器,支持单轮中英语音转写及15种方言识别,通过热词或对话上下文提升专业术语识别率,模型参数量未提及,在嘈杂语音和5个应用领域完成评测,提供PyTorch/Transformers推理示例及MIT授权。
 Apple Machine Learning Research2727
Whisper-small 在 CS-FLEURS 基准测试中实现 14 种语言对的平均 F1 分数 0.798,优于 CNN 的 0.776 和 HuBERT 线性基线的 0.751。该方法通过识别预训练语音编码器中的语言选择性隐藏状态维度,直接从语音中检测语言转换,仅需少量代码转换数据集即可微调决策规则。
OpenAI News5555Higgsfield 推出 GPT-6 Astra、GPT-Image-2.5 和 GPT-Live,支持创作者制作更长的视频、实现精确的视觉效果,并提供语音电影制作的路径。
 Microsoft AI News
MAI-Transcribe-2-Streaming 以低延迟实时转录 60 种语言并支持自动语言检测,在 Artificial Analysis 上最终和部分转录准确率均排名第一。
 Google DeepMind
 发布 Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS,支持从零创建自定义角色声音并直接控制场景对话。
Google DeepMindGoogle DeepMind 推出 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 大型语言模型,前者专为规模和成本效益设计。
Microsoft AI NewsMAI-Transcribe-2 在 FLEURS 基准测试中跨 60 种语言平均 Word-Error-Rate 为 5.2%,在 Artificial Analysis 上定义了准确性与延迟的帕累托前沿。
Microsoft AI NewsMAI 的音频模型 Ode Poetry 通过提问推荐诗歌并播放真人朗读录音,为全球用户提供数字诗歌体验。该系统使用 MAI-Transcribe 实时理解用户语言,在 FLEURS 基准测试中达到 4.86% 的最低词错误率;MAI-Voice 则能高保真复现威廉·西格哈特的独特嗓音。系统结合威廉的文学分析经验,通过定制逻辑和工具调用推荐诗歌,并经迭代优化实现安全、高质量的用户体验。
Microsoft AI NewsMAI-Transcribe-1 在 FLEURS 评测中实现了 25 种语言的最低词错误率,优于 Scribe v2、Whisper-large-V3 等竞品,并保持 25 种语言的高精度。该模型提供 2.5 倍于微软现有 Azure Fast 的批量转录速度,售价每小时 0.36 美元,现已在 Microsoft Foundry 开放预览。
 MiniMax News
MiniMax Speech 2.8 发布,通过原生声音标签、高保真克隆和录音棚级清晰度提升语音真实感,10 秒内可精确克隆用户声音特征,支持消除背景噪音和跨语言发音优化。