Codex releases00
GitHub Copilot 0.170.0-alpha.3 发布
GitHub Copilot 发布 0.170.0-alpha.3 版本,提供代码审查、安全漏洞检测和密钥扫描等功能。该版本适用于企业级用户,包含高级 AI 功能和 24/7 支持。
Codex releases00GitHub Copilot 发布 0.170.0-alpha.3 版本,提供代码审查、安全漏洞检测和密钥扫描等功能。该版本适用于企业级用户,包含高级 AI 功能和 24/7 支持。
 Claude · YouTube同一件事 · 2 家4242
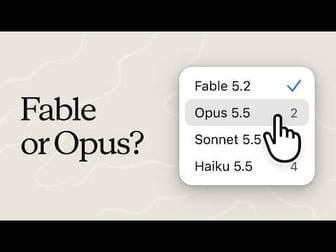
Claude Code 发布 Fable 5.2,用户需根据任务类型选择 Opus 5.5、Fable 5.2、Sonnet 5.5 或 Haiku 5.5,或跨模型分配任务;各模型可用性及使用限制因订阅计划而异。指南建议在复杂编码与知识工作、开放性技术任务、低成本限定工作等场景下分别选用对应模型。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
 Hugging Face Blog3838
Hugging Face 博客介绍了多向量嵌入模型的 Token Pooling 感知训练方法,通过 HierarchicalTokenPooling 将相似 token 嵌入合并以压缩存储。
 AWS Machine Learning Blog
Moonshot AI 的 Kimi K3.1 Pro Highspeed 已在 Amazon Bedrock 上发布,该模型为 Kimi K3 的后训练版本。
Codex releases00GitHub Copilot 发布了 0.169.0-alpha.9 版本,未提及具体更新内容。
 Google DeepMind精选8787
Google DeepMind 面向开发者、企业、科学家和消费者开放 Gemini 4 Carbon,称其在网络安全能力和长程智能体工作流上达到前沿水平。
推荐理由: 官方给出 Carbon 与 Argon 的定位分工、多项基准排名和每任务成本对比,便于判断何时该用更重的模型。
Google DeepMindGoogle DeepMind 开源 AlphaProof Code 框架,用多 LLM 智能体首次实现广泛部署的 Signal 协议代码深层形式化验证,生成超 600 万行 Lean 证明,仅 1% 代码需人工复核,将专家团队数年工作压缩至四周,并成功识别出两处已知漏洞。
Codex releases00GitHub Copilot rust-v0.169.0-alpha.8 发布,该版本包含最新功能改进和修复。
AWS Machine Learning Blog同一件事 · 2 家Anthropic 在 AWS 上推出 Claude Fable 5.2 和 Claude Mythos 5.2,Fable 5.2 是其最强大的通用模型,适用于编码和科学领域,支持长达数天的无监督运行;Mythos 5.2 通过验证计划提供,在网络安全和生命科学领域表现更可靠。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude · YouTube精选同一件事 · 2 家7575Anthropic 发布 Claude Fable 5.2,称其在编码、推理和视觉方面有所改进,面向最复杂、开放式的技术工作。官方建议多数编码和知识任务从 Opus 5.5 起步,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude · YouTube精选同一件事 · 2 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
Codex releases00GitHub Copilot rust-v0.169.0-alpha.4 发布,该版本包含最新功能改进和修复。
 腾讯混元 · Hugging Face 新模型2222
混元发布 Qwen3.8-27B-DSpine-b16 预训练模型,包含 27B 参数、b16 精度、5 层 Draft 层和 8,192 token 滑动窗口,用于推理时提升效率,需配合 Qwen3.8-27B 模型使用。
Claude · YouTube4242Salesforce 将 Claude Code 扩展至数千名工程师,使有效产出翻倍且每行代码的 Bug 数减少。该公司工程领导与斯坦福研究人员共同构建的“有效产出”评分体系衡量 AI 编码 ROI,并通过智能体成熟度曲线引导工程师从简单提示词过渡到全自主智能体。
 ByteDance Seed · Hugging Face 新模型
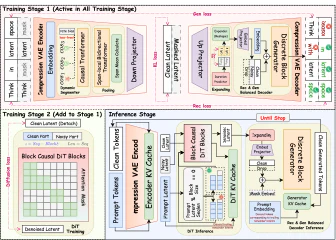
Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
Codex releases00GitHub Copilot rust-v0.169.0-alpha.1 发布,该版本提供代码审查、协作等功能。
Codex releases00GitHub Copilot rust-v0.168.0-alpha.5 发布,该版本提供代码审查、协作等功能。
ByteDance Seed · Hugging Face 新模型ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE 发布,包含在 Qwen3-30B-A3B 模型第 4、30 和 46 层训练的 TopK 稀疏自编码器(k=100,2^20 潜在变量),每个 SAE 约 17.2 GB,重建方差未解释分数分别为 12.6%、25.1% 和 7.6%。
Codex releases00GitHub Copilot rust-v0.168.0-alpha.4 发布,该版本包含最新功能改进和修复。
ByteDance Seed · Hugging Face 新模型5858ByteDance-Seed 发布跨层转码器(CLT)为 Qwen3-8B-Base,包含 36 层 × 32,768 潜在变量,参数量 94.2B,总大小 377 GB,支持 fp32 推理,通过联合评分所有层中的 360 个最高激活潜原来编码,解码时重建原始 MLP 输出。
Codex releases55GitHub Copilot 0.168.0-alpha.3 发布,该 AI 编码智能体用于任务、项目和自动化工作,包含代码审查、质量分析、安全漏洞检测等功能。
 OpenAI News精选6060
OpenAI 宣布将收购 Pierre Computer Company,以扩展 Codex 在代码构建、理解和审查方面的工具能力。原文未披露交易金额、时间表及收购后团队与产品的具体安排。
推荐理由: 官方披露的收购动作,读者可据此了解 Codex 在代码构建与审查工具上的补强方向。
OpenAI NewsChatGPT 和 Codex 正帮助工程师加速 CAD、PCB 设计、仿真等物理世界工作流
 Google Developers Blog5858
TypeSafe 的 Jev 分类器可路由任务至最经济的 Gemini 模型,50 题测试显示其准确率达 96%,优于 93.8% 的 Python 正则启发式方法;设置推理模型 MaxOutputTokens 限制并不能节省成本,反而可能中断复杂任务推理。
 Apple Machine Learning Research
苹果研究人员提出一种跨架构蒸馏配方,将基于Attention的模型蒸馏至Mamba架构,蒸馏后的Mamba模型困惑度达14.01,接近教师模型的13.86,并在下游任务中表现良好。
OpenAI NewsQodo 将公司知识与编码标准整合 Codex,在 AI 代码评审中构建上下文;帮助开发者跨仓库在打开拉取请求前捕捉 P0 问题
Codex releases00GitHub Copilot 0.167.0-alpha.2 发布,该 AI 编码智能体用于任务、项目和自动化工作,提供代码审查、质量分析、安全漏洞检测等功能。
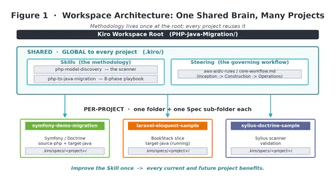
AWS Machine Learning Blog5555Kiro 将 AI 代理与代码库结合,通过可重复的八阶段工作流程将 PHP 应用迁移至 Java,支持开发者交互式审核或 AWS Transform 自动化处理,共享技能文件实现方法论统一。
 Meta Engineering精选6666
Meta公布Catching JiTTests已在内部投入生产,用LLM为待合入的diff自动生成可执行测试,在代码落地前暴露行为差异
推荐理由: Meta 公开了 JiTTests 的生产部署细节与量化结果,可供评估 LLM 生成测试在超大规模代码库中的落地方式。
 Mistral AI精选8282
Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。
ByteDance Seed · Hugging Face 新模型ByteDance-Seed/GenFirst 训练一个潜在 VAE 并联合一个生成先验,避免通常使端到端训练不稳定的潜在崩溃。该方法的两个阶段计划用于先验和熵权重:第一阶段让先验塑造潜在几何形状,第二阶段将两者权重十倍降低,使解码器恢复细节。
Codex releases00GitHub Copilot 发布 0.166.0-alpha.6 版本,未提及具体更新内容。
Google DeepMind同新闻8282Google DeepMind 发布 Gemini 4 Carbon,称其在网络安全与长周期任务上能力最强,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一
 Databricks Blog
Databricks 通过构建包含评审环节的文档提取流程,使用 ai_extract 结合 JSON schema 和全局指令提升准确率,并借助 MLflow Prompt Registry 版本化配置,最终在固定人工标注数据集上验证改进效果,使系统整体性能得到提升。
 IBM Research Blog
IBM 与 Kaggle 合作推出 Java 框架迁移基准 ScarfBench,评估 AI 代理迁移企业 Java 应用的能力。在 204 个迁移任务中,Gemini 4 Argon 配合 Antigravity 排名第一(烟雾测试 75.2%),Claude Opus 5.5 配合 Claude Code 排名第二(全部通过率 72.1%)。
Hugging Face BlogLitPivot帮助研究人员通过阅读先前文献来调整研究方向,将研究想法分为问题、贡献和评估计划,并为每个部分提供基于文献的批评和修订建议。在涉及17名研究人员的实验室研究中,领域专家评价新颖想法的文献基础比使用文本编辑器和AI聊天工具开发的想法更好,参与者也报告了更强的文献理解和对想法新颖性和实用性的提升。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-2B 模型,基于 Qwen3-VL 构建,集成 9.5M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
 Anthropic Research精选8282
Anthropic 与 Theorem 合作,用 Claude 对 123 个 OSS-Fuzz 开源库的 239 个入口点完成 RISC-V 汇编层的形式化证明,证明这些程序在小于 64 MB 的任意输入下都不会崩溃,证明代码约 1.8 亿行 Rocq。
推荐理由: Anthropic 使用 Claude 在 123 个开源库的 RISC-V 汇编层完成形式化证明,并给出成本与复用数据,可据此判断该方法能否进入日常开发流程。
AWS Machine Learning Blog5252AWS 推出在 AWS Trainium 上用 torchtitan 训练 Qwen3 的三种方法,包括使用 Transformers v5、torchtitan 原生配置以及 Neuron Kernel Interface (NKI) mixture-of-experts (MoE) 内核。
Hugging Face BlogQwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。