Google Developers Blog
ML Drift:谷歌开源边缘设备 GPU AI/ML 推理引擎。
谷歌 AI 边缘团队开源 ML Drift,这是一个高性能、跨平台的边缘设备 GPU 计算引擎,用于设备端 AI/ML 推理。通过抽象 OpenGL ES、OpenCL、Metal 和 WebGPU 等硬件低级 API 的复杂性,ML Drift 使开发者能构建实时交互式 AI 体验。
Google Developers Blog谷歌 AI 边缘团队开源 ML Drift,这是一个高性能、跨平台的边缘设备 GPU 计算引擎,用于设备端 AI/ML 推理。通过抽象 OpenGL ES、OpenCL、Metal 和 WebGPU 等硬件低级 API 的复杂性,ML Drift 使开发者能构建实时交互式 AI 体验。
 PyTorch Blog
EUROPA联盟在JUPITER超级计算机上使用PyTorch和TorchTitan成功训练了参数量达951.9B的MoE模型,将单GPU的吞吐量从90提升至约1,300 tokens/s,使用了384个NVIDIA GH200 GPU。
 vLLM Blog精选7272
NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。
推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。
 IBM Research Blog3636
ORNL、IBM 和 AMD 在 IBM 纽约波基普西园区部署量子纠错(QEC)协同设计平台,将 IBM Quantum Nighthawk r2 处理器与 ORNL Umbra HPC 系统整合,后者包含 AMD Instinct MI355X GPU 和 5th Gen AMD EPYC™ CPU,为混合 HPC-量子计算环境中的算法开发与验证提供低延迟量子-经典执行能力。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
vLLM Blog精选6060vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。
推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。
 Databricks Blog
Databricks AI Runtime (AIR) 已正式发布,支持开发者使用 NVIDIA NeMo、NGC 容器和 Nemotron 新菜谱在无服务器 NVIDIA GPU 上训练和微调开放模型。
 Meta Engineering
Meta 完成了 Prometheus 超级集群的首阶段建设,该集群计划扩展至约 100 万个 GPU,采用闭环液体冷却技术,目前运行 Muse 大型语言模型。
NVIDIA Blog5555GeForce NOW 将引入《战锤40,000:战争之黎明IV》,支持云游戏体验克洛努斯之战;DLSS 5 技术将登陆《战争 thunder》和《Where Winds Meet》,性能较前版提升十倍;本周新增 10 款游戏入库,包括《龙之信条2:暗裔觉醒》等。
 Hugging Face Blog精选同一件事 · 2 家8585
Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
Meta EngineeringMeta Andromeda 下一代广告检索引擎通过模型-系统协同设计,在检索层实现近排名级模型性能,单卡单秒处理超过 10 亿广告,系统吞吐量达 1000 亿次/秒,较 2024 年版本提升 100 倍,并为广告主带来 2.4% 的转化率增长。
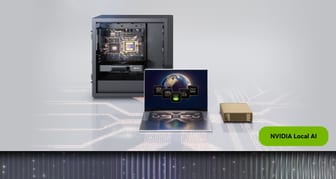
NVIDIA BlogNVIDIA 在 GTC Berlin 上展示了其本地 AI 硬件全阵容,RTX Spark 已上线支持 Windows PC 上的个人智能体,DGX Spark 支持开发者构建和扩展 Linux 应用,DGX Station 则为 Linux 企业团队运行前沿工作负载,Windows 版将于 12 月推出。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
 Google DeepMind
Gemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中纯推理得分 87%,超越所有前沿模型。Argon 可应用于机器人生命周期的各个环节,包括使用 MuJoCo 进行移动操作练习、零样本机器人控制和视频世界模型的闭环转向。
NVIDIA BlogNVIDIA RTX Spark 将游戏 PC、创意工作室和个人 AI 超级计算机的能力整合为单一超级芯片,配备高达 128GB 的统一内存和 1 petaflop 的 AI 计算能力。
Google Developers BlogGemini 4 Argon 在物理理解、代码生成和视觉语义推理方面取得重大突破,在 Embodied Reasoning (ERQA) 基准测试中得分 87%,超越所有前沿模型。
NVIDIA Blog英伟达与微软合作推出 RTX Spark 笔记本电脑和 Windows AI 代理基础设施,支持本地运行 125B 参数 Qwen 3.8 Flash Next 模型;微软发布 MXC 操作系统级容器保障代理安全运行,预购 RTX Spark 从今日起开放,搭配 Grace Blackwell 芯片,提供高达 20 PFLOPS 推理性能。
Google Developers BlogGoogle DeepMind 发布 EmbeddingGemma 2,一款参数量仅 740M 的开放权重多模态嵌入模型,能将文本、图像、视频帧和音频统一映射至单一向量空间。
 Microsoft Research
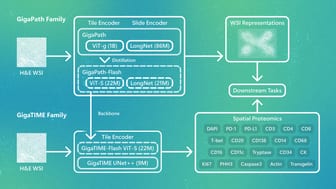
GigaPath-Flash 和 GigaTIME-Flash 通过精简的 ViT-S 编码器显著降低了计算需求,在保留性能的同时使大规模病理学研究更易实现。
 DeepSeek · Hugging Face 新模型
DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。