vLLM Blog5858
vLLM 为 MiniMax-M3.1-Flash 提供零日支持
vLLM 在 NVIDIA Blackwell、Rubin 和 AMD MI350 系列显卡上为 MiniMax-M3.1-Flash 提供零日支持,在智能体工作负载上表现优异。
vLLM Blog5858vLLM 在 NVIDIA Blackwell、Rubin 和 AMD MI350 系列显卡上为 MiniMax-M3.1-Flash 提供零日支持,在智能体工作负载上表现优异。
 Sakana AI
 发布 AI 智能体构建、执行、运行平台 Sakana Aquarium,通过本体论整合组织信息,支持 AI 智能体高效构建与安全运行。平台包含本体论、治理和智能体执行基座三核心机制,实现组织判断依据体系化与任务自动化。
 LangChain Deep Agents releases4545
`deepagents-code` 0.2.0 版本现在要求 Python 3.14,并移除了低价值启动测试。
 Amazon Science
 发布开源后端 TorchNeuron,将 PyTorch 代码转化为 AWS Trainium 系统可执行的指令,支持现有 PyTorch 代码在 Trainium 上运行,通过自适应急切模式、多级缓存等优化实现高效执行,并使用 AI 代理筛选 841 个代表性模型及数万种张量维度进行基准测试。
 Databricks Blog3838
Fraud Analyst AI Coworker 可在单一平台上实时检测电信欺诈。该 AI 通过跨渠道关联、行为建模和设备模拟等技术,弥补传统欺诈检测系统在架构上的不足。其上下文窗口为 6-7 个系统数据源,速度提升 3.4 倍,但具体参数规模、benchmark 分数、价格及可用性(开源/闭源/API)原文未提及。
 OpenAI News3535
OpenAI 推出 Decisions API,为应用程序提供快速、专注、低成本的决策功能。
 AWS Machine Learning Blog2727
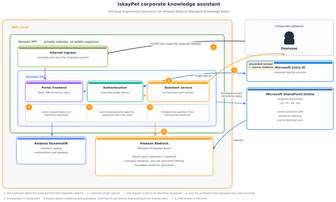
IskayPet 通过 Amazon Bedrock Managed Knowledge Bases 构建了企业知识助手,该助手能在零售运营、兽医护理、人事入职和采购等四个领域、跨越三个国家和四种语言回答员工问题,无需管理 RAG 基础设施。
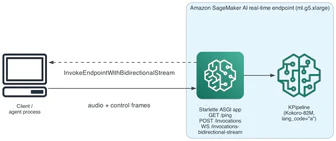
AWS Machine Learning Blog使用Amazon SageMaker AI上的Kokoro-82M TTS模型流式传输AI代理的语音响应,将生成与合成同步,以减少延迟并降低推理成本,Kokoro-82M模型包含8200万参数,在单个ml.g5.xlarge GPU实例上运行。
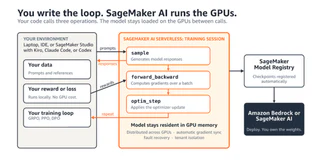
AWS Machine Learning Blog5858Amazon SageMaker 训练会话 API 允许用户从本地 Python 进程驱动 GPU 加速的会话,通过调用 forward_backward()、optim_step() 和 sample() 等操作实现算法自由,SageMaker AI 负责管理 GPU 资源。
AWS Machine Learning BlogSageMaker AI 推出无 GPU 管理的模型定制功能,用户可通过训练会话控制后训练逻辑,无需管理底层基础设施。支持 SFT、DPO、RLVR、RLAIF、多轮 RL 等技术,并可选择 LoRA 或全量微调。
AWS Machine Learning Blog3434Rescale 利用 Strands Agents 和 AI-DLC 框架在 AWS 上五天完成智能分流代理的搭建,并在数周内投入生产。该代理通过调用 Claude Opus 4.8 对夜间端到端测试失败进行分类,检索知识库中的历史失败模式,查询 MCP 日志获取运行时证据,生成包含文件引用、函数名和推荐修复方案的整改报告供工程师审核。
 Google Developers Blog
Google API Gateway 现在支持流式传输,允许实时 API 调用,无需更改规范。流式传输支持 Server-Sent Events (SSE)、分块传输编码、HTTP 响应流和 WebSocket,最长连接时间可达一小时。在公共预览期间,创建网关时通过 `--enable-streaming` 标志启用,计划在正式版中自动启用,无需额外配置。
 NVIDIA Blog
NVIDIA今日发布Minerva平台,通过整合基础设施和AI工作负载的遥测数据,并应用专有AI模型将其转化为及时、可操作的洞察,帮助团队更早发现问题并保持AI工厂的生产力。
 NVIDIA Newsroom
欧洲交通领导者 Bolt with Lucid、梅赛德斯-奔驰、大众商用车和 Einride 正在 NVIDIA Hyperion 计算平台上展示自动驾驶交通应用案例,展示对 3 级和 4 级车辆以及未来自动驾驶出租车车队的潜在应用。
NVIDIA NewsroomAgile Robots 发布 Agile ONE SN 人形机器人参考平台,搭载 NVIDIA Isaac GR00T 和 Jetson Thor,计划集成 NVIDIA Halos 安全系统,为开发者提供完整的人形机器人开发与验证平台。
 PyTorch Blog3030
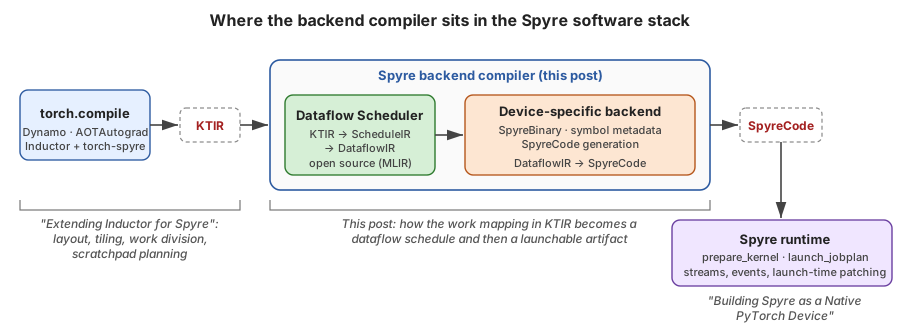
Torch-spyre 的 Inductor 决定每个内核的工作如何在 Spyre 的核心上分配,并管理张量在片上 Scratchpad 和片外内存之间的驻留,而后端编译器将这些决策转换为硬件可以实际运行的指令。
NVIDIA Blog欧洲零售商正利用开放模型和物理智能,例如将推理成本降低 90% 的电商平台,以及通过数字孪生模拟不同机器人舰队协作的配送中心。Shopify 使用 NVIDIA 加速的开放模型,通过后训练将 NVIDIA Nemotron 3.5 Lightning 集成到 Sidekick 中的 GraphQL 子代理,实现 90% 的成本降低和 7 倍的响应速度提升。
NVIDIA Blog企业正使用 NVIDIA DSX AI 工厂平台整合电网与 AI 工厂系统,从变电站到机架进行规划、模拟和运行,以解决电力成为基础设施最大瓶颈的问题。
NVIDIA BlogNVIDIA 扩展 Cosmos 平台,新增训练工具、模拟检查点和 Cosmos Data Factory 蓝图,帮助开发者快速构建世界模型。Cosmos Data Factory 提供 5 个云原生蓝图,通过 GitHub、Azure 等渠道支持自动驾驶数据生成、图像属性增强等任务,Porsche 和 ANYbotics 已应用以加速物理 AI 开发。
NVIDIA Blog欧洲金融服务机构在 GTC Berlin 展示基于 NVIDIA 加速计算的专有智能系统,使用 Open 模型运行于自身基础设施。
AWS Machine Learning Blog自适应智能体框架 (AAIF) 使用 Strands Agents,通过本地小语言模型 (SLMs) 处理常规任务,复杂请求则路由至 Amazon Bedrock 云模型,降低成本并保持低延迟。
 Hugging Face Blog精选7878
NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。
PyTorch BlogPyTorch 用户可在 AMD MI350 系列显卡上通过 FlyDSL 使用现有算子 API 加速密集和分组 GEMM、融合多头注意力、MXFP8/MXFP4 缩放 GEMM、RMSNorm 和 TopK,无需调用自定义内核
 Google Research
 发布的 AI 模型在 JAMA Network Open 上验证,其通过盲扫超声技术评估孕期周数(gestational age)的准确性。
Hugging Face BlogHugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
Hugging Face BlogQwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
 蚂蚁 inclusionAI · Hugging Face 新模型3535
inclusionAI 发布 Ling-3.0-tiny 的 UBTree 技术微调版本 Ling-3.0-tiny-UBTree-B16,参数量 183.1M,结合五层 DFlash 主干和 bigram 选择器,在 GSM8K、MATH-500 等基准上实现 2.6-3.5 倍速度提升。该模型需与目标模型配合使用,UBTree 适配 SGLang 的开源版本尚未发布。
Hugging Face Blog5858NVIDIA 发布多变量时序预测模型 Kumo Forecast(原 NV-Tesseract Forecasting),以 MOMENT-1-large 为骨干,约 3.4 亿参数编码器加可训练预测头,编码器与嵌入层权重冻结。
 IBM Research Blog
IBM 发布 vLLM-Hook MIA 插件,在 vLLM 推理引擎中实现运行时监控与控制,速度比前身 vLLM-Hook 快 20 倍、比模型内插入代码的类似方法快 14 倍,延迟仅增加 2%-6%。该插件允许开发者实时观察和调整模型状态,如拒绝恶意提示、标记幻觉事实或编辑响应语气与准确性,同时几乎不降低性能。
NVIDIA Blog精选6262NVIDIA 扩展其开放模型家族,覆盖语言、机器人、生物和量子计算,包括新的 Nemotron 3.5 Super VL 与 Nemotron 3.5 Bolt。
推荐理由: NVIDIA 一次性铺开语言、机器人、生物、量子四条线的开放模型,读者可据此判断其开源生态的覆盖范围。
 Mistral AI5050
Mistral 与 NVIDIA 合作将 AI 模型与 NVIDIA 加速计算和物理建模工具整合,加速工程模拟并实现闭环 AI 驱动设计。合作将推出公共基准和开放数据集,标准化物理和智能体 AI 在计算机辅助工程中的评估,并利用 NVIDIA Omniverse 进行 3D 模拟和资源创建。
NVIDIA Blog5555NVIDIA Confidential Computing 通过硬件根隔离和加密认证保护模型和数据执行,新增 Confidential Bare Metal 部署选项,使前沿模型构建者能在第三方基础设施上运行敏感工作负载并保留模型数据控制权。
NVIDIA Blog5858NVIDIA 欧洲合作伙伴正扩展区域计算能力,支持模型训练与推理,帮助开发者构建 agentic 和物理 AI 应用。Nscale 使用 NVIDIA DSX 平台实现 37% 更多 GPU 和 50% 更高推理吞吐量,Crusoe 开发液冷 AI 工厂支持低延迟推理,Nebius 采用 NVIDIA Groq 3 LPX 加速敏感应用。
NVIDIA BlogNVIDIA 在 GTC Berlin 上展示了其本地 AI 硬件全阵容,RTX Spark 已上线支持 Windows PC 上的个人智能体,DGX Spark 支持开发者构建和扩展 Linux 应用,DGX Station 则为 Linux 企业团队运行前沿工作负载,Windows 版将于 12 月推出。
Databricks BlogDatabricks 发布 AI Runtime (AIR),将托管 GPU 基础设施直接引入其平台,让客户能在企业数据所在地训练高需求模型。AIR 提供 GPU 基础设施、开发者工具和数据治理功能,支持大规模训练、快速迭代和负载安全,客户无需管理独立的 GPU 堆栈。
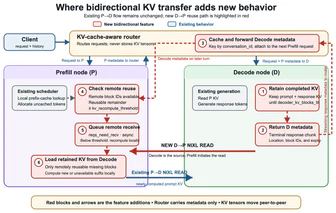
AWS Machine Learning Blog5858vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。
AWS Machine Learning Blog4949vLLM 引入基于推送的 NIXL 连接器,通过将后预填充传输协调和设置移出关键路径,减少时间到第一个 token (TTFT) 和每个输出 token 的时间 (TPOT),提升应用响应性。
AWS Machine Learning Blog3232Deepgram 通过 AWS Trainium2 将 Nova-3 语音识别模型部署到 PyTorch,在单个 trn2.3xlarge 实例上运行 8 个副本,处理离线批处理工作负载时每美元可处理 11-70% 更多音频,并使用 NKI 库和 Neuron Explorer/NAD 工具链进行内核级调优,提升推理效率。
AWS Machine Learning Blog5858TwelveLabs 的 Pegasus 1.5 视频语言模型现已在 Amazon Bedrock 上提供,可将长视频转换为结构化、带时间戳的元数据,支持基于用户定义标准分析整个视频并返回匹配片段的 JSON 数据,分析时长扩展至每请求两小时,无需预索引且数据保留在 AWS 边界内。
AWS Machine Learning Blog3434新 AWS 体验让新 SageMaker AI 客户在注册后只需几步即可进入完全配置的 SageMaker Studio 环境,无需设置高级 AWS 账户或手动配置环境,新客户还可获得 100 美元的 AWS Free Tier 信用额度。