PyTorch Blog5858
PyTorch 2.15 发布
PyTorch® 2.15 发布,默认采用重写的 NCCL 后端,支持故障记录和回滚;torch.distributed 新增 NIXL 后端的单边传输;FSDP2 和流水线并行优化内存通信控制。
PyTorch Blog5858PyTorch® 2.15 发布,默认采用重写的 NCCL 后端,支持故障记录和回滚;torch.distributed 新增 NIXL 后端的单边传输;FSDP2 和流水线并行优化内存通信控制。
 Meta Engineering
Meta Andromeda 下一代广告检索引擎通过模型-系统协同设计,在检索层实现近排名级模型性能,单卡单秒处理超过 10 亿广告,系统吞吐量达 1000 亿次/秒,较 2024 年版本提升 100 倍,并为广告主带来 2.4% 的转化率增长。
 OpenAI News
GPT-6 Astra 成为 Retell 语音代理基准测试的领先者,Codex 则帮助其实现人均年营收 160 万美元的营收规模。
 Together AI Blog3838
Together AI 推出 GPU 集群自动修复功能,通过在虚拟机和宿主机两端持续监控节点健康,在检测到故障时推荐最小化修复动作并提供证据,允许用户选择自动执行或手动批准。该功能目前全面可用,支持被动健康检查、修复建议、自动修复策略(含故障和节点级授权)、空闲等待控制、升级阶梯和安全护栏,并通过 API 和控制台进行修复;预览版提供基于节点标签的修复合约支持第三方检测系统。
 Databricks Blog4545
Databricks Vital Skills 通过开源 Agent Skills 标准为 Genie Code 增强医疗健康与生命科学领域知识,使其在 BiomniBench 基准测试中得分提升。
 Google Developers Blog3434
Google 发布对话式商务工作原型 HappyDelivery,基于 LangGraph 和 Gemini 在 GCP 上实现;Ingress 层通过 GKE/Cloud Run 和 Cloud Pub/Sub 处理来自 WhatsApp 的输入
Databricks BlogDatabricks 通过构建包含评审环节的文档提取流程,使用 ai_extract 结合 JSON schema 和全局指令提升准确率,并借助 MLflow Prompt Registry 版本化配置,最终在固定人工标注数据集上验证改进效果,使系统整体性能得到提升。
 Google Research5858
Google Research 提出睡眠框架,让 LLM 通过交替的主动(清醒)和睡眠阶段实现持续学习;睡眠阶段利用 MoE 和 Hope 架构进行参数扩展与知识蒸馏,将短期记忆整合为长期参数,支持高达 10M token 的长上下文知识保留和复杂推理能力提升。
 AWS Machine Learning Blog3434
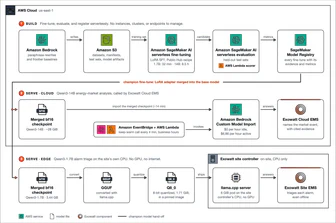
Exowatt 通过 Amazon SageMaker AI serverless 模型定制,为边缘和云部署目标生成了任务特定微调模型 Qwen3-1.7B 和 Qwen3-14B,在准确性上超越前沿模型的同时成本降低了高达 49 倍,并将模型开发周期从数月缩短至数天。
AWS Machine Learning Blog3434Property Finder 在迁移视觉 AI 工作负载至 Amazon Bedrock 时发现其评估数据集 96.8% 的标签来自单一模型的预测而非人工验证,导致新模型客观比较受阻。该公司通过人工专家独立标注 356 张图像构建可信基准数据集,并采用进化式提示优化迭代 27 次后,在保持 86% 准确率的同时将成本降低 86%。
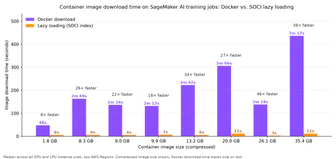
AWS Machine Learning Blog3434AWS SageMaker AI 推出 SOCI-indexed images 功能,将容器镜像下载从关键路径移除,使 SageMaker AI 训练和处理任务启动时间从分钟缩短至秒级。该功能通过预索引 AWS Deep Learning Container (DLC) 或为自有镜像添加索引实现,无需修改工作负载定义,基准测试显示可将 GPU 空闲时间减少 90%,提升效率 8-46 倍。
 NVIDIA Newsroom5858
NVIDIA Vera Rubin NVL72 和 NVIDIA Vera CPU 现已在 Oracle Cloud Infrastructure (OCI) 上正式提供,计划引入 HGX Rubin NVL8 系统以帮助组织加速前沿模型训练、提高推理效率并扩展智能体工作负载。
 Hugging Face Blog
Hugging Face 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性。
 NVIDIA Blog
C-BRAIN 与 NVIDIA 正利用 AI 改变痴呆症研究进程。他们通过整合此前未公开的阿尔茨海默症研究数据,包括未发表结果和受管制的专有数据,加速新疗法研发。C-BRAIN 运用混合集中式和联邦式架构保护数据隐私,部署 64 块 NVIDIA 数据中心 GPU 及云端节点,并计划引入 NVIDIA Blackwell 系统以支持其扩展目标。
 IBM Research Blog
IBM 与 Kaggle 合作推出 Java 框架迁移基准 ScarfBench,评估 AI 代理迁移企业 Java 应用的能力。在 204 个迁移任务中,Gemini 4 Argon 配合 Antigravity 排名第一(烟雾测试 75.2%),Claude Opus 5.5 配合 Claude Code 排名第二(全部通过率 72.1%)。
 蚂蚁 inclusionAI · Hugging Face 新模型5858
inclusionAI/Ling-3.1-flash-1019 发布,560B 参数量,25B 活跃参数/Token,1M 上下文窗口,推理能力提升,AA-Briefcase 分数 1524 Elo,AutomationBench-AA 68%,Artificial Analysis Intelligence Index v4.3.2 44 分。支持 SGLang 和 vLLM 推理。
 Ai2 Blog
Ai2 发布 Old Ideas, Novel Problems 研究,评估六款 LLM(GPT-5.1至5.4、Claude Sonnet 4.5至4.6)判断科研创新性的可靠性,发现微调提示词可致准确率差异超 50%。研究构建包含 154 人类原创及 154 AI 生成科研想法的基准数据集,证实模型判断稳定性不足,需更可靠方法评估 AI 提出的新想法。
蚂蚁 inclusionAI · Hugging Face 新模型5858SingProbe 是一个基于 Qwen/Qwen3.8-Flash-Next 的流式安全探针,通过复用基础模型的隐藏状态在生成时每一步评分查询意图、响应不安全性和幻觉风险,解码时开销不到 0.5%。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI 发布基于 GLM-5.3-Flash 的轻量级流式安全探针 SingProbe,通过复用基础模型的隐藏状态实时评分查询意图、响应不安全性和幻觉风险。
蚂蚁 inclusionAI · Hugging Face 新模型3838inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
Databricks BlogLakeflow Connect 通过原生连接器支持维基、项目管理工具和 AI 基础模型,使下游 AI 智能体获得完整业务上下文。该平台提供全面管理的原生连接器,支持 SaaS 应用、数据库和文件源,数据直接导入 Databricks 平台,通过点选式 UI 或 API 配置,增量导入 Unity Catalog 表格。
 LangChain Deep Agents releases
LangChain Deep Agents 的 deepagents-code==0.2.2 版本发布,包含安全与性能改进。新增 GPT-6.1 Terra 支持、选中文本输入至聊天、插件更新检测等功能;修复项目 .env 文件设置信任值、终端 UI 链接限制、Git 选项限制等 Bug;通过重用父进程上下文、优化服务器启动流程、精简转录渲染等提升性能,推荐尽快升级。
Databricks Blog2222Databricks Free Edition 允许师生免费在浏览器中运行完整数据或 AI 课程,无需云合同或许可证管理,适用于全球学生和教育工作者。该平台提供协作笔记本、Spark、Delta Lake、Lakeflow、Databricks SQL、Genie 代码助手等功能,支持从入门编程到 AI 项目的各类课程,技能直接应用于行业标准工具,无生产环境与教学沙箱的转换成本。
 Apple Machine Learning Research
GHARP 方法通过少量输入图像和表情信号实时动画化 3D 人头,分为离线的身份阶段(构建几何与外观表示)和运行时的动画阶段(预测表情残差)。该方法在预训练重建模型的语义结构潜在空间中执行动画,使表情变化空间受限,实现高效残差预测,并在 Ava-256 基准上达到 SOTA 质量,A100 GPU 速度提升 13 倍、高斯数量减少 8 倍。
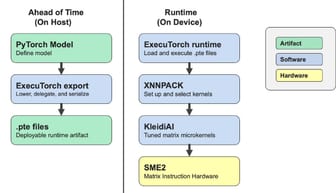
PyTorch Blog3434Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
AWS Machine Learning Blog3838Amazon SageMaker SDK v3发布,通过双分支SageMaker Pipeline为每台相机训练异常检测器和缺陷分类器,并设置质量门禁阻止性能不佳的模型。
 Claude · YouTube5050
Anthropic 工程师 Doug 分享在站会与发布评审中使用 Claude Docs 的方法。Claude 在文档中协同工作,自动提取数据、验证论点并响应评论中的问题。该工具专为团队协作设计,支持文档内实时分析。
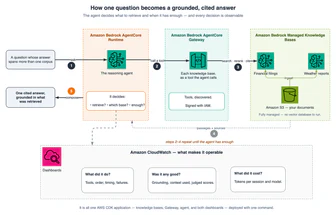
AWS Machine Learning Blog4848使用 AWS CDK 在 Amazon Bedrock 管理知识库上构建企业级智能检索,通过 AgentCore 提供的推理代理和 AgenticRetrieveStream API 实现多轮规划和工具驱动检索,返回带引用的答案。该方案部署包含 Amazon S3 语料库、知识库和推理代理的 CDK 应用,支持语义路由和多次检索,并内置 Amazon CloudWatch 监控和评估功能。
IBM Research Blog5858IBM 和 PyTorch 基金会宣布 Spyre 加速器将成为 PyTorch 的第一类后端并支持多加速器调度。torch-spyre 编译器、Spyre vLLM 插件及持续集成工作使模型和流程能运行在 Spyre 上,该架构针对推理优化,适合 IBM Z、LinuxONE 和 Power 系统。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI/Ling-3.1-flash-base 发布,560B 总参数、25B 活跃参数的稀疏 MoE 架构大模型,采用混合线性注意力机制(63 KDA + 9 Gated MLA),在 47 个跨八个领域的基准测试中表现优异,支持持续预训练、领域适应和后训练研究,模型使用 FP8 精度训练,BF16 精度发布,遵循 MIT 许可证。
 vLLM Blog精选6060
vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。
推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。
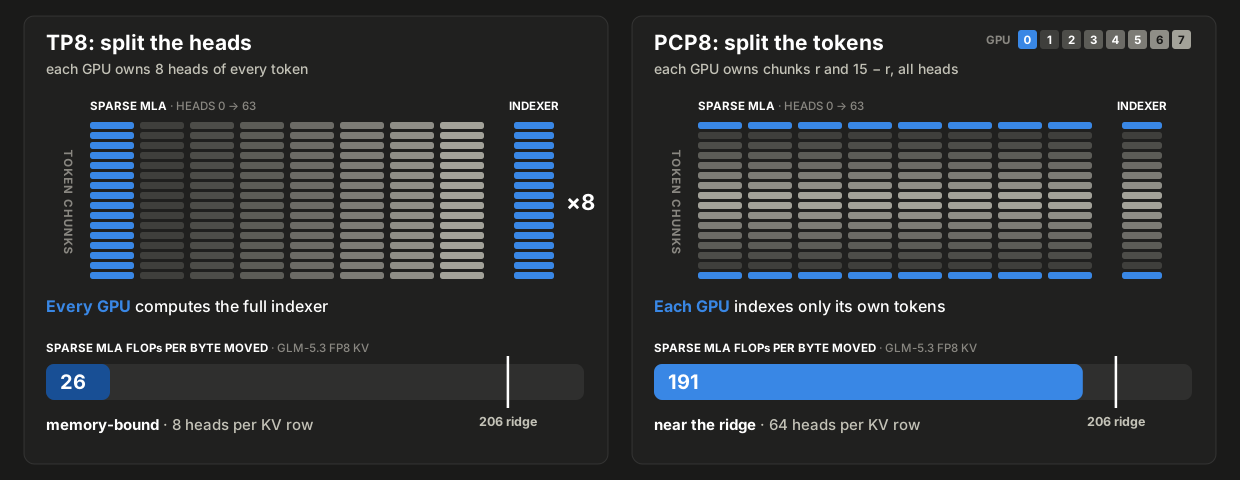
vLLM Blog精选6262vLLM 团队发布 GLM-5.3 优化第二部分,在 16 张 H200 上以 1 个预填节点加 1 个解码节点部署,用 PCP 按 token 切分预填、DCP 按 token 切分 KV cache,使 1M 上下文可放入预填节点
推荐理由: vLLM 团队拆解了 PCP、DCP 与 Hybrid HiSparse 如何在 16 张 H200 上组合,读者可据此理解长上下文部署的内存与预填瓶颈。
Databricks Blog5858Spark的声明式管道在22项数据工程任务中比过程式管道快34倍、代码量减半且错误更少。声明式管道通过运行前验证可提前捕获结构性错误,并将排序和结果保存等重复性任务卸载给Spark,而过程式管道需在集群上运行至错误步骤才能发现。两种方法在逻辑错误率上表现相当,但声明式管道的代码更简洁一致,便于维护。
AWS Machine Learning Blog5858Amazon SageMaker AI 通过多轮强化学习(MTRL)训练模型执行序列任务,用户无需提供正确轨迹,只需定义结果评分。以 Wordle 游戏为例,将 GPT-OSS-20B 模型的解决率从 61% 提升至 84%(默认推理力度),成本约 339 美元。
LangChain Deep Agents releases3535deepagents-code 0.2.1 发布,默认 Anthropic 自动分类器设置为 Claude Sonnet 5.5,新增技能范围 MCP 工具支持。
Claude · YouTubeFactory 利用 Claude 的前沿模型构建 AI 编码智能体 Droids,以实现企业级软件工程的自主化。Claude 处理大型代码库的长期任务,使团队能以更少监督信任智能体计划。构建完全自主的软件“暗工厂”仍需克服诸多障碍。
Hugging Face BlogLitPivot帮助研究人员通过阅读先前文献来调整研究方向,将研究想法分为问题、贡献和评估计划,并为每个部分提供基于文献的批评和修订建议。在涉及17名研究人员的实验室研究中,领域专家评价新颖想法的文献基础比使用文本编辑器和AI聊天工具开发的想法更好,参与者也报告了更强的文献理解和对想法新颖性和实用性的提升。
Hugging Face BlogHugging Face 发布 torch-neuronx 模型支持查询 Space,检测 AWS Trainium 兼容性。该 Space 支持查询 Hugging Face Hub 上 175B 参数规模的主流模型(如 Qwen3-0.6B)是否能在 Trainium 上无修改运行,并提供运行脚本。
 腾讯混元 · Hugging Face 新模型
腾讯混元发布 WeVisOne-VL-2B 模型,基于 Qwen3-VL 构建,集成 9.5M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。