Amazon Polly 生成式引擎升级:更自然、准确的语音输出
Amazon Polly Generative engine 升级后提供更自然、准确的语音输出,新增 14 个声音(跨 9 个地区),首次将印地语和芬兰语实现通用可用。升级为即插即用,API 调用和声音名称不变,现有应用无需修改。支持基于文本上下文的情感和韵律表达,新增语言为印地语(Arjun/Kiara)、芬兰语(Suvi),总共有 57 个生成声音(11 种语言/25 个地区),价格不变。


Anthropic 宣布把 Agent Skills 这一开放标准捐赠给 Linux 基金会下的 Agentic AI Foundation(AAIF),该基金会由 Anthropic 与 Block、OpenAI 共同创立,Anthropic 此前已向其捐赠 MCP。
推荐理由: 原文交代了 Agent Skills 的采用规模与治理移交,读者可据此判断这套智能体技能标准后续由谁维护。
Qiskit SDK v2.6 发布,新增 C API 中的编译器 pass-manager 框架、QPY 序列化及自定义操作,支持在非 Python 环境中使用,QPY 格式升级至 v18,最低 Python 版本要求 3.10,源码构建需 Rust 1.89。
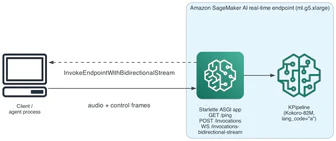
使用Amazon SageMaker AI上的Kokoro-82M TTS模型流式传输AI代理的语音响应,将生成与合成同步,以减少延迟并降低推理成本,Kokoro-82M模型包含8200万参数,在单个ml.g5.xlarge GPU实例上运行。
Amazon SageMaker 训练会话 API 允许用户从本地 Python 进程驱动 GPU 加速的会话,通过调用 forward_backward()、optim_step() 和 sample() 等操作实现算法自由,SageMaker AI 负责管理 GPU 资源。
Flint-interactive 使 AI 生成的图表具有丰富的交互性,用户可通过点击、筛选、缩放、高亮和跨图表交互来探索数据。它通过高级语义事件和更新操作简化复杂交互的构建,并利用 Flint 编译器处理交互逻辑和视觉依赖,提高可靠性和开发效率。Flint-interactive 支持创建交互式数据故事、仪表板和连接体验,AI 代理可使用其生成带交互功能的图表,帮助用户更高效地分析数据。
Uber 向 3 万多名员工推广 OpenAI 的 ChatGPT Work,帮助团队研究、分析数据、创建演示文稿和完成复杂工作流程。
OpenAI 的 FDE 意味着什么
英伟达与华盛顿大学医学院蛋白质设计研究所联合发布 RFD4-Proteina 开源模型,结合可编程蛋白质设计与搜索能力,在四项基准测试中超越基线模型,帮助科学家探索药物设计候选者。
GitHub Copilot rust-v0.164.0-alpha.12 发布。
Codex 0.163.0-alpha.11.2 发布,包含 315 次提交的更新。
Rust 发布了 0.164.0-alpha.11 版本,包含 8 个主要提交。
Cloudflare 使用 OpenAI Daybreak 调查漏洞并提出修复方案供审查,其开发者使用 Codex 构建更快、质量更高的代码。
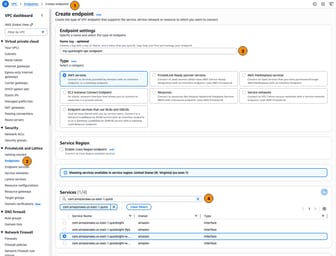
Amazon Quick 可通过 VPC 端点(AWS PrivateLink)和 VPC 连接实现用户与 API 访问及数据源访问的私有连接,确保企业数据在 AI 驱动的洞察和操作中不被公网暴露。
OpenAI 通过与分销伙伴合作,确保一致的保障措施、支持负责任的访问,并阐明使用政策中的预期
Rust 0.163.0-alpha.11.1 发布,包含 315 次提交的更新。
自适应智能体框架 (AAIF) 使用 Strands Agents,通过本地小语言模型 (SLMs) 处理常规任务,复杂请求则路由至 Amazon Bedrock 云模型,降低成本并保持低延迟。
OpenAI 提出了利用前沿 AI 强化网络防御者、加强安全防护及现代化网络安全体系的蓝图。该方案旨在提升公共机构的韧性,并强调通过民主治理框架来应对前沿 AI 的风险。
AT&T 与 OpenAI 合作,通过 LegalEdge 团队重塑法律知识获取和案件摄入流程,提升法律判断能力。
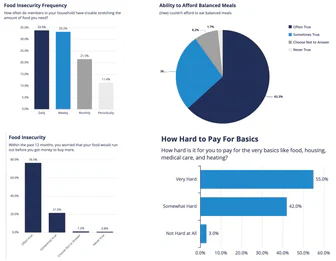
U.S. Hunger 通过 Amazon Quick 直接探索组织数据,实现领导者共享关键绩效指标定义,并在 Quick Spaces 中协同分析财务与非财务信息,支持其年增长500%的运营效率。
Microsoft 研究者与协作者结合新数学思想与人类指导 AI 证明高维几何与概率的核心问题 KLS 猜想,该猜想提出 31 年,被广泛视为该领域中心未解问题。AI 工具探索候选方法并执行详细推导,研究者评估、修剪并重新定向搜索,最终证明高维空间几何原则,使障碍随维度增加不再无界增长。独立研究者确认该成果,识别出关键标准,并完成机器检查的正式验证。
OpenAI 构建了基于 LLM 的 ChatGPT 广告栈以理解对话意图并大规模投放相关广告。该架构将广告与答案分离,确保广告内容与用户需求精准匹配。
OpenAI、PerturbAI 与 Scripps 研究所合作,使用分布式 AI 智能体分析数百万脑细胞数据,发现新的研究线索。
ChatGPT 广告已扩展至 26 个新国家,超 10 万广告商使用该平台,让更多广告商在用户探索、比较和决定购买时触达目标人群。
Patch the Planet 连接安全研究员、维护者和事件响应者,帮助应对开源项目中的关键漏洞。
OpenAI与Google Cloud合作,将OpenAI前沿模型和Codex工作流接入Gemini的模型花园,并通过Google Cloud Marketplace提供
推荐理由: OpenAI 前沿模型与 Codex 工作流进入 Google Cloud 的 Model Garden,读者可据此了解跨云分发的新入口。
IBM 发布 vLLM-Hook MIA 插件,在 vLLM 推理引擎中实现运行时监控与控制,速度比前身 vLLM-Hook 快 20 倍、比模型内插入代码的类似方法快 14 倍,延迟仅增加 2%-6%。该插件允许开发者实时观察和调整模型状态,如拒绝恶意提示、标记幻觉事实或编辑响应语气与准确性,同时几乎不降低性能。
Amazon SageMaker JumpStart 上线以来已集成 100 多个来自 30 家提供商的新模型,涵盖 Qwen 3.8-27B、Cosmos3 系列等。
Amazon Bedrock 现在支持所有 Anthropic Claude 模型的结构化输出,包括 bedrock-runtime 和 bedrock-mantle 端点。
Eon 使用 Amazon Bedrock AgentCore Gateway 替代了本地 Model Context Protocol (MCP) 服务器,将跨 AWS、GCP 和 Azure 的操作工具访问整合为单一认证网关,使新工程师调查工具配置时间从 2 天缩短至 2 分钟。
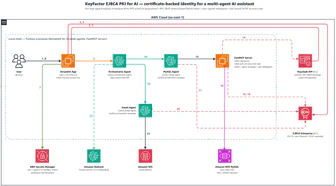
Keyfactor EJBCA 与 AWS 服务结合,通过 X.509 公钥基础设施 (PKI) 为 AI 智能体提供身份认证,解决 MCP 连接外部工具时缺乏内置认证标准的问题。
加拿大组织可通过 Amazon Bedrock 在加拿大 (Central) 和加拿大西 (Calgary) 区域使用 OpenAI GPT-5.6、GPT-6 和 GPT-6.1 模型,实现跨区域推理。
GPT-OSS-20B 是一个开源推理模型,默认用英语思考,在多语言推理测试中仅 22% 符合目标语言要求。通过在 Amazon SageMaker HyperPod 上使用监督微调(SFT)和强化学习(GRPO),团队可提升模型在法语、德语、西班牙语和意大利语中的推理能力,其中 SFT 负责主要行为教学,GRPO 在有提升空间时进行优化。
Chris White领导微软研究院Catalyst Lab,曾参与阿富汗战场数据分析项目并获DARPA委托,后转向研发打击人口贩卖的暗网搜索工具。他分享从哈佛博士后到军事技术领导者的跨界经历,强调问题选择对创新的重要性,并指出即使见过人性黑暗面仍需坚守科技向善的信念。
GitHub Copilot 用户可直接在 VS Code 中打开 GitHub Copilot app 会话,继续其对话、代码变更和上下文。用户可逐行审查 Copilot 的修改,直接在 VS Code 中进行手动编辑,并在本地运行和验证项目。会话和代码工作区保持连接,支持与 Copilot 交互式迭代优化,最后将更新提交到关联的拉取请求。
三位 Java 大师 Vlad Mihalcea、Patrick Baumgartner 和 Frank Delporte 分享了在 Hypersistence Utils、Hypersistence Optimizer、教学幻灯片迁移等项目中使用 GitHub Copilot 的经验。
OpenAI 改进 ChatGPT 在低资源编程语言中的表现,推出针对软件工程、SQLite 和 COBOL 迁移的新评估
OpenAI 收购 Orchestra Bio,将 AI 运营能力引入生命科学研发,助力生物制药团队加速药物开发。
Terminal X 的 Eval Agent 使用 GPT-6.1 评分达 88.6%,基于 54 条标准评分,能比其他方案多发现 25% 的基金使命偏差。
亚马逊与 AVERI 合作对内部安全评估数据集进行独立审查,验证了评估流程的全面性、多样性及低污染风险,但也发现语言风格、攻击复杂度、评估时效性等方面可改进。亚马逊已根据反馈更新测试集、引入难度分级框架、建立季度审查机制并扩大语言覆盖范围,此举被视为评估 AI 安全流程质量的最佳实践。