vLLM Blog
VeRL-Omni v0.3.0 发布:异步训练与更广泛的多模态后训练支持
VeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
vLLM BlogVeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
 Codex releases00
GitHub Copilot 0.168.0-alpha.7 发布,未公布具体更新内容。
 NVIDIA Newsroom5858
NVIDIA Vera 处理器在 100 兆瓦数据中心对比中超越最快和最节能的 x86 CPU,实现行业领先智能体速度并提升 1.6 倍每瓦智能体密度。Perplexity 和 DeepInfra 等早期采用者在生产测试中验证了 1.5 倍和 2.2 倍的智能体任务加速。
 Apple Machine Learning Research
苹果在ICML 2026上提出的摊销最大内积搜索通过训练小神经网络学习支持函数,以固定成本理解典型查询匹配方式,实现推理时更快的精确检索。该方法利用ICNN学习支持函数,KeyNet直接输出最佳匹配键向量,均基于实际查询分布构建的监督数据集进行训练,显著提升RAG场景下的检索效率。
 Databricks Blog5858
Databricks 与 Linux Foundation 于 2026 年 6 月宣布 Delta Sharing 升级为 OpenSharing,将共享范围从 Delta Lake 表扩展至包含 Agent 技能。
Codex releases00GitHub Copilot rust-v0.168.0-alpha.5 发布,该版本提供代码审查、协作等功能。
 Microsoft Research
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
NVIDIA Newsroom3838NVIDIA 通过全栈协同设计提升内存效率,在 GPU、CPU、网络、存储和软件各层优化内存使用。Blackwell Ultra 显卡使每 GPU HBM 容量提升约 3%,而 SemiAnalysis AgentX 上的智能体推理成本降低 30 倍。
 LangChain Blog
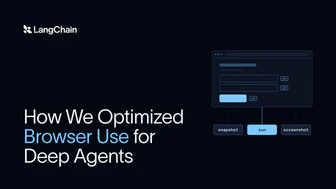
Browserbase Stagehand 工具通过代码模式让智能体一次调用完成多步浏览器操作,结合快照视图管理上下文,显著提升 Claude Sonnet 5.5 在 WebVoyager 100 任务中 90% 的通过率(总成本 $1.98。
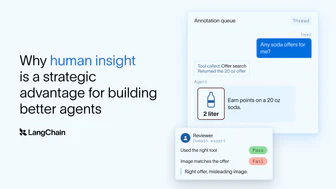
LangChain BlogLangChain 探索人类反馈三原则提升智能体开发:专家判断定义质量标准,完整上下文评估,将反馈转化为可复用数据;通过 agent trace 记录用户交互与模型行为,人工标注评分并附理由,用于校准自动化评估器、改进评估标准与构建黄金数据集,形成专家知识可复用资产。
LangChain Blog5252LangSmith Bring Your Own Cloud (BYOC) 现在支持 AWS (GA)、Azure (Beta) 和 Google Cloud (Beta),用户可将追踪、评估、数据集、提示词和智能体部署保留在自选云账户中,LangChain 负责数据层管理。
 ByteDance Seed · Hugging Face 新模型
ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE 发布,包含在 Qwen3-30B-A3B 模型第 4、30 和 46 层训练的 TopK 稀疏自编码器(k=100,2^20 潜在变量),每个 SAE 约 17.2 GB,重建方差未解释分数分别为 12.6%、25.1% 和 7.6%。
Databricks BlogNVIDIA 与 Databricks 联合为 Debezium 项目贡献的 Zerobus Ingest 消息接收器,通过直接将记录写入 Unity Catalog Delta 表。
 IBM Research Blog3636
ORNL、IBM 和 AMD 在 IBM 纽约波基普西园区部署量子纠错(QEC)协同设计平台,将 IBM Quantum Nighthawk r2 处理器与 ORNL Umbra HPC 系统整合,后者包含 AMD Instinct MI355X GPU 和 5th Gen AMD EPYC™ CPU,为混合 HPC-量子计算环境中的算法开发与验证提供低延迟量子-经典执行能力。
IBM Research Blog3838HRL 实验室开发出采用先进算法的惯性测量单元(IMU),提供不间断的 GPS 替代方案。其 MEMS 惯性传感器尺寸如汤罐,精度接近 GPS,并解决长期困扰的偏差漂移问题,通过 AutoCal 自动校准系统持续修正误差,实现无限导航支持。该 IMU 采用 ASIC 和先进封装技术优化成本与尺寸,适用于无人机等轻型载体。
Codex releases00GitHub Copilot rust-v0.168.0-alpha.4 发布,该版本包含最新功能改进和修复。
ByteDance Seed · Hugging Face 新模型5858ByteDance-Seed 发布跨层转码器(CLT)为 Qwen3-8B-Base,包含 36 层 × 32,768 潜在变量,参数量 94.2B,总大小 377 GB,支持 fp32 推理,通过联合评分所有层中的 360 个最高激活潜原来编码,解码时重建原始 MLP 输出。
Codex releases55GitHub Copilot 0.168.0-alpha.3 发布,该 AI 编码智能体用于任务、项目和自动化工作,包含代码审查、质量分析、安全漏洞检测等功能。
 OpenAI News
DevRev 利用 GPT-6.1 Sol 驱动计算机和操作员,平衡推理、速度和成本为企业服务。
 AWS Machine Learning Blog
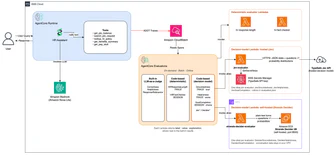
Amazon Bedrock AgentCore 评估支持使用 15 个内置评估器或自定义评估器(LLM 或代码)对智能体进行评分。决策模型适用于具有固定答案集的问题,如 Jev 和 Strands Decider 2B,它们提供校准概率而非自由文本。代码示例展示了如何将 AgentCore 评估输入转换为决策模型请求,并将模型概率转换回评估结果。
 Google Research
Agile Deliberation 框架通过迭代对话协助人类定义主观概念边界,将模糊想法转化为精确的 AI 指令蓝图。该框架分为概念界定和概念迭代两阶段,通过直接反馈处理模糊图像,在 18 次 1.5 小时用户实验中显著降低用户疲劳和焦虑,使 AI 模型性能优于标准基线。
vLLM Blog精选7575vLLM 宣布在 NVIDIA、AMD、Google TPU 和阿里平头哥真武 PPU 上 Day-0 支持月之暗面开源的 Kimi K3.1 Pro,该模型为 2.8T 参数(104B 激活)多模态 MoE,上下文 1M token。
推荐理由: vLLM 团队详述为 Kimi K3.1 Pro 做 Day-0 适配的工程取舍,含稀疏注意力、KV 缓存打包与 DCP 的具体数字。
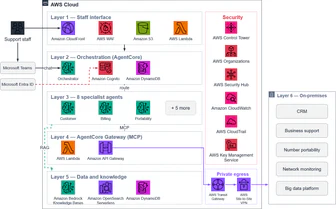
AWS Machine Learning Blog4141U Mobile 与 AWS 合作,基于 Amazon Bedrock AgentCore 开发了 AiDaH 智能客服中心,通过跨系统实时协调、链式推理和多租户安全框架,处理 150 项运营场景,关键业务工单量下降 84.5%。AiDaH 在 2025 年底启动试点,2026 年 Q3 正式上线,采用 Microsoft Teams 作为交互界面
 Together AI Blog
Together Compiler (TKCC) 通过高通量智能体实现 AI 推理工作负载的持续优化,在 24 小时内将前沿开源模型(Kimi K3、GLM 5.3)的延迟降低。
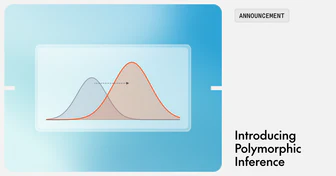
Together AI Blog5050Together AI发布Polymorphic Inference技术,通过AI智能体持续编译优化开源模型推理性能,以应对模型发布加速、架构多样化、工作负载和硬件平台快速变化带来的挑战。该技术使推理系统能够根据动态环境快速适应,例如在80%的OpenRouter流量来自近三个月发布的模型背景下,实现接近硬件极限的性能。
Together AI Blog精选7575Together AI 发布了 Together Compiler(TKCC),利用高吞吐智能体持续为推理引擎生成优化方案,在 24 小时内于 Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash 等前沿开源模型上实现 1.3-3x 的 TPS 提升。
推荐理由: 原文给出了持续编译在多个前沿模型上的吞吐提升和引擎启动耗时对比,可据此判断推理优化流程的变化。
 Ai2 Blog
Ai2 获得谷歌组织千万美元三年资助,与谷歌研究合作开发开源气候模型 NeuralGCM+,旨在提升气候预测速度与可靠性;该模型扩展自谷歌研究开发的 NeuralGCM,结合物理方程与 AI 模拟大气和海洋共同作用,模拟周期扩展至数十年,支持区域降雨和水资源变化预测,计划通过开源代码和文档促进科研社区协作。
Codex releases55GitHub Copilot 0.167.0-alpha.5 发布,该 AI 编码智能体用于任务、项目和自动化工作,提供代码审查、质量分析、安全漏洞检测等功能。
Codex releases55GitHub 发布 Copilot 0.168.0-alpha.1 版本,该版本包含代码审查、安全漏洞检测和密钥扫描等功能。
 Claude Code releases1515
Claude Code v2.1.318 添加了会话中模型开启 mods 的回答记录、跨 AWS 账户的 assume_role 功能、mod fork 的 effort 选项。
Databricks Blog3838Claude 平台原生 OpenTelemetry 数据导出到 Databricks MLflow,开发者可通过 Anthropic SDKs、Messages API 和 Managed Agents 发送原生追踪数据,利用 MLflow 调试智能体并评估变更。
 Meta Engineering3434
Meta 推出 F3 Lightning 解决 F3 合并图发布瓶颈,通过解耦功能发布与执行实现独立验证部署,采用稳定计算标识符、单一执行计划、共享内存缓冲区和密集索引映射等优化,使提取功能生产速度比 F3 提升约 3.6 倍且不增加基础设施计算成本。
 OpenAI Agents SDK releases4040
OpenAI Agents SDK v0.24.0-alpha.6 发布,支持通过 captured Turn 控制提交工作、被动事件处理、手动请求处理、转向和取消,并扩展了本地存储会话状态恢复和工具策略功能。新增了本地存储、原生输出、实验性外部作业恢复和工具选择等特性,同时更新了 API,如使用 Agent.run() 替代 Runner,以及 FunctionTool 统一回调和手动工具。
 Google Developers Blog5858
TypeSafe 的 Jev 分类器可路由任务至最经济的 Gemini 模型,50 题测试显示其准确率达 96%,优于 93.8% 的 Python 正则启发式方法;设置推理模型 MaxOutputTokens 限制并不能节省成本,反而可能中断复杂任务推理。
 Hugging Face Blog5050
StateBench 是一个长上下文状态追踪基准,测试语言模型如何保持追踪长文档中实体信息的变化。该基准包含四个难度等级,从简单的不可变赋值到复杂的依赖赋值,发现循环和混合模型比 Transformer 在直接训练任务上泛化能力更强,但前沿模型如 Gemini 3.8 Flash、Claude Opus 5.5 和 GPT-6 Sol 在长输入的复杂状态追踪中仍会失效。
AWS Machine Learning Blog2828Amazon Bedrock 现在支持在印度境内对 Kimi K3 进行推理,满足严格的数据本地化需求。客户 Ultrahuman 通过 API 调用该服务,使 AI 健康助手能处理每日超 14,000 次对话,同时将健康数据保留在 AWS 内部,成本降低 80%,多轮对话速度提升 85%。
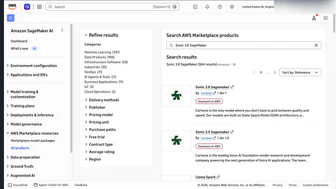
AWS Machine Learning Blog3838Cartesia 利用专为实时语音 AI 设计的状态空间模型(SSM)和 AWS 基础设施,实现亚 100ms 的文本转语音和语音转文本,支持 44 种语言语音克隆,适用于虚拟助手、客服中心等场景。Sonic 模型在约 90ms 内生成首个音频字节,Ink 模型具备原生话轮检测和噪声鲁棒性,API 接口支持实时流式输出。
AWS Machine Learning Blog3434使用 EDB Postgres AI 在 Amazon Bedrock AgentCore 上运行 Strands Agents,通过查询语义层回答客户 360 (C360) 问题。
AWS Machine Learning Blog2424Gen Digital 为 Norton Revamp 平台开发了 AI 策展新闻引擎,通过 Amazon Bedrock AgentCore Web Search 实现实时内容 grounding。
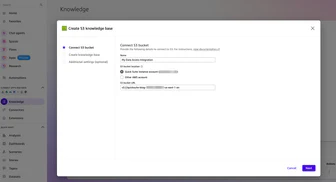
AWS Machine Learning Blog3232Amazon Quick 通过连接 Amazon S3 和创建知识库整合结构化与非结构化数据,用户可使用单一对话式 AI 代理查询。该解决方案包含数据层(存储在 S3 的非结构化内容和作为语义数据集的结构化数据)、工作空间层(将数据类型整合到单一工作空间)和代理层(自定义聊天代理链接到工作空间并返回组合响应)。