AWS Machine Learning Blog3838
Smartsheet MCP on AWS 推出通用模型上下文协议 (MCP) 服务器
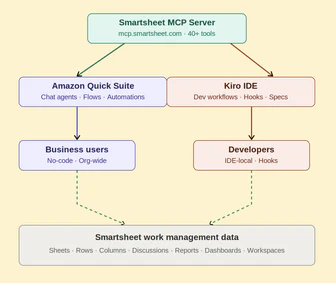
Smartsheet 推出通用模型上下文协议 (MCP) 服务器,使 AI 助手能通过标准化协议读写管理 Smartsheet 数据;支持 Amazon Quick 和 Kiro 连接,Quick 供知识工作者和运营团队自然语言查询更新 Smartsheet,Kiro 让开发者能参考项目规格和更新任务状态,无需离开编码环境。
AWS Machine Learning Blog3838Smartsheet 推出通用模型上下文协议 (MCP) 服务器,使 AI 助手能通过标准化协议读写管理 Smartsheet 数据;支持 Amazon Quick 和 Kiro 连接,Quick 供知识工作者和运营团队自然语言查询更新 Smartsheet,Kiro 让开发者能参考项目规格和更新任务状态,无需离开编码环境。
 Amazon Science
亚马逊与 AVERI 合作对内部安全评估数据集进行独立审查,验证了评估流程的全面性、多样性及低污染风险,但也发现语言风格、攻击复杂度、评估时效性等方面可改进。亚马逊已根据反馈更新测试集、引入难度分级框架、建立季度审查机制并扩大语言覆盖范围,此举被视为评估 AI 安全流程质量的最佳实践。
 Databricks Blog
Databricks 推出 Agent Memory,通过存储关键事实、偏好和流程提升智能体质量、降低成本和延迟,支持在 Lakebase 上运行,目前处于 Beta 版本。Agent Memory 基于 Databricks 最新内存研究,采用 MemCurrent 架构,在内部基准测试中使智能体任务通过率提升三倍,同时减少 31% 的 token 使用量。
 Claude · YouTube2525
Anthropic 工程师 Doug 分享在站会与发布评审中使用 Claude Docs 的方法;Claude 在文档中协同工作,自动提取数据、验证论断并响应评论问题;该工具专为团队协作设计,支持多人实时编辑与智能分析。
 OpenAI Alignment Blog5050
OpenAI 推出互补指标 g-mean² 以提升模型可监控性评估。g-mean² 通过行为标签和监控预测计算 TPR 和 TNR,但无法解决不同模型任务混合差异和部署风险问题。新指标包括对齐共享实例的配对匹配指标、模拟监控拒绝输出的后控制集成指标,以更全面评估模型部署风险。
 Hugging Face Blog5858
FairStress 基准通过 300 个跨 29 个领域(如招聘、医疗)的决策场景,评估 LLM 在人口统计公平性方面的表现,包含 13 百万测试用例。研究发现,相同说服性前缀(adversarial prefixes)对模型决策的影响因人口群体而异,且模型在解释含人口信息决策时存在差异。
 PyTorch Blog3535
PyTorch Foundation 宣布新增九位成员,包括 Nebius、Nscale 和 Shopify,强化其在开源 AI 发展中的核心地位,加速生态突破。新成员的加入凸显了 PyTorch、vLLM、DeepSpeed 等项目的生态重要性,推动 AI 研究与商业应用的融合。
PyTorch BlogNebius 加入 PyTorch 基金会成为白金会员。该公司为开发者和企业提供从数据、模型训练到生产部署的 AI 云平台服务。Nebius 已支持 vLLM 用于开发、测试和基准测试,包括 DeepSeek R1 等大型模型的节点工作,其开源工作已整合到 PyTorch 生态系统中。
Hugging Face Blog5858ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
 Sakana AI
 举办第二次工程师开放日,涵盖五个职种,介绍各部门工作内容,展示金融和防务领域应用,强调AI主权战略及产品线扩展。
 Mistral AI
 推出 Voxtral 3,包含 50+ 语言实时多步对话的尖端语音模型和语音代理 SDK,其语音转文本模型 Voxtral Small Transcribe 3 在 FLEURS 45 基准中 Forced WER 0.9%。
 IBM Research Blog
llm-d 项目宣布发布 1.0 版本,这是一个 Kubernetes 原生的分布式推理服务网络,支持在任何加速器上、任何云中部署任何模型的推理栈。该版本增强了多租户服务质量、零停机操作和智能体感知服务,以在常见生产操作中实现持续性能。通过前缀缓存感知路由和 KV 缓存卸载等技术,llm-d 1.0 可捕获 97% 的可用缓存重用,降低大规模 AI 服务的成本。
 Microsoft Official Blog
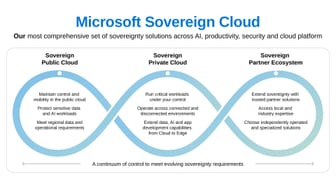
Microsoft 发布 Sovereign Cloud 新阶段,通过 Sovereign Public Cloud、Sovereign Private Cloud 和 Sovereign Partner Ecosystem 提供分级控制选项,满足不同工作负载的数字主权需求。
 Gemini CLI releases77
Gemini CLI v0.66.0-nightly.20261020.g76e4d7c04 发布,修复了视口刷新时保留终端滚动回溯的 UI 问题,以及解码流式 Node HTTP 活动块的 CLI 问题。
Hugging Face Blog5858AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
 Google Developers Blog
Google发布原生PyTorch后端的vLLM和SGLang推理引擎,支持TPU并优化生产级服务;vLLM-TorchTPU在SemiAnalysis InferenceX基准测试中实现175B参数模型每百万token成本2.01美分,行业领先。
 Anthropic Research
Claude 在 64 小时内自主生成 318,484 个蛋白质设计并筛选 180 个用于测试,与 Adaptyv Bio 和 Twist Bioscience 合作实验验证 211 个设计,其中 17 个符合结合标准,所有设计数据已公开。专家认为这是针对蝎子神经毒素的首次 AI 设计尝试,可能加速对忽视疾病的药物发现。
 vLLM Blog
vLLM TorchTPU (vllm-torchtpu) 发布,可在 Google Cloud TPU 上运行 vLLM,支持 Pallas 内核的注意力、Mixture-of-Experts 和量化矩阵乘法,保持 vLLM 体验不变,支持六维并行,推荐 TPU v7x (Ironwood)。
Google Developers BlogMeta 的 TorchTitan 集成 TorchTPU 使 PyTorch 模型可在 Google Cloud TPU 上原生训练,仅需少量代码更改。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
Anthropic ResearchAnthropic 使用 Claude 分析 25 个开源项目(逾 500 万行代码),发现 493 个安全问题。Claude 在 11 个受保护项目中识别出 191 个未授权可达的代码点,包括 93 个默认配置下可访问的预认证表面、37 个认证前执行代码或记录状态的位置,以及 61 个导致预认证控制被管理员配置弱化的配置组合。
Google Developers BlogCoral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。
Google Developers BlogArm 利用 Google AI Edge Model Explorer 的分层图可视化和插件架构,开发了支持 TOSA、VGF 和 PTE 等格式的开源适配器,帮助开发者更便捷地检查边缘模型转换流程。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
Claude · YouTubeClaude 推出 Claude Dashboards 和 Claude Motion,前者在所有付费计划中支持将数据平台或 CRM 数据实时转化为仪表盘,后者在 Team 和 Enterprise 计划中支持将报告或图表生成动画解释视频,两者均以代码形式生成无需视频模型,可修改内容后导出 MP4 或编辑。
 Meta Engineering
GenRecs Tokenization 通过将广告、产品等项用稳定语义词汇表表示,结合 Meta 生成式广告模型(GEM)和自适应排序模型,为广告主带来 0.35% 的转化率提升。该技术利用预训练大模型的世界知识,使推荐系统能理解新项目或无历史交互的用户偏好,并通过共享概念加速学习、实现跨活动迁移、随大模型规模提升性能,形成性能改进的反馈循环。
Meta EngineeringMeta工程师通过构建一个1,300行的精简路由器,将20+工作流分配给14个专业AI代理,路由器自身不执行任何领域工作,显著提升了数据管道代理的效率和准确性。
Sakana AI5555Sakana AI 提出了‘QD-Rec’,将候选与假设的组作为推荐单位,通过生成AI参考过去的优秀假设来生成新的假设的循环,积累高质量的多样化推荐。在并购、客户定位、论文推荐方面进行了实验,在许多设置中平均评估都很高,构建了规模较大的推荐集合。
 LangChain Blog
Nu公司在开发AI健康教练Nu时,优先构建了评估标准以避免越界医疗诊断,采用LangGraph框架和LangSmith工具,通过按类别评分的LLM裁判和开放式行为测试,确保系统在满足健康指导需求的同时符合监管要求。评估框架针对单一回复和完整对话分别设计,支持在两个前沿模型提供商间快速迁移,安全探针和守门节点实时审查对话内容,确保产品始终处于合规边界内。
Meta EngineeringMeta 完成了 Prometheus 超级集群的首阶段建设,该集群计划扩展至约 100 万个 GPU,采用闭环液体冷却技术,目前运行 Muse 大型语言模型。
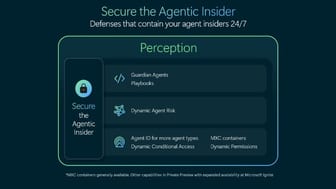
Microsoft Official BlogMicrosoft 发布 Project Perception 系统,通过红蓝绿智能体团队实时监控企业内部智能体行为,动态计算风险并实施确定性控制。该系统利用新网络安全栈,为智能体分配身份、容器和政策权限,并持续监督每项行动,提供实时响应和可追溯性,使防御者能以与攻击者相同的速度运作。模型透明化是下一步关键,需深入理解智能体意图与任务目标的一致性。
IBM Research Blog2222Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
 腾讯混元 · Hugging Face 新模型
Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
vLLM BlogvLLM 通过异步准备和 NIXL EP 技术,将 DeepSeek V4 Pro 从 16GB200 到 20GB200 的扩展停机时间缩短至 0.82 秒,从 20GB200 回缩至 16GB200 的停机时间缩短至 1.96 秒。
Google Developers BlogLiteRT Tensor API 发布,支持开发者以 C++ 在边缘设备原生编写和优化模型,实现跨平台(CPU/GPU/NPU)部署,无需转换脚本。开发者可完全控制计算图结构并直接加载模型权重,通过共享加速器缓冲区实现零拷贝数据流转,同时为 AI 编码智能体提供构建模块。
Hugging Face BlogTorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
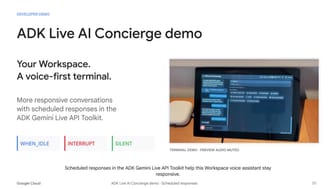
Google Developers Blog使用 ADK 和 Gemini 3.8,通过流式工具和异步函数实现非阻塞语音交互,将销售报告工作流的首次响应时间从 14.4 秒缩短至 1.2 秒,支持零静默、进度更新和并行对话。
 MiniMax News
MiniMax M3.1 Flash 正式推出,相比前代在线推理速度提升近三倍、成本降低 70%。该模型在复杂智能任务(cowork)、计算机使用、软件开发和网络安全等基准测试中表现优异,自动化任务排名 AutomationBench-AA 前列,DeepSWE v1.1 得分 73.7%,OSWorld V2 和 ALE 分别得分 61.7 和 29.6,CyberGym 得分 82%。
 Ollama Blog
Cloudflare 的 27B 多模态决策模型 Clef 已登陆 Ollama 云平台,用户可本地运行或使用云端服务。Clef 将状态和类型化问题模式转化为决策,支持文本和图像输入,兼容 Jev 和 System One API,基于 Qwen3.8-27B 微调并采用 Apache 2.0 许可证。在 Cloudflare 决策指数评测中,Clef 优于 Jev 并在多数基准测试中表现领先。
 Together AI Blog
Together AI 推出 Post-Training 服务,支持通过强化学习和监督微调构建定制模型,无需复杂基础设施。该服务提供灵活的训练循环定义能力,并优化底层系统与基础设施以提升模型质量与训练速度。支持 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B 等主流开源模型,运行在专属 GPU 资源上,确保高效且数值一致的训练。