Hugging Face Blog
Hugging Face 介绍 TorchNeuron 在 AWS Trainium 上的系统级性能分析
Hugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
Hugging Face BlogHugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
Hugging Face BlogQwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
 NVIDIA Blog精选6262
NVIDIA 扩展其开放模型家族,覆盖语言、机器人、生物和量子计算,包括新的 Nemotron 3.5 Super VL 与 Nemotron 3.5 Bolt。
推荐理由: NVIDIA 一次性铺开语言、机器人、生物、量子四条线的开放模型,读者可据此判断其开源生态的覆盖范围。
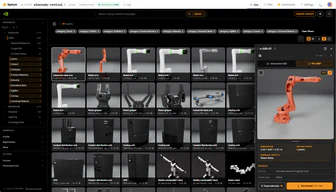
Hugging Face Blog5858NVIDIA 在 Hugging Face 上线 SimReady Central Library,汇集 2000 多个可直接用于仿真的 OpenUSD 资产,覆盖机械臂、夹爪、仓储设备、机架和冷却设施,免费且无需申请即可使用。
Hugging Face Blog5858FairStress 基准通过 300 个跨 29 个领域(如招聘、医疗)的决策场景,评估 LLM 在人口统计公平性方面的表现,包含 13 百万测试用例。研究发现,相同说服性前缀(adversarial prefixes)对模型决策的影响因人口群体而异,且模型在解释含人口信息决策时存在差异。
Hugging Face Blog5858ALTK-Evolve 使用 GPT-4.1 学习并应用客户服务剧本,在 τ²-bench 客户服务代理基准测试中超越零售领域所有零售条目,得分达 67.5% Pass^4,且无需更新模型权重。该模型基于基本 ReAct 代理和 GPT-4.1,通过分析任务尝试并使用 GPT-4.1 将成功与失败蒸馏为简短行为规则,然后将这些指南添加到代理的系统提示中,无需权重更新或人工标注。
Hugging Face Blog5858AnyLanguageModel 1.0 发布,一年支持苹果平台本地模型进展。新增支持 OpenAI Chat Completions、Anthropic Messages、Google Gemini 等云端模型,本地模型支持 llama.cpp、MLX、Core ML,工具调用与引导生成功能扩展。云端模型具备本地模型相同功能,API 密钥支持闭包动态获取。
Hugging Face Blog精选6262Hugging Face 的 PyTorch 团队介绍 PyTorch 2.15 在 MPS 后端的更新,新增 torch.float8_e4m3fn 张量与 F.scaled_mm,FP8 张量占用为 BF16 的一半。
推荐理由: 原文给出 MPS 后端在 FP8、MoE 解码和显存占用上的具体数字,可据此判断 Mac 本地跑模型的实际变化。
Hugging Face BlogHugging Face 发布 TorchTPU,使 TPU 成为 PyTorch 的原生后端设备。Transformers、Diffusers 和 Kernels 现可直接在 TPU 上运行,用户只需从 Hugging Face Hub 选择模型,指定 device_map="tpu" 即可。
 腾讯混元 · Hugging Face 新模型
Tencent 混元发布的 Hy-Memory-30B-A3B-GGUF 模型量化文件采用 imatrix 校准和 MoE 感知的混合精度量化方案,在 llama.cpp 上实现高效本地推理,其中 ~8 GB 的 expert-mixed 构建文件大小降至约 24.71 GB,性能仅比 Q6_K 下降 1.53%。
Hugging Face BlogTorchNeuron 为 PyTorch 在 AWS Trainium 提供新原生后端,Transformer、Diffusers 和 Kernels 均原生支持,使在 Trainium 上运行模型和在 HF Hub 分享模型变得前所未有的简单。
 LangChain Deep Agents releases1717
LangChain Deep Agents 发布 0.1.86 版本,新增 NVIDIA OpenShell 作为沙盒提供者,修复了多个 Bug,包括改进别名匹配、准确报告工作区拒绝、替换重复线程恢复错误、在调回提示时替换聊天输入、在页脚显示过期提示缓存、在 Groq 工具限制时提供可操作错误、比较有效解释器权限等。
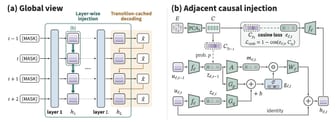
腾讯混元 · Hugging Face 新模型混元发布 Qwen3-8B-DSpine-b16,采用并行草稿与深度条件注入的推测解码技术,在 Qwen3-8B 上实现 10.55 的平均接受长度分数。模型支持 8192 token 上下文长度,使用 bfloat16 数据类型和 fa3 注意力后端,安装需 git clone 并 pip 安装,通过 sglang serve 运行。
 Mistral AI · Hugging Face 新模型
Mistral AI 发布 Timestral-123M 时间序列基础模型,参数量 123M,采用 patch-based Transformer 架构,上下文长度 32,768 时间步,单次预测可覆盖 1,024 时间步,输出 21 个分位数。该模型在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,并采用 Modified MIT 许可证。
Mistral AI · Hugging Face 新模型Mistral AI 发布 Timestral-28M 时间序列基础模型,含 2800 万参数,采用基于 patch 的 Transformer 架构,上下文长度达 32,768 时间步,单次前向预测范围 1024 时间步,在 GIFT-Eval、TIME 和 fev-bench 评测中实现零样本预测的最优精度,模型已开源并采用 Modified MIT 许可证。
 Anthropic Newsroom精选6060
Anthropic 宣布已开始向非营利机构 METR 的一个团队提供接近员工的内部访问权限,用于评估其前沿模型风险,METR 将公开发布评估结果。Anthropic 表示不能否决 METR 的发布,但可要求隐去预设类别信息,并称最终由 Anthropic 判定哪些信息属于这些类别。
推荐理由: 原文公开了三级评估权限的具体划分和 METR 的发布权边界,可用来对照其他前沿实验室的第三方评估安排。
Mistral AI · Hugging Face 新模型Mistral AI 发布 Timestral-5M 时间序列基础模型,5M 参数版本支持零样本预测,上下文长度达 32,768 时间步,单次前向预测可覆盖 1,024 时间步,输出 21 个分位数。在 GIFT-Eval、TIME 和 fev-bench 评测中,Timestral-209M 实现零样本预测最先进精度,所有 Timestral 模型在其参数规模下均优于其他模型。
 Qwen · Hugging Face 新模型
Qwen/Qwen-Image-2.1-PE-I2I 发布,一个 7B 参数的统一文本到图像生成与编辑模型,包含 32 层单流 DiT 架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并具有 10 张参考图像编辑能力。
Qwen · Hugging Face 新模型Qwen/Qwen-Image-2.1-PE-T2I发布,一款7B参数的统一文本到图像生成与编辑模型,包含32层单流DiT架构,支持生成常规或透明图像、编辑透明图层、提取照片主体,并可通过圆形、涂鸦标注或独立掩码进行局部编辑。其文本到图像提示词重写模型Qwen3.5-VL 9B可将多语言请求转化为详细英文提示词并推荐宽高比。
 DeepSeek · Hugging Face 新模型
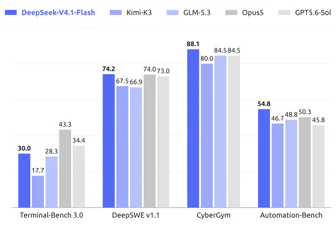
DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,支持高达一百万 token 的上下文,原生处理图像和文本并自回归生成文本。它采用 Causal Encoder-Decoder 架构,通过 CSA2 和 FP4 主 KV 缓存等技术将全局 KV 缓存占用降至 890 字节/token,相比 DeepSeek-V4-Flash 减少 75%。
DeepSeek · Hugging Face 新模型DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。
 Moonshot AI · Hugging Face 新模型
Kimi K3 是 Moonshot AI 发布的 2.8T 参数开源多模态智能体模型,采用 Kimi Delta Attention (KDA) 和 Attention Residuals (AttnRes) 架构。
 MiniMax · Hugging Face 新模型
MiniMax-M3-MXFP8 是一款拥有 1M 上下文窗口、约 428B 参数和 23B 激活参数的原生多模态模型,通过 MiniMax 稀疏注意力机制(MSA)实现 9 倍预填充和 15 倍解码速度提升。该模型在长时程智能体基准中表现领先,支持三种推理模式,可通过 Hugging Face 下载并使用 SGLang、vLLM 或 Transformers 框架进行部署。
 ByteDance Seed · Hugging Face 新模型2525
ByteDance Seed/TaskMem 模型发布,参数规模 31B,使用 BF16 张量类型,但未部署任何推理提供商。
ByteDance Seed · Hugging Face 新模型2828ByteDance Seed/SimArt 模型预训练权重发布,包含用于生成关节式 3D 对象结构(URDF 文件)的多模态大语言模型(MLLM)权重,以及用于编码解码 3D 零件几何形状到离散潜在空间的稀疏 VQ-VAE 模型权重。
 LangChain Blog
Stripe、Ramp 和 Coinbase 等公司已独立开发内部编码智能体,它们采用隔离云沙盒、精选工具集、Slack 首次调用、丰富启动上下文和子智能体编排等相似架构模式。