跳到正文
实时
11月12日周四
  1. vLLM Blog60

    vLLM-Omni 在 NVIDIA Vera Rubin 上支持 MiniMax H3-Image,4K 生成 0.87 秒

    vLLM-Omni 团队将 MiniMax H3-Image 接入 NVIDIA Vera Rubin,四卡 SP4 配置下原生 4096×4096 文生图短提示词基准中位延迟 0.87 秒,四副本 SP1×DP4 吞吐达 6115 张/小时。
    推荐理由: 原文给出 H3-Image 在 Vera Rubin 上的实测延迟、吞吐与跨硬件部署配置,可据此判断 4K 图像生成的部署成本。

  2. AWS Machine Learning Blog

    OpenAI Codex 在 Amazon Bedrock 上的部署实践

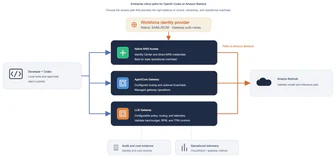
    开发者通过 Amazon Bedrock 使用 OpenAI Codex 进行代码探索和工程工作。Amazon Bedrock 支持 Codex 推理,并可与 AWS 身份、IAM 和可观察性实践集成。推荐从 Native AWS Access 开始小规模试点,使用 GPT-5.6 Sol 进行验证,通过 IAM Identity Center 进行身份认证,并配置模型权限和观测目标。

  3. AWS Machine Learning Blog38

    AWS Generative AI Innovation Center 提供 23 件生产级可复用资产加速生成式 AI 交付

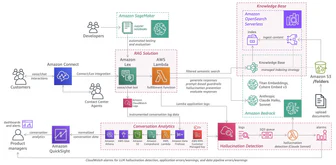
    AWS Generative AI Innovation Center 提供 23 件生产级可复用资产,包含 RAG 管道、文档处理器等,可缩短开发时间至数周,DoorDash、Lyft 和 Ricoh 等公司使用后实现测试能力提升 50 倍、工程时耗减少 90%、部署周期从数月压缩至数周。这些资产已通过安全审查并支持持续维护,解决了因缺乏单一事实源、质量信号和复用文化导致的重复开发问题。

  4. Apple Machine Learning Research

    加权状态汤对于高效的长期上下文检索

    Weighted State Souping 提出查询依赖权重来组合缓存的 State 状态编码,在单跳和多跳文档问答、寻针式检索、变量跟踪及工具使用等任务上显著提升长上下文性能。该方法可适配为高效稀疏变体,实现近常数编码成本,同时保持(有时提升)性能。

  5. Apple Machine Learning Research

    评估评估者:调查 LLM 判官在个性化写作风格评估中的表现

    研究人员评估了大型语言模型(LLM)判官在个性化写作任务中的表现,发现判官质量与 MMLU 测量的通用 LLM 能力相关性较弱(Pearson’s ρ ≤ 0.2),且表现受写作任务和评估标准(如通用帮助性 vs 风格个性化)影响。LLM 评估器在成对比较中比独立评分响应时更一致且表现更佳,而“最强”LLM 并未最可靠地复现人类评估,可能因对人类标注者和较弱 LLM 忽略的细微细节过度敏感。

  6. Claude · YouTube42

    Claude Code 中 Fable 5.2 与 Opus 的使用场景选择

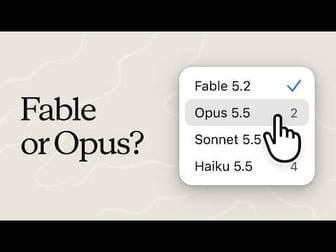
    Claude Code 发布 Fable 5.2,用户需根据任务类型选择 Opus 5.5、Fable 5.2、Sonnet 5.5 或 Haiku 5.5,或跨模型分配任务;各模型可用性及使用限制因订阅计划而异。指南建议在复杂编码与知识工作、开放性技术任务、低成本限定工作等场景下分别选用对应模型。

    同一件事 · 3 家

    各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。

  7. Meta Engineering40

    Meta 打造 Intelligent Delivery 系统:通过 AI 优化计算资源分配提升广告排序性能

    Meta 的 Intelligent Delivery 系统通过 AI 优化计算资源分配,自 2017 年以来为广告排序性能额外提升约 10%。该系统包含预测计算边际效用的 Resource Core Model(6B 稀疏参数+20M 密集参数)、跨系统资源迁移的多层机制,以及利用智能体 AI 持续检测响应系统变化的框架。

11月11日周三
  1. Databricks Blog58

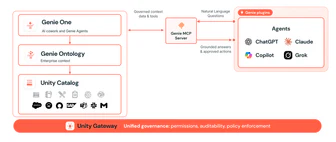
    Databricks Genie Ontology 的企业上下文层为 ChatGPT、Claude、Microsoft Copilot Cowork 和 Grok Bot 带来业务理解

    Databricks 发布 Genie Ontology 企业上下文层,结合受管定义与持续学习的组织知识,为 AI 智能体提供业务理解能力。Genie 插件支持 ChatGPT、Claude、Microsoft Copilot Cowork 和 Grok Bot,使团队能在 Databricks 中维护业务上下文并跨多个智能体使用。

  2. 蚂蚁 inclusionAI · Hugging Face 新模型

    inclusionAI/ZoomGain-4B 发布:基于全局到局部视觉感知差距的细粒度视觉监督模型

    inclusionAI 发布了 ZoomGain-4B 大语言模型,在 ZoomGainBench 上取得 61.08 分,并在多个细粒度感知和通用感知基准测试中表现优异;模型基于从全局图像细节中挖掘的全局到局部视觉感知差距构建监督,支持英文和中文问答,可通过 Hugging Face 下载。

  3. Hugging Face Blog

    Tether AI Research 推出 0.8B 参数 BotPsy 模型,用于设备端智能助手和代理工作流

    Tether AI Research 推出 0.8B 参数的 BotPsy 模型,基于 Qwen3.5-0.8B 构建,专为函数调用和代理工作流设计,适合设备端部署。BotPsy 在 6 项工具使用和代理基准测试中优于所有 ≤1.2B 参数模型,包括 Qwen3.5-2B-Think,并在 5 项测试中得分最高,速度提升 2.5 倍,推理效率提升 3 倍。

  4. AWS Machine Learning Blog40

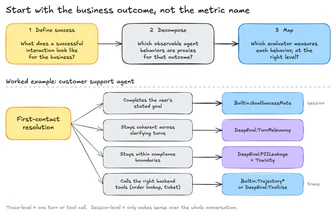
    Amazon Bedrock AgentCore Evaluations 如何使用内置、DeepEval 和 AutoEval 评估智能体

    Amazon Bedrock AgentCore Evaluations 提供内置、DeepEval 和 AutoEval 三种评估器评估智能体。内置评估器由 AWS 开发和测试,覆盖常见维度;DeepEval 和 AutoEval 是第三方开源库,AgentCore 在生产环境托管运行。评估过程需先定义业务成功标准,拆解为可观察行为,再映射到合适的评估器层级。

  5. OpenAI Alignment Blog

    GPT-6 Astra 的 CoT 监测能力受预训练、架构、强化学习和模型生成数据的影响

    GPT-6 Astra在非对抗设置中观察到CoT监测能力下降,对抗测试中CoT逃逸能力增强,且无CoT能力显著提升。预训练中,无CoT能力随基础模型困惑度降低而提高,架构影响有限,强化学习增强CoT控制能力,模型生成数据微调可传递CoT控制能力。模型困惑度与无CoT能力、控制能力呈正相关。

  6. LangChain Blog

    Workday 如何用 LangGraph 和 LangSmith 构建 AI 智能体平台

    Workday 利用 LangGraph 进行智能体编排、LangSmith 实现追踪与评估,在 2025 年以 4 人团队将原型开发时间从 5 个月缩短至 1 天内完成,并支持生产环境部署。其 Python SDK "Workday LangChain" 封装 LangChain 基础组件并通过内部服务(含 LLM 网关、RAG 检索)路由,同时满足企业级安全合规要求。

  7. AWS Machine Learning Blog

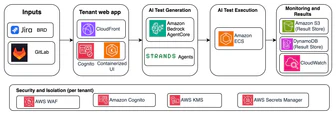
    TCS 如何使用 Amazon Bedrock AgentCore 构建 Agentic 测试编排器

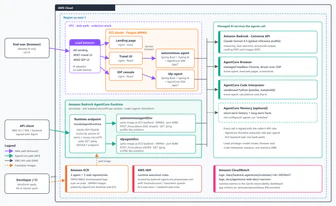
    TCS 为 BFSI 客户构建了 Agentic 测试编排器,通过 Amazon Bedrock AgentCore 将需求转化为可执行的受控测试,将测试分解为专用任务并使用各自代理、工具和验证规则执行,同时满足项目特定上下文、API 和浏览器 UI 测试、租户级安全隔离以及可重复的测试路径要求,显著提升测试吞吐量并让工程师专注风险分析和探索性测试。