Google AI Blog
Gemini Intelligence 新功能登陆更多设备
Gemini Intelligence 现在登陆更多设备,包括摩托罗拉签名 27 和 Pixel 10。新功能将扩展这些设备上的能力,帮助用户完成更多任务。Create My Widget 即将推出,用户可通过提示词创建个性化小部件;任务自动化功能将扩展至英国、印度和日本。
Google AI BlogGemini Intelligence 现在登陆更多设备,包括摩托罗拉签名 27 和 Pixel 10。新功能将扩展这些设备上的能力,帮助用户完成更多任务。Create My Widget 即将推出,用户可通过提示词创建个性化小部件;任务自动化功能将扩展至英国、印度和日本。
 AWS Machine Learning Blog
Trovata 通过 Amazon Bedrock 和 AgentCore 为企业财务团队部署了自主代理,将重复性操作转化为持续运行的智能工作流,客户实现每年节省超过 100 万美元成本、会计团队每天节省超过 5 小时、年度 TMS 成本降低 77%,并将财务报告时间缩短至不到一分钟。
 Google Developers Blog
Google AI Edge Gallery 今日推出设备端自动语音识别(ASR)与文本转语音(TTS)功能,可在手机和可穿戴设备上完全离线运行多语言 ASR 和自然 TTS 模型。
 Meta Engineering
Meta 开源 Triton Low-Level Extensions (TLX) 编译器,通过引入显式 warp-group 和 cluster 级别编排提升 GPU 性能,支持 RecSys 训练/推理及 LLM 预训练,在 NVIDIA 和 AMD GPU 上实现超越独立库的端到端性能提升。
Meta EngineeringMeta推出Your Algorithm工具,用户可通过自然语言编辑兴趣列表("Interested In"/"Not Interested In")实时调整Feed和Reels推荐内容。该系统使用LLM处理用户偏好并整合用户行为,通过检索、重排序和推送优化环节实现响应式调整,新兴趣内容会快速出现但不会主导推荐。
 PyTorch Blog
ExecuTorch WebGPU 后端使 PyTorch 模型无需转换框架格式即可在 WebGPU 浏览器中运行,支持 Llama 3.2、Qwen3、Gemma 3 等多种模型。
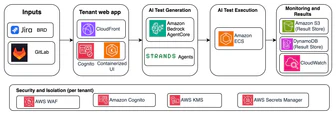
AWS Machine Learning BlogTCS 为 BFSI 客户构建了 Agentic 测试编排器,通过 Amazon Bedrock AgentCore 将需求转化为可执行的受控测试,将测试分解为专用任务并使用各自代理、工具和验证规则执行,同时满足项目特定上下文、API 和浏览器 UI 测试、租户级安全隔离以及可重复的测试路径要求,显著提升测试吞吐量并让工程师专注风险分析和探索性测试。
 Anthropic Research
Anthropic 与 Diode Computers 合作测试 Claude Fable 5.2 设计电子设备的能力,该模型能从设计到原型制作完成电子硬件。
 Claude.dev Blog同一件事 · 2 家
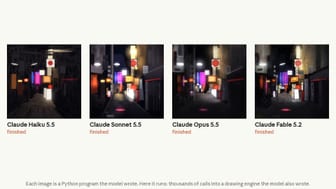
Anthropic 推出四种 Claude 模型供用户选择:Claude Haiku 5.5、Claude Sonnet 5.5、Claude Opus 5.5 和 Claude Fable 5.2。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Google Developers Blog5858Google Cloud 发布 MaxText v0.2.4,支持在 TPU 上进行长上下文训练,通过 MaxText Context Parallelism 技术,在 TPU 5p 上使 Llama 3.1 8B 模型达到 4 百万 token 长度的序列 70% 的 MFU,在 TPU 5p 和 TPU 7 上可无缝扩展至 14 百万 token
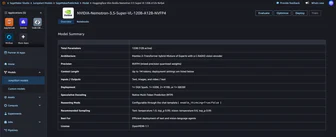
AWS Machine Learning Blog5858NVIDIA Nemotron 3.5 Super VL 已在 Amazon SageMaker JumpStart 中可用,支持图像、视频和文本输入生成文本。
 Claude · YouTube精选同一件事 · 2 家7575
Anthropic 发布 Claude Fable 5.2,称其在编码、推理和视觉方面有所改进,面向最复杂、开放式的技术工作。官方建议多数编码和知识任务从 Opus 5.5 起步,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
Claude · YouTube精选同一件事 · 2 家7575Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。
各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。
推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。
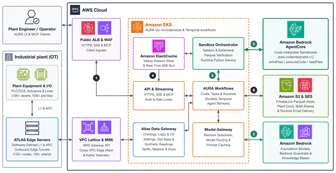
AWS Machine Learning Blog3838CrossnoKaye 通过其 ATLAS 平台和 AURA 智能体,在 Amazon Bedrock AgentCore 上实现工业物理 AI,将生产提效 11-17% 并降低能耗 21%。AURA 利用 AgentCore 的代码解释器能力,在隔离微 VM 中运行 Python 工作负载以验证数值计算,同时通过边缘集群和云优化系统实现闭环控制。
 Berkeley AI Research2222
BAIR团队在2026年11月9日至12日于德克萨斯州奥斯汀举行的机器人学习会议(CoRL)上展示多项研究成果,包括33篇主会论文、4个突破性海报、10场口头报告和7场专题演讲,其中教授Negar Mehr将发表早期职业主题演讲。会议涵盖机器人视觉语言行动模型、具身智能体、细粒度操作对齐、后见之明奖励编辑等议题。
Meta Engineering3838LLDB 通过 lldb-server 的中立加速器插件架构支持跨 CPU 和 GPU 的应用调试,将通用调试基础设施与硬件特定设备控制分离,将 CPU 和 GPU 呈现为独立的调试进程,在单一调试会话中协同工作。该架构通过插件将硬件特定调试 API 转换为 LLDB 理解的概念,支持不同架构、寄存器、内存空间和执行模型的 CPU 与 GPU 协同调试,同时保持客户端的中立性。
 OpenAI Agents SDK releases2222
OpenAI Agents SDK v0.24.0-alpha.7 发布,支持经典工作流与原生执行,新增语音和托管工具,引入持久会话存储和上下文控制。新版本默认执行策略为严格模式,需更新现有环境;捆绑模型默认推理力度提升至中等。
AWS Machine Learning Blog4242AWS 为解决 AI 应用中 LLM 代理访问企业数据湖的集成挑战,在 Amazon ECS Fargate 上推出无服务器 Model Context Protocol (MCP) 服务器。该服务器通过元数据驱动的方式实现配置化数据湖访问,无需为每个数据集编写集成代码,并支持多租户环境下的弹性扩展。
AWS Machine Learning Blog5858Amazon SageMaker Inference 现支持 GPU 分区,通过 NVIDIA 多实例 GPU (MIG) 将物理 GPU 划分为独立分区,每个分区获得固定份额的 GPU 计算单元和专用内存块,实现隔离。部署更多模型且相互隔离,并按需选择合适大小的 GPU 单元以降低成本,最大支持每 GPU 7 个分区,无需自建 Kubernetes。
 Claude Code releases2222
Claude Code v2.1.319 发布,关闭遥测或功能标志时自动模式被更改,服务器端检查被禁用;在 LLM 网关后启用服务器端检查需设置 CLAUDE_CODE_AUTO_MODE_SERVER=1。
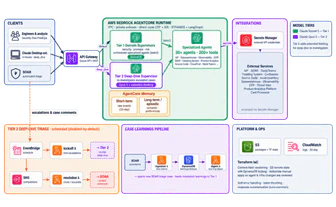
AWS Machine Learning Blog3838Greenlight Financial 每月自主处理超过 90% 的 4,000 个安全风险案例。其解决方案 Luna 使用 Amazon Bedrock AgentCore 运行,包含 30 多个专业智能体,通过 AgentCore 运行时和内存支持分层多智能体系统,实现秒级安全事件分诊,无需人工干预。
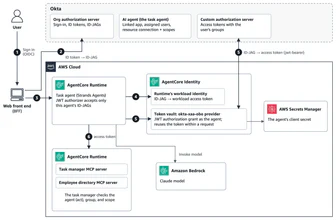
AWS Machine Learning Blog4848Okta Cross App Access 在身份提供商中管理 AI 代理的访问权限,Amazon Bedrock AgentCore 则在执行层面验证和转换授权决策。
 NVIDIA Newsroom3838
NVIDIA的开源Aerial和Sionna软件使全球开发者采用量增长10倍、下载量超100万次,被8000多个研究机构使用,支持目标语义通信使机器人任务完成时间缩短52.6%、AI接收器在干扰环境下提升60%上行吞吐量、需求预测系统降低45.6% RAN功耗、GPU加速模拟将仿真时间从3小时压缩至10-20分钟。
 Hugging Face Blog5858
Hugging Face 发布 ToyBlocks 框架,为机器人学习与评估提供受控的模拟环境。该框架支持自动生成任务与训练演示,并包含衡量机器人行为随时间变化的指标,旨在研究模型如何随更多训练数据改进,以及如何结合高级推理与精确物理控制。
 ByteDance Seed · Hugging Face 新模型
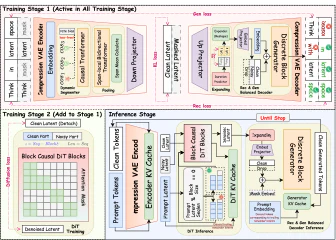
Cola2 是一个连续潜语言模型,结合动态压缩 VAE、块因果扩散 Transformer (DiT) 和跨段因果 token 解码器,动态将文本分组为语义片段,用紧凑的连续潜表示每个片段,生成潜块并实现为离散 token。
 vLLM Blog
VeRL-Omni v0.3.0 发布,将异步执行扩展到更多多模态强化学习工作负载,并将 V1 训练器设为默认选项,同时扩展了图像、视频、音频和多模态理解的后训练支持。
Hugging Face Blog精选7171NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。
推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。
 Databricks Blog5858
Databricks 与 Linux Foundation 于 2026 年 6 月宣布 Delta Sharing 升级为 OpenSharing,将共享范围从 Delta Lake 表扩展至包含 Agent 技能。
Google AI Blog精选同一件事 · 2 家7878Google 发布 Gemini Omni 1.2 Flash,并通过 Gemini API 和 Gemini for business 正式开放。原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,可按 1 秒步长指定 3 至 15 秒,720p 价格降至每秒 0.07 美元,比 1.1 下降 30%。
 Google DeepMind精选同一件事 · 2 家7878
Google DeepMind 发布了 Gemini Omni 1.2 Flash,原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,并已在 Gemini API 和 Gemini for business 全面开放。
推荐理由: 原文列出了时长、价格和参考一致性的具体变化,读者可据此判断视频生成的成本与工作流会怎样变化。
 Microsoft Research
PDD Kit 将用户意图转化为形式化规范,并验证智能体为每个输入编写的代码是否符合该规范,同时辅以测试。团队在 GitHub Next 的 Chopin 环境中使用 PDD Kit 正式验证了 Rust 编写的 Pet Store 登录逻辑,Verus 工具发现并修复了现有 Bug,证明规范下无登录 Bug。
NVIDIA Newsroom3838NVIDIA 通过全栈协同设计提升内存效率,在 GPU、CPU、网络、存储和软件各层优化内存使用。Blackwell Ultra 显卡使每 GPU HBM 容量提升约 3%,而 SemiAnalysis AgentX 上的智能体推理成本降低 30 倍。
 LangChain Blog
LangChain 探索人类反馈三原则提升智能体开发:专家判断定义质量标准,完整上下文评估,将反馈转化为可复用数据;通过 agent trace 记录用户交互与模型行为,人工标注评分并附理由,用于校准自动化评估器、改进评估标准与构建黄金数据集,形成专家知识可复用资产。
LangChain Blog5252LangSmith Bring Your Own Cloud (BYOC) 现在支持 AWS (GA)、Azure (Beta) 和 Google Cloud (Beta),用户可将追踪、评估、数据集、提示词和智能体部署保留在自选云账户中,LangChain 负责数据层管理。
ByteDance Seed · Hugging Face 新模型ByteDance-Seed/Qwen3-30B-A3B-MoE-SAE 发布,包含在 Qwen3-30B-A3B 模型第 4、30 和 46 层训练的 TopK 稀疏自编码器(k=100,2^20 潜在变量),每个 SAE 约 17.2 GB,重建方差未解释分数分别为 12.6%、25.1% 和 7.6%。
ByteDance Seed · Hugging Face 新模型5858ByteDance-Seed 发布跨层转码器(CLT)为 Qwen3-8B-Base,包含 36 层 × 32,768 潜在变量,参数量 94.2B,总大小 377 GB,支持 fp32 推理,通过联合评分所有层中的 360 个最高激活潜原来编码,解码时重建原始 MLP 输出。
 Google Research
Agile Deliberation 框架通过迭代对话协助人类定义主观概念边界,将模糊想法转化为精确的 AI 指令蓝图。该框架分为概念界定和概念迭代两阶段,通过直接反馈处理模糊图像,在 18 次 1.5 小时用户实验中显著降低用户疲劳和焦虑,使 AI 模型性能优于标准基线。
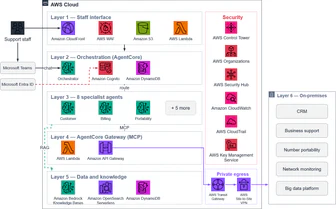
AWS Machine Learning Blog4141U Mobile 与 AWS 合作,基于 Amazon Bedrock AgentCore 开发了 AiDaH 智能客服中心,通过跨系统实时协调、链式推理和多租户安全框架,处理 150 项运营场景,关键业务工单量下降 84.5%。AiDaH 在 2025 年底启动试点,2026 年 Q3 正式上线,采用 Microsoft Teams 作为交互界面
 Ai2 Blog
Ai2 获得谷歌组织千万美元三年资助,与谷歌研究合作开发开源气候模型 NeuralGCM+,旨在提升气候预测速度与可靠性;该模型扩展自谷歌研究开发的 NeuralGCM,结合物理方程与 AI 模拟大气和海洋共同作用,模拟周期扩展至数十年,支持区域降雨和水资源变化预测,计划通过开源代码和文档促进科研社区协作。
Hugging Face Blog精选6060IBM 研究团队微调 20B 开源权重模型 Palette,采用设计师编写 JSON 简报、编码器逐页生成 pptxgenjs 代码的两角色 LoRA 方案,根据 IBM 设计语言生成幻灯片。
推荐理由: IBM 使用合成数据加检查修复闭环训练 20B 小模型制作幻灯片,提供可迁移到其他结构化产出的方法。