PyTorch Blog
TorchTitan 更新:新 SOTA 模型支持、规模化性能提升及 TitanRL 发布
TorchTitan 新增对 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 等最新 SOTA 模型的原生 PyTorch 支持。
PyTorch BlogTorchTitan 新增对 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 等最新 SOTA 模型的原生 PyTorch 支持。
 OpenAI News4545
OpenAI 提出了利用前沿 AI 强化网络防御者、加强安全防护及现代化网络安全体系的蓝图。该方案旨在提升公共机构的韧性,并强调通过民主治理框架来应对前沿 AI 的风险。
OpenAI News5050AT&T 与 OpenAI 合作,通过 LegalEdge 团队重塑法律知识获取和案件摄入流程,提升法律判断能力。
 AWS Machine Learning Blog
U.S. Hunger 通过 Amazon Quick 直接探索组织数据,实现领导者共享关键绩效指标定义,并在 Quick Spaces 中协同分析财务与非财务信息,支持其年增长500%的运营效率。
 Hugging Face Blog精选7878
NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。
 Claude · YouTube
Claude Duet 应用上线,主动提醒用户待办并持续处理任务,需用户确认后才行动;研究预览版通过候补名单向美国 Pro 和 Max 订阅者开放。
PyTorch BlogPyTorch 用户可在 AMD MI350 系列显卡上通过 FlyDSL 使用现有算子 API 加速密集和分组 GEMM、融合多头注意力、MXFP8/MXFP4 缩放 GEMM、RMSNorm 和 TopK,无需调用自定义内核
 Google Research
 发布的 AI 模型在 JAMA Network Open 上验证,其通过盲扫超声技术评估孕期周数(gestational age)的准确性。
Hugging Face BlogHugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
 Microsoft Research
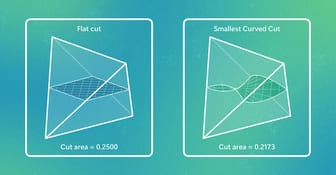
Microsoft 研究者与协作者结合新数学思想与人类指导 AI 证明高维几何与概率的核心问题 KLS 猜想,该猜想提出 31 年,被广泛视为该领域中心未解问题。AI 工具探索候选方法并执行详细推导,研究者评估、修剪并重新定向搜索,最终证明高维空间几何原则,使障碍随维度增加不再无界增长。独立研究者确认该成果,识别出关键标准,并完成机器检查的正式验证。
Hugging Face BlogQwen3-4B的专精词汇表VocabX通过聚焦每个token的成本而非频率,在不改变基础模型的情况下将推理成本降低77%。该方法针对葡萄牙语作文评分器,将输出层词汇表从约152,000行缩减至约65,000行,显著减少token分割和未使用词汇项的计算开销。
 Anthropic Newsroom5555
实验物理学家克里斯托弗·斯图布斯加入 Anthropic 的长期利益信托,他将利用数十年的宇宙学观测和精密测量科学专长。斯图布斯是哈佛大学教授,曾担任哈佛大学科学学院院长,1998年参与发现宇宙加速膨胀,获突破奖。Anthropic 联合创始人兼总裁丹妮拉·阿莫迪表示,斯图布斯的严谨和求真精神将塑造 AI 技术的未来。
OpenAI News2323OpenAI 构建了基于 LLM 的 ChatGPT 广告栈以理解对话意图并大规模投放相关广告。该架构将广告与答案分离,确保广告内容与用户需求精准匹配。
OpenAI News3232OpenAI、PerturbAI 与 Scripps 研究所合作,使用分布式 AI 智能体分析数百万脑细胞数据,发现新的研究线索。
OpenAI News5050ChatGPT 广告已扩展至 26 个新国家,超 10 万广告商使用该平台,让更多广告商在用户探索、比较和决定购买时触达目标人群。
OpenAI News5555Patch the Planet 连接安全研究员、维护者和事件响应者,帮助应对开源项目中的关键漏洞。
Hugging Face Blog5858IBM 发布了 Granite Speech 5.0 系列的三款模型,granite-speech-5.0-2b 在 390,000 小时数据上训练,支持 6 种语言互译及 2。
 蚂蚁 inclusionAI · Hugging Face 新模型3535
inclusionAI 发布 Ling-3.0-tiny 的 UBTree 技术微调版本 Ling-3.0-tiny-UBTree-B16,参数量 183.1M,结合五层 DFlash 主干和 bigram 选择器,在 GSM8K、MATH-500 等基准上实现 2.6-3.5 倍速度提升。该模型需与目标模型配合使用,UBTree 适配 SGLang 的开源版本尚未发布。
OpenAI News精选6262OpenAI与Google Cloud合作,将OpenAI前沿模型和Codex工作流接入Gemini的模型花园,并通过Google Cloud Marketplace提供
推荐理由: OpenAI 前沿模型与 Codex 工作流进入 Google Cloud 的 Model Garden,读者可据此了解跨云分发的新入口。
Hugging Face Blog5858NVIDIA 发布多变量时序预测模型 Kumo Forecast(原 NV-Tesseract Forecasting),以 MOMENT-1-large 为骨干,约 3.4 亿参数编码器加可训练预测头,编码器与嵌入层权重冻结。
 IBM Research Blog
IBM 发布 vLLM-Hook MIA 插件,在 vLLM 推理引擎中实现运行时监控与控制,速度比前身 vLLM-Hook 快 20 倍、比模型内插入代码的类似方法快 14 倍,延迟仅增加 2%-6%。该插件允许开发者实时观察和调整模型状态,如拒绝恶意提示、标记幻觉事实或编辑响应语气与准确性,同时几乎不降低性能。
 NVIDIA Blog4242
Nebius 和 Nscale 等全球科技合作伙伴计划使用 NVIDIA Vera CPU 构建下一代基础设施,以应对智能体计算的快速发展需求。Vera CPU 通过加速智能体信息检索、软件工具运行、代码执行和结果评估等任务,提升响应速度并优化数据中心计算能力,支持数千任务并行运行时仍保持高效。
NVIDIA Blog精选6262NVIDIA 扩展其开放模型家族,覆盖语言、机器人、生物和量子计算,包括新的 Nemotron 3.5 Super VL 与 Nemotron 3.5 Bolt。
推荐理由: NVIDIA 一次性铺开语言、机器人、生物、量子四条线的开放模型,读者可据此判断其开源生态的覆盖范围。
NVIDIA Blog精选6262NVIDIA 扩展开源 Agent Toolkit,新增 Agent Knowledge Foundation、OpenShell 安全运行时和 NemoClaw 蓝图等组件,让企业用自有数据定制并管控智能体。
推荐理由: 原文列出 Agent Toolkit 新增组件与多家企业落地细节,可看清企业智能体如何接入自有数据并受运行时约束。
 Mistral AI5050
Mistral 与 NVIDIA 合作将 AI 模型与 NVIDIA 加速计算和物理建模工具整合,加速工程模拟并实现闭环 AI 驱动设计。合作将推出公共基准和开放数据集,标准化物理和智能体 AI 在计算机辅助工程中的评估,并利用 NVIDIA Omniverse 进行 3D 模拟和资源创建。
Hugging Face Blog5858NVIDIA 在 Hugging Face 上线 SimReady Central Library,汇集 2000 多个可直接用于仿真的 OpenUSD 资产,覆盖机械臂、夹爪、仓储设备、机架和冷却设施,免费且无需申请即可使用。
NVIDIA Blog5555NVIDIA Confidential Computing 通过硬件根隔离和加密认证保护模型和数据执行,新增 Confidential Bare Metal 部署选项,使前沿模型构建者能在第三方基础设施上运行敏感工作负载并保留模型数据控制权。
NVIDIA Blog同一件事 · 2 家3838NVIDIA cuDSS 正式 GA,作为 CUDA-X 库把大型稀疏方程组求解迁移到 GPU,缩短仿真出结果时间并提升吞吐。Applied Materials 在 Ginestra 中实现最高 10x 加速,Dassault Systèmes 的 Abaqus 报告 8-10x 提升,ZEISS SMT 用 COMSOL 完成 EUV 光刻等离子体仿真基准提速 4x。
各家口径不同:NVIDIA博客称ZEISS SMT使用COMSOL进行EUV光刻等离子体仿真提速4倍;NVIDIA新闻室提到使用cuDSS对COMSOL进行10倍加速。
NVIDIA Blog欧洲工业领袖正利用 NVIDIA CUDA-X 和 Omniverse 库、Cosmos 和 Nemotron 开源模型,贯穿工程与制造全周期以提升生产力、加速创新。
NVIDIA Blog5858NVIDIA 欧洲合作伙伴正扩展区域计算能力,支持模型训练与推理,帮助开发者构建 agentic 和物理 AI 应用。Nscale 使用 NVIDIA DSX 平台实现 37% 更多 GPU 和 50% 更高推理吞吐量,Crusoe 开发液冷 AI 工厂支持低延迟推理,Nebius 采用 NVIDIA Groq 3 LPX 加速敏感应用。
NVIDIA Blog精选7272Google Cloud 与 NVIDIA 宣布基于 NVIDIA Vera Rubin 的 A5X 实例正式可用,下月开放并计划扩展至欧洲。
推荐理由: 原文给出 A5X 实例的可用时间、客户实测与机密计算配套,读者可据此判断大规模强化学习基础设施的落地节奏。
NVIDIA BlogNVIDIA 在 GTC Berlin 上展示了其本地 AI 硬件全阵容,RTX Spark 已上线支持 Windows PC 上的个人智能体,DGX Spark 支持开发者构建和扩展 Linux 应用,DGX Station 则为 Linux 企业团队运行前沿工作负载,Windows 版将于 12 月推出。
 Databricks Blog
Databricks AI Runtime (AIR) 已正式发布,支持开发者使用 NVIDIA NeMo、NGC 容器和 Nemotron 新菜谱在无服务器 NVIDIA GPU 上训练和微调开放模型。
Databricks BlogDatabricks 发布 AI Runtime (AIR),将托管 GPU 基础设施直接引入其平台,让客户能在企业数据所在地训练高需求模型。AIR 提供 GPU 基础设施、开发者工具和数据治理功能,支持大规模训练、快速迭代和负载安全,客户无需管理独立的 GPU 堆栈。
NVIDIA Blog精选6767NVIDIA CEO 黄仁勋在 GTC Berlin 2026 主旨演讲中宣布多项更新,包括以模块化集装箱交付的 Vera Rubin AI 工厂参考设计 DSX POD,现场部署时间可从六个月缩短到 14 天。
推荐理由: 黄仁勋在 GTC Berlin 的主旨演讲集中披露了 AI 工厂、智能体安全运行时与开源模型三条产品线的最新进展,读者可据此了解 NVIDIA 在欧洲的布局重点。
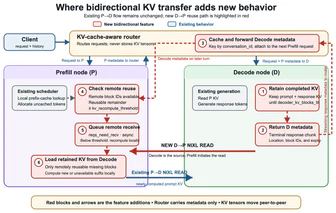
AWS Machine Learning Blog5858vLLM 的双向 KV 传输机制通过让解码节点在后续对话回合中返回先前计算的 KV 缓存给预填充节点,减少了重复计算,在 AWS EC2 P5en 实例上的多轮基准测试中将 Qwen3-32B 的 TTFT 提升了 1.6 倍,zai-org/GLM-5-FP8 提升了 3.3 倍。该功能通过扩展 NIXL KV 连接器实现,并利用 KV 缓存感知路由器协调跨对话回合的 KV 重用。
AWS Machine Learning Blog4949vLLM 引入基于推送的 NIXL 连接器,通过将后预填充传输协调和设置移出关键路径,减少时间到第一个 token (TTFT) 和每个输出 token 的时间 (TPOT),提升应用响应性。
AWS Machine Learning Blog3232Deepgram 通过 AWS Trainium2 将 Nova-3 语音识别模型部署到 PyTorch,在单个 trn2.3xlarge 实例上运行 8 个副本,处理离线批处理工作负载时每美元可处理 11-70% 更多音频,并使用 NKI 库和 Neuron Explorer/NAD 工具链进行内核级调优,提升推理效率。
AWS Machine Learning Blog5858TwelveLabs 的 Pegasus 1.5 视频语言模型现已在 Amazon Bedrock 上提供,可将长视频转换为结构化、带时间戳的元数据,支持基于用户定义标准分析整个视频并返回匹配片段的 JSON 数据,分析时长扩展至每请求两小时,无需预索引且数据保留在 AWS 边界内。
AWS Machine Learning Blog3131Amazon SageMaker JumpStart 上线以来已集成 100 多个来自 30 家提供商的新模型,涵盖 Qwen 3.8-27B、Cosmos3 系列等。