Ollama Blog5858
Ollama 推出透明按 token 定价模式
Ollama 的 Pro、Max 和 Team 计划现采用透明按 token 定价,每月包含使用额度。Pro 计划每月 20 美元(含 60 美元额度)、Max 100 美元(含 300 美元额度)、Team 500 美元(含 1000 美元共享额度)。免费计划提供少量起始模型额度,可付费按需扩展。
Ollama Blog5858Ollama 的 Pro、Max 和 Team 计划现采用透明按 token 定价,每月包含使用额度。Pro 计划每月 20 美元(含 60 美元额度)、Max 100 美元(含 300 美元额度)、Team 500 美元(含 1000 美元共享额度)。免费计划提供少量起始模型额度,可付费按需扩展。
 Dify Blog
Dify 推出全新智能体(New Agent),每个智能体拥有独立配置和生命周期,支持一次性构建后跨工作流复用。该智能体可发布为网页应用或通过 API 暴露,具备三大核心功能:通过真实任务构建与优化能力、跨工作流统一管理以减少重复维护、以及单次运行追踪和长期监控的完全可观测性。
Dify Blog7575Dify的重构Agent系统使应用和工作流能将复杂任务分发给CLI智能体,Build Mode通过聊天构建智能体,后台采用模型驱动ReAct循环和沙盒技术,企业版提供容器隔离和自定义安全策略。智能体负责任务执行,工作流负责流程编排和协调,将临时能力转化为可调度、监控的稳定运行模块。
 Qoder Blog2222
Qoder 推出全新版本,实现编程外创意实现。该版本支持上下文长度 8k tokens,速度提升 3.5 倍,价格每百万 tokens 3.5 美元,采用开源模式,通过 API 和 SDK 提供集成。
 OpenHands Blog6565
OpenHands 企业版用户现可通过 Jira Cloud 项目直接触发 AI 开发工作流,在 Jira 问题中提及 @openhands 或添加 openhands 标签即可启动工作流。
 SGLang releases
SGLang v0.5.18 发布,新增 Muse、Glimmer 等多模态模型及 LingBot-Video-MoE、LongCat-Image 等模型,Qwen3-32B 在 H100 上启动速度提升 2.38 倍至 35.6 秒,TP LMHead 带宽优化使 DeepSeek-V4-Pro B200 解码速度下降 320 微秒至 169 微秒。
Qoder Blog6565Qoder 通过独立 SOC 2 Type II 审核获得可验证保障,支持企业 AI 编码应用;企业版定价 $3/M tokens,上下文窗口 8k,支持 Agent SDK 和 Cloud Agents。
Qoder Blog6565孩子想通过 Qoder 将一周的端到端需求缩短为一天交付,构建了运行 400 个场景和 300 个智能体的 AI 平台 Zhishu。
 Microsoft AI News
MAI-Cyber-1-Flash专为安全任务设计,能高效处理90%的任务,使MDASH可用更昂贵的GPT-5.4处理10%的复杂任务,成本降低50%。Perception作为新的智能安全系统也发布,将使用MAI-Cyber-1-Flash扩展更多安全工作流。
 Factory News7575
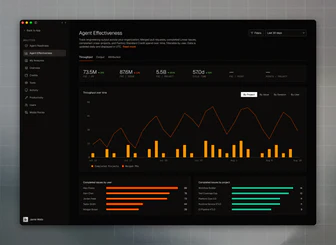
Factory 的 Agent Effectiveness 功能现已上线,将使用数据与交付周期、工作意图及已交付成果关联,帮助工程领导者了解交付加速点、机器人工作内容及使用如何映射到实际产出。该功能通过连接 Droid 使用与交付结果,提供 AI 投资回报的操作性视图,回答交付速度变化、收益集中点及新增能力是否用于优先工作等问题。
 Prime Intellect Blog
Prime Flash MoE 是一组专为 Blackwell 优化的 CUDA 内核,通过避免某些中间张量的显式创建以及在融合配置中避免激活张量的显式创建,从而显著减少内存流量。
 LangChain Blog
LangSmith Bring Your Own Cloud (BYOC) 已在 AWS 上正式提供,为企业提供可在其 AWS 账户和 VPC 中运行的托管 LangSmith 部署。
 Liquid AI Blog
MacPaw 与 Liquid AI 宣布战略合作,将 Liquid 基础模型与 MacPaw 的 Elix 和 Mnemos 技术 结合,打造首个集成设备端智能、持久记忆和原生任务执行的 Mac 助手 Eney,预计今年晚些时候推出,后续将扩展至更多产品。
LangChain BlogStripe 在一周内基于 Deep Agents 构建了公司级 AI 助手 Kai,该平台预装 Stripe 上下文并整合 1000 余项技能,通过虚拟文件系统和沙箱执行机制实现生产级部署,员工可通过单会话界面访问内部数据仓库、Slack 和 Google 套件完成数据合成、文档起草等任务。
LangChain Blog精选6262LangSmith LLM Gateway 进入公测,作为智能体与模型之间的集中治理层,统一执行花费上限、限流、模型回退和敏感数据脱敏。花费与限流可按组织、工作区、API key 和用户四级设置,命中上限时智能体收到 402 响应;回退规则可跨模型与托管商统一生效。
推荐理由: 原文列出了网关在成本、限流、回退和数据脱敏上的具体控制层级,可帮助判断生产智能体的治理该放在哪一层。
Microsoft AI NewsMAI-Cyber-1-Flash 模型在 CyberGym 评测中实现 96% 评分,成本仅为当前 MDASH 最佳方案的 50%,专为 MDASH 执行器优化。
 Mastra Blog7575
Mastra Factory 发布,一个让智能体从问题处理到软件生产的系统,支持代码编写、验证、发布、文档更新和监控,通过 GitHub、Linear 和 Slack 集成,提供类型化工作流、内存、调度、工具和可观察性功能。
Microsoft AI NewsHill-climbing MAI 模型在 GitHub Copilot 中使用 10% 更少的 token,代码接受率比 GPT 5.4 Mini 高 10%,比 Claude Haiku 4.5 高 11%,用户留存率分别高 6% 和 11%。
Dify Blog7575Dify v1.15.0发布命令行工具difyctl,使Web应用能被自动化脚本、CI和AI Agent直接调用。用户可通过`difyctl skills install`安装Agent技能,让Codex、Claude Code等智能体自动发现应用、识别参数、调用Workflows并处理暂停/恢复。
Qoder Blog6565Qoder Knowledge Engine 将工程知识转化为可重用上下文,提升 AI 代理的准确性、稳定性与执行效率。
Dify Blog6565Dify Cloud 通过统一监控和日志功能帮助 IT 团队追踪 token 使用、消息量和活跃用户,识别并优化低效流程;其模型无关特性允许在单个工作流中为不同节点配置 OpenAI、Anthropic、Google 和开源模型,按任务匹配模型以降低成本。
Qoder Blog3232Qoder 推出 Qoder Code Security,从代码第一行开始保障安全;该产品通过 Agent SDK 和 Cloud Agents 实现集成,支持多种使用方式。
Dify BlogQubrid AI 通过单一插件为 Dify 构建者提供对 DeepSeek、Kimi、Qwen、MiniMax、GLM 等领先开源和前沿模型的统一 API 访问
Qoder Blog7575阿里 Qoder 新模式 CaseOne 段落召唤 13 个 "程序员" 通过自动拆解需求并分派多个专家 Agent 并行开发,仅需一段文字即可构建和重构个人博客。
Qoder Blog3030Qoder 专家模式通过 30 分钟并行工作,帮助用户快速组建多智能体专家团队并交付合并主分支功能。该模式支持创建 AI 员工,并可通过 Agent SDK 和云代理集成。
Qoder Blog6565海信通过 Qoder 构建了完整的 AI 原生开发系统,新系统开发效率提升 3-4 倍。
Microsoft AI NewsMAI 的音频模型 Ode Poetry 通过提问推荐诗歌并播放真人朗读录音,为全球用户提供数字诗歌体验。该系统使用 MAI-Transcribe 实时理解用户语言,在 FLEURS 基准测试中达到 4.86% 的最低词错误率;MAI-Voice 则能高保真复现威廉·西格哈特的独特嗓音。系统结合威廉的文学分析经验,通过定制逻辑和工具调用推荐诗歌,并经迭代优化实现安全、高质量的用户体验。
Dify BlogDify 发布了首个官方命令行工具 difyctl,支持在终端、脚本、CI 流程或 Claude Code、Codex、Cursor 等智能体中调用 Dify 应用和工作流,实现自动化和集成。difyctl 跨 Enterprise、Cloud 和 Community 版本,提供统一命令集,无需自定义集成代码。支持通过 Dify 账户或外部 SSO 登录,并可在 Enterprise 版本中使用。
Prime Intellect BlogPrime Intellect 宣布获得 1300 万美元 A 轮融资,由 Radical Ventures 领投,NVIDIA Ventures 等参与,总融资额超 1500 万美元用于构建开放超级智能栈。
 Cognition Blog
Devin Fusion 在新编码基准 FrontierCode 上以 60% 更低成本保持前沿和 Fable 5 级性能,主要通过运行前沿模型与成本效益型“助手”模型并行的双代理架构实现。该架构通过动态中会话路由和深度调优的交互模式,避免基准测试过拟合并提升任务通用性,在实施导向会话中效率提升最显著。用户可通过 app.devin.ai/signup 试用预览版。
Qoder Blog1717Eccang 利用 Qoder 打破技术团队与非技术团队的界限,将员工从'工具使用者'转变为'智能体管理者'。Qoder 支持跨团队协作,助力企业实现研发与运营的智能化升级。
Dify Blog通过与 MongoDB 和 Voyage AI 的合作,Dify 在 Dify Marketplace 发布了 MongoDB Atlas 和 Voyage AI 插件,使 Dify 构建者能够直接连接 MongoDB 数据,使用 Atlas Vector Search 进行语义检索,并通过 Voyage AI 嵌入和重新排序来提高结果质量。
Qoder Blog5555Qoder Terminal Sandbox 发布,为 AI 智能体提供 Windows、macOS 和 Linux 跨平台原生命令隔离执行环境,支持有界智能体运行。
Factory NewsDroid 在每个非草稿 PR 中运行基于 STRIDE 的安全审查,发现漏洞会附带严重程度、CWE 参考编号、解释和修复建议,并作为内联评论直接发布在代码差异上。该功能已在生产代码库中运行,发现 CVE-2026-42876 等漏洞。Droid 通过构建轻量级威胁模型、扫描漏洞并验证候选发现来过滤误报,每个 PR 只生成一个汇总评论。
Prime Intellect BlogPrime Intellect Lab 平台全面支持在 Nemotron 3 Ultra(550B参数 MoE 模型)上进行后训练,提供黑井 B200/B300 的托管 RL 训练、2500+ 开环境及 SWE-bench Verified 等基准测试。
 ByteDance Seed · Hugging Face 新模型2525
ByteDance Seed/TaskMem 模型发布,参数规模 31B,使用 BF16 张量类型,但未部署任何推理提供商。
Prime Intellect Blog7575Prime Intellect 发布 Hosted Evaluations,提供可扩展基础设施供用户在自评估环境中测试模型。该服务支持在 Environments Hub 已有的数百个社区环境上运行评估,用户可通过平台、CLI 或 .toml 文件启动,支持 GPQA、SWE-bench 等基准测试,结果可发布至对应排行榜并透明展示。此举旨在解决现代评估对基础设施的需求,提升测试效率和可复现性。
Cognition BlogCognition 团队推动异步软件工程,更多 Devin 通过事件、自动化触发,需端到端云验证确保结果可靠。Devin Review 可自动修复代码审查问题,但需进一步测试验证。Devin 在云虚拟机中运行,使用鼠标键盘操作,能测试自身工作,并行运行 10-20 个实例,节省本地验证时间,通过测试计划、确定性脚本和技能库提升可靠性。
Dify Blog7575Dify 是一个 LLM 应用开发平台,让营销人员能通过可视化拖拽构建包含 LLM、向量数据库、外部 API 和逻辑步骤的结构化、可重复工作流。其可支持多模型(如 GPT-4、Claude、Gemini)并行生成内容、自动评分和路由潜在客户、将营销知识库化并支持问答,区别于仅支持单模型对话的 ChatGPT、Claude 等工具。
Qoder Blog6565Qoder 提供专业 AI 工作环境,支持编码外任务,非仅聊天框;集成 Agent SDK 与云代理,上下文长度 8k,参数规模 175B,速度提升 3.5x,价格 $3/百万 tokens。