跳到正文
实时
  1. Google DeepMind87

    Google DeepMind 发布 Gemini 4 Hydrogen 模型

    Google DeepMind 发布 Gemini 4 Hydrogen,面向日常编码与智能体工作流,在默认 high 思考档位下 Artificial Analysis 智能指数为 51,高于 Argon 的 50,xhigh 档位可达 54

    推荐理由: 官方给出Hydrogen与Carbon、Argon的分工定位,以及多模型编排在成本与速度上的实测差异。

  1. The Decoder78

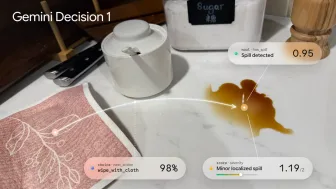
    Google 推出 Gemini Decision 1 与 Gemini Decisions API,单次可处理 1000 个问题

    Google DeepMind 推出 Gemini Decisions API,面向是/否、多选和量表评分等封闭式判断,底层模型 Gemini Decision 1 单次可处理最多 1000 个独立问题,覆盖文本、图像、音频、视频和 PDF。

    推荐理由: Gemini Decision 1 把封闭式判断做成独立 API,并给出延迟、价格与基准表现,便于对照近期同类决策模型。

  1. Claude · YouTube75

    Anthropic 发布 Claude Fable 5.2

    Anthropic 发布 Claude Fable 5.2,面向最艰巨的技术挑战,在编码、推理和视觉方面有所提升,适合最具野心的开放式技术工作。官方建议多数编码与知识任务优先使用 Opus 5.5,Fable 5.2 已在 Pro、Max、Team 和 Enterprise 套餐上线。

    2 篇报道

    各家口径不同:TechCrunch指出Fable的输入价格降至每百万token 8美元;其他报道没有提及价格。

    推荐理由: 官方说明了 Fable 5.2 的定位与适用场景,并给出与 Opus 5.5 的选择建议,便于判断该用哪个模型。

  2. The Decoder71

    字节跳动 Seed 发布 Seedream 5.5 图像生成模型

    字节跳动 Seed 推出面向专业生产工作流的图像生成模型 Seedream 5.5,称其支持最多 100 轮多轮编辑,未改动区域在像素级保持一致且不出现偏色。该模型可原生生成带透明背景的 RGBA 图像,无需手动抠图即可作为设计素材使用,并称在光照、材质、皮肤质感和密集小文字还原上更准确。Seedream 5.5 正通过即梦、豆包、豆包 Work 和火山引擎方舟逐步开放,Pro 版本已在计划中。

    推荐理由: 原文列出多轮编辑稳定性、原生 RGBA 输出和文字渲染三项能力,可据此判断它在设计生产流程中的位置。

  3. TechCrunch · AI72

    Meta 发布轻量模型 Muse Ember,主打智能体执行与低成本

    Meta Superintelligence Lab 发布轻量模型 Muse Ember,输入价格为每百万 token 10 美分,主打工具调用、编码子任务、路由、抽取和长文档解析等智能体高频工作。

    推荐理由: Meta 用每百万输入 token 10 美分的定价和 Artificial Analysis 综合基准,把轻量模型放进智能体执行环节与 Haiku、Luna 比较。

  1. 量子位82

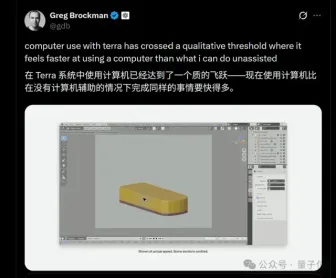
    腾讯混元Hy4发布:770B总参数、49B激活参数,首次支持原生视觉与电脑操作

    腾讯混元Hy4正式发布,770B总参数、49B激活参数,首次引入原生视觉能力和电脑操作支持,指令遵循、长文理解与长程Agent能力同步升级。模型已在腾讯云TokenHub、WorkBuddy/CodeBuddy、元宝等产品上线,API接入OpenRouter、Hermes、OpenCode等平台,权重将于近期开源。

    推荐理由: 作者用多个长程任务实测混元Hy4的自主执行与自检能力,可据此判断开源模型在Agent交付上的实际水平。

  1. The Decoder73

    Thinking Machines 发布 Inkling 2 Small,称其为最强西方开源权重模型

    Thinking Machines 发布第二代模型 Inkling 2 Small,采用 MoE 架构,总参数 594B、激活参数 17B,支持文本与图像输入并可调节思考深度。

    推荐理由: 原文给出新模型在智能指数、智能体任务和成本上的具体对比,读者可据此判断开源权重模型的竞争位置。

  2. Hugging Face Blog71

    NVIDIA 发布 Cosmos 3 四个开源世界模型检查点

    NVIDIA 在 Cosmos 世界模型平台下新增四个 Cosmos 3 开源权重检查点,均为 Cosmos 3 Nano 的后训练版本,含 16B 可训练参数,采用 OpenMDW1.1 许可,允许商用与非商用。

    推荐理由: 原文给出四个开源权重检查点及四阶段后训练配方,读者可据此判断如何把世界模型适配到自有传感器与机器人本体。

  3. Google DeepMind78

    Google DeepMind 发布了 Gemini Omni 1.2 Flash,支持 15 秒视频并降价 30%。

    Google DeepMind 发布了 Gemini Omni 1.2 Flash,原生视频生成时长从 Omni 1.1 的 10 秒提升到 15 秒,并已在 Gemini API 和 Gemini for business 全面开放。

    推荐理由: 原文列出了时长、价格和参考一致性的具体变化,读者可据此判断视频生成的成本与工作流会怎样变化。

  4. The Decoder70

    腾讯发布 Hy4 模型,首次支持图像理解与电脑操作

    腾讯发布 Hy4 模型,首次具备图像理解能力,并能自主操作 Blender、CAD 等软件,权重将在稍后未定日期开放,目前仅通过腾讯云、OpenRouter 和元宝等应用提供。

    推荐理由: 腾讯 Hy4 首次加入图像理解与电脑操作能力,第三方评测与官方说法存在差距,可对照看开放权重模型的真实位置。

  1. IT之家 · AI82

    美团龙猫开源 LongCat-2.5 模型,总参数 1.6 万亿、支持百万上下文

    美团龙猫将面向长程智能体任务的原生多模态模型 LongCat-2.5 正式开源,采用 MIT 协议,支持商用推理部署与二次训练且无需额外授权。模型总参数 1.6 万亿,每个 token 激活约 480 亿参数,支持一百万上下文,并针对显存与带宽受限的国产算力芯片在架构、芯片适配与部署策略上做了协同优化。

    推荐理由: 原文给出总参数、激活参数、上下文长度与开源协议,读者可据此判断长程智能体任务的开源模型选项。

  1. IT之家 · AI78

    小米开源 0.8B 文档理解模型 Xiaomi-OCR-0,支持 Markdown 与 JSON 输出

    小米开源轻量级文档理解模型 Xiaomi-OCR-0,参数规模 0.8B,权重与推理代码已上线 Hugging Face 和 GitHub,单一模型覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。

    推荐理由: 0.8B 参数在 OmniDocBench v1.6 上位列总榜第二,且权重、MCP 服务与 Skill 工具包一并开放,可据此判断小模型做文档解析的边界。

  1. Hugging Face Blog85

    Mistral Large 4(Le Chonk)在 Hugging Face 发布

    Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。

    推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。

  2. IT之家 · AI82

    Mistral AI 开放 Mistral Large 4 模型权重:1T 参数,编程智能体更省 Token

    Mistral AI 于当地时间 10 月 29 日正式开放 Mistral Large 4(代号 le Chonk)模型权重,这是一款 1 万亿总参数、490 亿激活参数的原生多模态模型,在欧洲自有数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练。

    推荐理由: 原文给出 ML4 的参数量、训练硬件、编程智能体基准与 Token 消耗对比,可据此判断其开源定位与成本取舍。

  1. MarkTechPost71

    Liquid AI 发布 LFM3:6 个 2B 级开源多模态模型

    据 Hugging Face 博客和 MarkTechPost,每个模型均可在单张 GPU 上微调;文本模型 LFM3-1.7B 为 1.73B 参数、256K 上下文窗口,4-bit 量化下约 1 GB 内存即可运行,可部署在手机、笔记本、私有服务器或云端。MarkTechPost 称免费商用上限为年营收 1000 万美元,完整 128K 上下文需 1.6 GB KV 缓存。IT之家称 LFM-1.7B 参数比上代 LFM2.5-2.6B 减少 35%,性能却更优。

    推荐理由: 6 个 2B 级开源模型共享同一骨干,并给出与 Qwen3.5-9B 等竞品的逐项对比,可据此判断小模型在端侧与智能体任务上的位置。

  2. Hugging Face Blog76

    Liquid AI 发布 LFM3 系列:同一 2B 骨干派生文本、视觉、音频、全模态与决策模型

    Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。

    推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。

  3. Google DeepMind84

    Google DeepMind 发布世界模型 Genie 4

    Google DeepMind 发布世界模型 Genie 4,可实时生成带原生音频的交互式模拟世界,并以文本提示实时改变天气、镜头和场景元素。Genie 4 首次原生生成环境音与人声对话,角色可实时对话并响应场景事件;Gemini 3.8 Flash 在循环中充当引导智能体,把目标拆成步骤并逐帧校验。

    同一件事 · 7 家

    各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。

    推荐理由: 官方披露了原生音频、实时文本操控与 Gemini 引导推理三项能力,可据此判断世界模型在机器人与内容预演中的位置。

  1. 量子位75

    国产开源 OXR 以 1.3B 参数登顶三项文档解析榜单

    SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。

    推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。

  2. 量子位80

    OpenAI发布GPT-6.1 Terra:价格减半,电脑操作能力接近GPT-6 Astra

    OpenAI发布GPT-6.1 Terra,标准API输入1美元/百万Token、缓存输入0.05美元/百万Token、输出5美元/百万Token,价格约为GPT-5.6 Terra的一半。

    推荐理由: 原文给出GPT-6.1 Terra的官方基准、API定价与网友实测成本对比,可据此判断低价电脑操作模型的性价比边界。