Hugging Face Blog精选7272
Phonon TTS 发布端侧语音模型,登顶 Hugging Face 开放 TTS 榜单多项指标
Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
Hugging Face Blog精选7272Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
 IT之家 · AI精选7474
百度文心发布 ERNIE-5.5-Flash-Base 并开放 ERNIE 5.5 Flash 预训练终点权重,这是一个总参数 280B、每 token 激活 14B 的稀疏 MoE 语言模型,在 33.5T tokens 上从零预训练,微调与推理支持 1M tokens 上下文。
推荐理由: 原文给出 280B 稀疏 MoE 基座的参数、训练数据量与开源权重,读者可据此判断其作为微调起点的适配空间。
 OpenAI News精选6262
OpenAI 发布 Images 2.6,带来更快的图像生成、GIF 创建、更精确的编辑,以及新的 API 控制。该版本覆盖 ChatGPT、Codex 和 API 三个入口。
推荐理由: 原文列出图像生成提速、GIF 创建、更精确编辑和 API 控制四项变化,可据此判断 ChatGPT、Codex 与 API 的图像能力边界。
IT之家 · AI精选7878月之暗面按 10 月 24 日发布时的承诺,在 Hugging Face 开放了 2.8 万亿参数的 Kimi K3.1 Pro 模型权重。
推荐理由: 原文给出开放权重后的 Agent Arena 排名与分项指标变化,可对照上一代 K3 看智能体能力的提升幅度。
Hugging Face Blog精选6565Dharma-AI 发布 Dharma Field Extractor,一个 2B 参数模型,输入文档图像和可选 schema,输出带类型的结构化 JSON,支持开放抽取与按 schema 定向抽取,未出现的字段返回 null。
推荐理由: 原文给出自建基准上的质量与成本对比,读者可据此判断小模型专精路线在字段抽取任务上的可行性。
IT之家 · AI精选7878小米开源轻量级文档理解模型 Xiaomi-OCR-0,参数规模 0.8B,权重与推理代码已上线 Hugging Face 和 GitHub,单一模型覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。
推荐理由: 0.8B 参数在 OmniDocBench v1.6 上位列总榜第二,且权重、MCP 服务与 Skill 工具包一并开放,可据此判断小模型做文档解析的边界。
 量子位精选7575
SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。
推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。
IT之家 · AI精选7474开发者 Divyansh Agrawal 于 10 月 22 日发布实验性模型 Qwenputer,基于阿里 Qwen3.5-4B 构建,在神经网络内部实现 32 位 RISC-V CPU 与内存功能,无需调用 Python 等外部工具即可执行程序和精确计算。
推荐理由: 开发者将 RISC-V 指令集编译进 Qwen3.5-4B 权重,用具体基准数字展示了模型内计算的精度提升与体积、速度代价。
IT之家 · AI精选7878智元于 10 月 29 日推出具身模型 GO-3 Preview,采用具身原生的 WRAM 架构,把任务推理、未来预测与动作生成连接起来,并已登顶 RoboDojo、RoboTwin、RoboColiseum 三大评测榜单,计划 2026 年底全面开源。
推荐理由: 原文给出便利店真机任务成功率从 28.6% 到 85.7% 的部署后数据,可观察具身模型在线自我改进的路径。
Hugging Face Blog精选8585Mistral 发布多模态 MoE 模型 Mistral Large 4(Le Chonk),约 1T 总参数、49B 激活参数,上下文窗口 1M tokens,提供 FP8 与 NVFP4 两个官方版本,另有 Unsloth 和 llama.cpp 团队制作的 GGUF。
推荐理由: 原文给出 1T 总参数、49B 激活的 MoE 多模态模型在网络安全与编码基准上的具体分数,并附本地与端点部署实测吞吐。
 Mistral AI精选8282
Mistral 发布旗舰万亿参数原生多模态模型 Mistral Large 4(Le Chonk)的开放权重版本,此前已公开预览三周。
推荐理由: 官方给出万亿参数开源模型的编码、安全与推理效率数据,以及权重下载和自托管路径。
IT之家 · AI精选7878英伟达于 10 月 28 日推出开放权重语音转录模型 Nemotron 3.5 Transcribe,整合转录、说话人归属、翻译和音频问答,采用 MoE 架构,总参数约 340 亿、激活参数约 43 亿,可处理最长 1 小时录音,支持 40 种语言转录、最多区分 8 名说话人。
推荐理由: 英伟达开源语音转录模型,公开了参数规模、多语言与说话人分离能力及榜单成绩,可对照现有开源 ASR 方案。
 Latent Space精选8282
Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周,宣称在网络安全与长周期任务上达到 SOTA,在 Artificial Analysis Intelligence Index v5 上以 59 分位列第一。
推荐理由: 汇总了 Gemini 4 Carbon 在多个独立榜单上的位置与定价,并列出编码、幻觉率等与竞品的差距。
Hugging Face Blog精选7878NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
 MarkTechPost精选7171
据 Hugging Face 博客和 MarkTechPost,每个模型均可在单张 GPU 上微调;文本模型 LFM3-1.7B 为 1.73B 参数、256K 上下文窗口,4-bit 量化下约 1 GB 内存即可运行,可部署在手机、笔记本、私有服务器或云端。MarkTechPost 称免费商用上限为年营收 1000 万美元,完整 128K 上下文需 1.6 GB KV 缓存。IT之家称 LFM-1.7B 参数比上代 LFM2.5-2.6B 减少 35%,性能却更优。
推荐理由: 6 个 2B 级开源模型共享同一骨干,并给出与 Qwen3.5-9B 等竞品的逐项对比,可据此判断小模型在端侧与智能体任务上的位置。
Hugging Face Blog精选7676Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。
推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。
 Google DeepMind精选8484
Google DeepMind 发布世界模型 Genie 4,可实时生成带原生音频的交互式模拟世界,并以文本提示实时改变天气、镜头和场景元素。Genie 4 首次原生生成环境音与人声对话,角色可实时对话并响应场景事件;Gemini 3.8 Flash 在循环中充当引导智能体,把目标拆成步骤并逐帧校验。
推荐理由: 官方披露了原生音频、实时文本操控与 Gemini 引导推理三项能力,可据此判断世界模型在机器人与内容预演中的位置。
 Microsoft AI News精选6767
微软 AI 发布图像编辑模型 MAI Image 2.7,以预览版上线,在 Arena Edit 排第 3、在 Artificial Analysis 图像编辑榜排第 2,微软 AI 因此成为第 2 名实验室。
推荐理由: 微软公布 MAI Image 2.7 在两个图像编辑榜单的排名,并给出相对上一代在 10 类用例上的提升幅度。
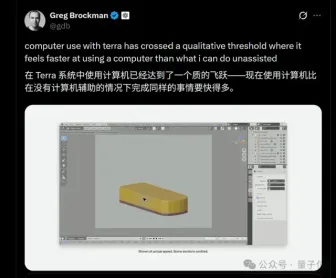
量子位精选8080OpenAI发布GPT-6.1 Terra,标准API输入1美元/百万Token、缓存输入0.05美元/百万Token、输出5美元/百万Token,价格约为GPT-5.6 Terra的一半。
推荐理由: 原文给出GPT-6.1 Terra的官方基准、API定价与网友实测成本对比,可据此判断低价电脑操作模型的性价比边界。
MarkTechPost精选7171百度开源 Unlimited OCR 2,一个 3.34B 参数的 OCR 视觉语言模型,可在单次请求中解析数百页书籍、财报和报告,权重以 MIT 协议发布,代码在 GitHub。
推荐理由: 原文给出 SR-SWA 的稀疏注意力机制与百页文档基准对比,可看长文档 OCR 的上下文成本如何被压平。