跳到正文
实时

公司与模型

DeepSeek

DeepSeek(深度求索)的模型发布、开源权重、技术报告与 API 价格变化。

7篇精选
6本月
11月14日 21:05更新于
本月仍有更新

重大事件

  1. DeepSeek 开放全家桶应用 API,语音接口首次加入 2 家来源

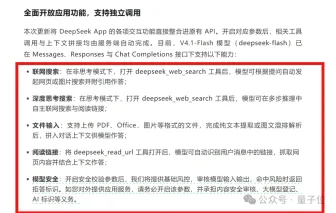
    DeepSeek 宣布正式开放全家桶应用 API,联网搜索、深度思考搜索、文件上传、链接阅读等 App 内功能均提供独立接口,可单独调用、分别计费。语音能力首次加入开放行列,包含 ASR 和 TTS 接口,语音识别原价 0.78 元/小时、现五折 0.39 元/小时,语音合成每万字符 1.5 元。

  2. 豆包工作接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等模型并限时特惠 2 家来源

    豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。用户可根据实际工作需要选择相应模型完成任务。

最新报道

11月14日周六1–7
  1. 量子位80

    DeepSeek 开放全家桶应用 API,语音接口首次加入

    DeepSeek 宣布正式开放全家桶应用 API,联网搜索、深度思考搜索、文件上传、链接阅读等 App 内功能均提供独立接口,可单独调用、分别计费。语音能力首次加入开放行列,包含 ASR 和 TTS 接口,语音识别原价 0.78 元/小时、现五折 0.39 元/小时,语音合成每万字符 1.5 元。

    推荐理由: 原文列出 DeepSeek 开放的工具接口清单与五折语音定价,读者可据此估算语音助手、文档处理类应用的调用成本。

11月13日周五
11月9日周一
  1. Hacker News · 300+ 热帖78

    llama-modchip 使 284B DeepSeek-V4-Flash 在 64GB 内存无 GPU 运行

    llama-modchip 发布了一组 ggml/llama.cpp 内核补丁与量化转码工具,将 284.33B 的 DeepSeek-V4-Flash 压缩到 56.56 GiB(1.71 bpw),可在 64 GB 内存的纯 CPU 机器上运行,256K 上下文下峰值内存 57.61 GiB 且无需 swap。

    推荐理由: 项目给出了在 64 GB 内存上运行 284B MoE 的量化方案与内核补丁,并附各硬件实测数据,可据此判断纯 CPU 部署的可行边界。

11月6日周五
  1. vLLM Blog72

    REINFORCE Zero:对齐 kernel 让异步 RL 在 lag 64 下稳定训练

    NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。

    推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。

11月1日周日
10月25日周日
  1. vLLM Blog60

    vLLM在GB300 NVL72上服务DeepSeek-V4.1-Flash:性能追平DeepInfer并扩展至整机架

    vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。

    推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。

10月7日周三
  1. vLLM engineering42

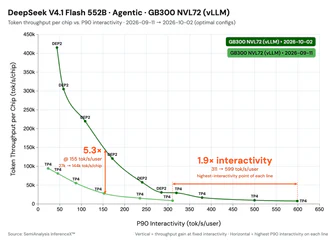
    vLLM 解释了 DeepSeek-V4.1-Flash 的 5.3× 吞吐量提升

    Inferact 和 vLLM 团队在经过三周的优化后,报告称在 150-tokens-per-second 的限制下,低并发服务的速度提高了 1.9×,吞吐量提高了 5.3×。这些更改结合了滑动窗口注意力的有界重放、CUDA 图和融合内核。他们的帖子解释了缓存重建和跳过提示词预填充的某些部分如何减少服务工作量。

    推荐理由: 编辑要点:仅凭模型基准测试无法描述服务成本。这份工程分析有助于识别缓存和内核瓶颈;所报告的收益适用于其基准测试条件,而非每一次部署。