IT之家 · AI精选7272
AI 需求推高存储芯片利润,存储五巨头单季营业利润及净利总额首超美国科技五巨头
据日经亚洲报道,受 AI 投资热潮推高存储芯片需求影响,铠侠、三星、SK 海力士、美光、闪迪五家存储芯片厂商上季度营业利润合计达 32 万亿日元,是上年同期的 10 倍,首次超过 Alphabet、微软、亚马逊、Meta 和苹果五家科技公司合计的约 25 万亿日元。
推荐理由: AI 投资推高存储芯片需求,五家存储厂商利润总额超过美国五大科技公司,读者可据此观察算力产业链的利润转移。
IT之家 · AI精选7272据日经亚洲报道,受 AI 投资热潮推高存储芯片需求影响,铠侠、三星、SK 海力士、美光、闪迪五家存储芯片厂商上季度营业利润合计达 32 万亿日元,是上年同期的 10 倍,首次超过 Alphabet、微软、亚马逊、Meta 和苹果五家科技公司合计的约 25 万亿日元。
推荐理由: AI 投资推高存储芯片需求,五家存储厂商利润总额超过美国五大科技公司,读者可据此观察算力产业链的利润转移。
 量子位精选7575
SoMark 团队开源 1.3B 文档解析模型 OXR,在 OmniDocBench(97.18)、olmOCR-Bench(87.84)和 DocParsingBench(87.76)三项榜单排名第一。
推荐理由: 1.3B 模型靠 RSI 后训练在三个文档解析榜单登顶,并给出可插拔架构与免费 API 的工程取舍。
量子位精选7878岩山科技旗下岩芯矩阵联合港科大、CMU 等高校发布并开源 EdgeRock-4B,在 256K 上下文下 KV Cache 固定为 72MiB,相比源模型 Qwen3.5-4B 减少 99.1%。
推荐理由: 原文给出固定内存下的吞吐与基准对比,可据此判断长上下文推理的显存成本走向。
IT之家 · AI精选7272马斯克在X上表示,SpaceX已完成400亿美元债务融资,主要用于支付预计在2027年第一和第二季度交付的GPU采购款项,并称这笔资金主要是可赎回债务。
推荐理由: 400亿美元债务融资与GPU交付时间,呈现AI算力竞赛下资本需求的规模。
 The Decoder精选7878
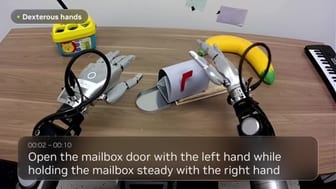
Nvidia 开源数据引擎 Flora,用于机器人视频标注,称标注一小时视频约 0.72 美元,而 GPT-6 Astra 约 88.50 美元。Flora 由三个微调的 Qwen3.5 模型组成,分别负责动作分段、带上下文的描述和奖励打分,覆盖动作描述、分步评分与任务成败判断三类标签。
推荐理由: 原文给出了 Flora 的三类标注能力、成本估算和与 GPT-6 Astra 的逐项对比,读者可据此判断机器人视频标注的开源替代方案边界。
The Decoder精选7272南京大学与商汤等机构的研究者发布 OpenMobile-2,基于 Qwen3.5 的 9B 和 Qwen3.6 的 27B 两个智能体模型,并公开训练环境、数据和复现说明。
推荐理由: 研究将训练数据量固定、只增加应用数量,观察到未见应用成功率提升,为手机智能体的数据构建提供了可复现路径。
 vLLM Blog精选6262
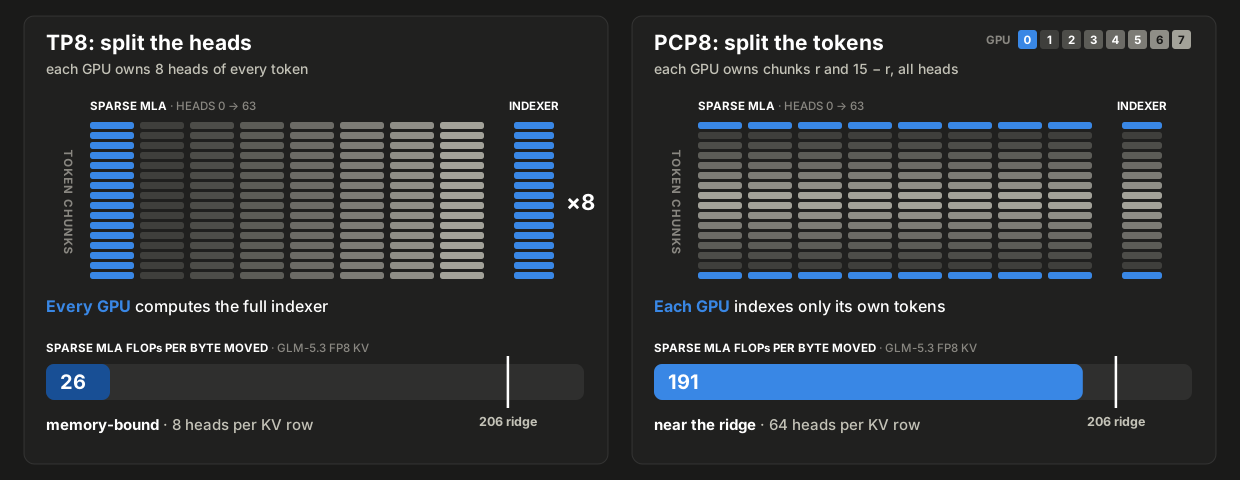
vLLM 团队发布 GLM-5.3 优化第二部分,在 16 张 H200 上以 1 个预填节点加 1 个解码节点部署,用 PCP 按 token 切分预填、DCP 按 token 切分 KV cache,使 1M 上下文可放入预填节点
推荐理由: vLLM 团队拆解了 PCP、DCP 与 Hybrid HiSparse 如何在 16 张 H200 上组合,读者可据此理解长上下文部署的内存与预填瓶颈。
IT之家 · AI精选7171OpenAI 联合 PerturbAI 和斯克里普斯研究所,用数千个 AI 智能体在 32 分钟内分析了覆盖整个小鼠大脑的 CRISPR 图谱,团队估计人类完成同等工作需数月到一年。
推荐理由: 原文给出了分布式智能体与单智能体的盲测对比和文献引用量差异,读者可据此判断多智能体架构在科研分析中的分工方式。
 Hugging Face Blog精选6666
微软与 Hugging Face 发布 ThinkingBox-Training,把 ThinkingBox 对数据库终态的确定性校验直接当作强化学习奖励,用 GRPO 对 Qwen3.8-27B 训练 50 步。
推荐理由: 微软与 Hugging Face 把数据库终态校验直接当作强化学习奖励,并公开了任务筛选与训练代码,可迁移到其他有状态智能体训练。
 Databricks Blog精选6060
Databricks 高管 Patrick 复盘公司全面采用 AI 编码智能体后成本指数级上升、再通过控制层把单位成本最多降低 90% 的过程。他提到把流量迁到更便宜的新模型贡献了 50% 以上降幅,Smart Router 在接近最贵模型质量下把平均任务成本降低 30% 以上。这套内部方案后来产品化为 Unity Gateway,目前已有数千家客户使用。
推荐理由: Databricks 高管复盘自家 AI 编码成本从失控到单位成本降九成的过程,给出网关、路由与自建评测的可迁移做法。
Hugging Face Blog精选7878NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。
 Anthropic Research精选7171
Anthropic 发布机器人暴露指数研究,用 Claude 评估 O*NET 约 1.9 万个任务,发现现有机器人可完成美国 74% 的体力任务、占全部工作时间的 34%,但多数限于受控环境。
推荐理由: Anthropic 用 Claude 给 O*NET 任务逐条评级,量化机器人当前能覆盖多少工作,并给出成本与监管的约束条件。
Anthropic Research精选8080Anthropic 成立生命科学研究组并自建实验室,让 Claude 智能体在 DNA 序列数据库中自主搜索,发现了一种与 DNA 重复序列相关的新型酶系统 ART(array-associated reverse transcriptases)。
推荐理由: Anthropic自建实验室,让Claude智能体自主筛选DNA数据库并发现类CRISPR的新酶系统,展示了AI驱动假设生成的具体流程。
Anthropic Research精选7878Anthropic 公布两项实验结果:Claude(Mythos Preview 与 Opus 4.8)针对 15 个靶点设计蛋白质结合物,成功覆盖 14 个,单靶点模式下命中率 35.1%,高于当前蛋白质设计活动常见的 10-15%。
推荐理由: Anthropic 公布 Claude 在蛋白质设计与分析化学上的实测结果,并给出湿实验验证数据与提示词。
Anthropic Research精选6767Anthropic 基于 2025 年 10 月至 2026 年 4 月约 40 万条 Claude Code 会话,提出分析交互式智能体编码的框架。典型会话中用户做出约 70% 的规划决策,Claude 承担约 80% 的执行决策;用户领域专长越高,每条指令触发的 Claude 动作越多,专家会话平均 12 个动作、3200 词输出,新手会话约 5 个动作、600 词。
推荐理由: 基于约40万条Claude Code会话,量化了规划与执行的分工,以及领域专长如何影响任务成功率。