 智谱 Z.ai · Hugging Face 新模型
智谱 GLM-5.3-Flash 发布:首个原生多模态模型,320B 参数仅 18B 活性参数
智谱发布 GLM-5.3-Flash,首个原生多模态 GLM-5 系列模型,拥有 320B 总参数和 18B 活性参数,在基准测试和实际工作负载中超越 GLM-5.2,价格仅为其十分之一,编码和智能体基准测试接近 Claude Opus 4.8。
智谱 Z.ai · Hugging Face 新模型智谱发布 GLM-5.3-Flash,首个原生多模态 GLM-5 系列模型,拥有 320B 总参数和 18B 活性参数,在基准测试和实际工作负载中超越 GLM-5.2,价格仅为其十分之一,编码和智能体基准测试接近 Claude Opus 4.8。
 Liquid AI Blog
Liquid AI 与 Artificial Analysis 联合发布 Pipette,一个开源平台,用于在边缘设备上基准测试基础模型。
Liquid AI BlogLiquid AI 发布 LFM2.5-230M、LFM2.5-350M、LFM2.5-1.2B-Instruct 和 LFM2.5-2.6B 的 4-bit 检查点,采用量化感知蒸馏(QAD)技术,在保持 Q4_0 GGUF 低内存占用和高速处理的同时,恢复约 97% 的 BF16 精度。
 Anthropic Research精选7878
Anthropic 公布两项实验结果:Claude(Mythos Preview 与 Opus 4.8)针对 15 个靶点设计蛋白质结合物,成功覆盖 14 个,单靶点模式下命中率 35.1%,高于当前蛋白质设计活动常见的 10-15%。
推荐理由: Anthropic 公布 Claude 在蛋白质设计与分析化学上的实测结果,并给出湿实验验证数据与提示词。
 Factory News7575
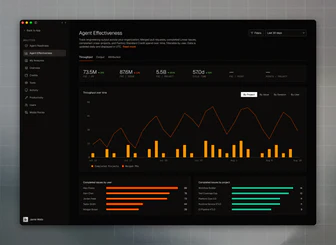
Factory 的 Agent Effectiveness 功能现已上线,将使用数据与交付周期、工作意图及已交付成果关联,帮助工程领导者了解交付加速点、机器人工作内容及使用如何映射到实际产出。该功能通过连接 Droid 使用与交付结果,提供 AI 投资回报的操作性视图,回答交付速度变化、收益集中点及新增能力是否用于优先工作等问题。
 Thinking Machines
 发布开源语言模型 Inkling 和 Inkling-Small,允许用户拥有、运行和定制。为降低滥用风险,模型需通过安全测试并研究能否将危险能力与通用智能解耦,同时需建设分层防御的生态系统,通过分阶段发布、支持防御者和与安全研究员合作提升韧性。内部评估和外部测试显示,发布 Inkling 不会带来现有开源模型已存在的重大增量风险。
 Microsoft AI News
MAI-Cyber-1-Flash 模型在 CyberGym 评测中实现 96% 评分,成本仅为当前 MDASH 最佳方案的 50%,专为 MDASH 执行器优化。
 Berkeley AI Research
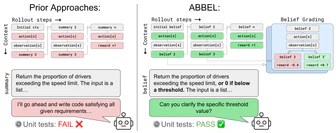
ABBEL框架通过自然语言信念状态替代完整交互历史作为智能体的工作上下文,并利用信念评分机制监督每个信念状态的内容,在协作代码生成任务上使模型性能接近完整上下文模型,同时将峰值上下文token长度减少约75%,训练步骤减少50%。
 Prime Intellect Blog
Prime Intellect 整合了 23 个用于软件工程、终端和搜索的智能体任务集,提供统一 API、运行时/沙盒钩子,包含约 198,000 个软件工程任务、28,600 个终端任务和 137,600 个搜索任务。通过 verifiers v1 将环境分解为任务集、沙盒和运行时三层,标准化了不同任务集的评分逻辑,并提供 135,000 个预构建的开源任务镜像。
 Baseten Labs6565
Qwen3 模型权重写入实验显示,训练数据广度决定知识类型,多样化重述可减少问答差距;写入事实在后续写入中可被行为性遗忘但权重残留,提示词补充可部分恢复能力;无干预措施能持续保持早期事实可访问性,语境比权重更可靠。
Berkeley AI ResearchGPT-4-class 能力成本每月已降至不到 1 美元,推理价格年均下降 50 倍以上。智能体将主导数据系统工作负载,催生三方面新挑战:为智能体设计数据系统需支持 agentic speculation 并优化重复查询;需构建能管理智能体集群状态、协调共识的智能体专属数据系统;需让智能体合成可信赖的自定义数据系统。
 Meta AI Blog
Meta AI 发布 Brain2Qwerty v2,非侵入式脑机接口实时解码句子,词准确率达 61%;v1 训练代码及数据集开源,v1 数据集由合作方 BCBL 发布。
Prime Intellect Blogprime-rl v0.6.0 发布,支持在 1T 参数规模下高效训练多专家模型,GLM-5 在 SWE 任务上可支持 131k 序列长度、256 滚动批大小、5 分钟内单步训练,仅需 28 个 H200 节点完成。
 Dify Blog
通过与 MongoDB 和 Voyage AI 的合作,Dify 在 Dify Marketplace 发布了 MongoDB Atlas 和 Voyage AI 插件,使 Dify 构建者能够直接连接 MongoDB 数据,使用 Atlas Vector Search 进行语义检索,并通过 Voyage AI 嵌入和重新排序来提高结果质量。
Anthropic Research精选6767Anthropic 基于 2025 年 10 月至 2026 年 4 月约 40 万条 Claude Code 会话,提出分析交互式智能体编码的框架。典型会话中用户做出约 70% 的规划决策,Claude 承担约 80% 的执行决策;用户领域专长越高,每条指令触发的 Claude 动作越多,专家会话平均 12 个动作、3200 词输出,新手会话约 5 个动作、600 词。
推荐理由: 基于约40万条Claude Code会话,量化了规划与执行的分工,以及领域专长如何影响任务成功率。
Microsoft AI News微软发布七款新 MAI 大模型,可在 Foundry 平台使用并针对自家产品优化,同时通过 OpenRouter、Fireworks 和 Baseten 向开发者开放,首次支持开发者自行微调模型权重。
Prime Intellect Blog6565Prime Intellect 将 FrontierSWE 推上 Environments Hub,这是一个由 Proximal 开发的超长时序开放式编码基准,包含优化编译器或训练蛋白质预测 SOTA 模型等挑战,平均任务耗时 11 小时且几乎无解。
 Cognition Blog
SWE 1.6 是专为软件工程智能体构建的最新模型,在 Windsurf 上提供通用支持,速度达 950 tok/s 且未来 3 个月免费。相比 SWE-1.5,SWE 1.6 在 SWE-Bench Pro 上提升超 10%,通过联合优化用户体验和推理流畅度,显著减少过度思考、工具调用冗余等行为,使模型交互更高效。
Prime Intellect Blog6565我们与 Browserbase 合作,为浏览器和计算机使用智能体提供最佳训练体验。Browserbase 提供可扩展的浏览器基础设施,已支持微软的 Fara-7B 和谷歌的 Gemini 2.5 CUA。
Berkeley AI ResearchSPEX 算法通过信号处理和编码理论识别 LLM 关键交互,仅需少量扰动即可分析特征、数据和模型组件影响,在情感分析任务上实现数千特征场景下的高保真度;ProxySPEX 算法利用模型层级结构特性,将扰动次数减少 10 倍同时保持性能。
Anthropic ResearchAnthropic 引入新指标 observed exposure 量化 AI 替代风险,结合 LLM 理论能力与实际使用数据,侧重自动化工作场景;研究发现当前 AI 覆盖率仅达理论值的几分之一,高风险职业多为高学历高薪女性,自 2022 年底失业率未显著上升,但暴露职业中年轻工人招聘放缓。
Anthropic Research5050科学家通过 Claude 4.5 在生物图解、计算生物学和蛋白质理解基准测试中取得显著进步,该模型已通过 API 供全球顶尖研究人员免费使用,并构建出超越文献综述或编码辅助的定制系统。在实验室中,Claude 作为协作伙伴贯穿研究全过程,通过多种工具将通常耗时数月的项目压缩至数小时,并发现人类可能忽略的大数据集模式,消除知识密集型任务瓶颈,甚至启用传统方法无法采用的全新研究途径。
Prime Intellect BlogINTELLECT-3是一个106B参数的专家混合模型,在GLM 4.5 Air基础模型上使用SFT和RL训练,在数学、代码、科学和推理基准测试中达到其规模的最优性能,优于许多更大型的前沿模型。
Dify BlogDify 知识管道正式集成 TiDB Vector,开发者可无缝复用解析表格、提取实体及嵌入文本等处理知识构建下游 AI 应用。TiDB Vector 支持混合 SQL + 向量搜索,通过 SQL 语法过滤结构化元数据再进行语义检索,确保精准、具上下文响应,并利用 TiDB 分布式架构实现企业级可扩展性与稳定性。
Dify Blog6565Bright Data 登陆 Dify Marketplace,为 Knowledge Pipeline 带来实时结构化网络数据源;其 Web Scraper 插件可通过 5 步安装配置,接入 72M+ 代理网络采集电商、社交媒体等数据,支持 API key 授权,丰富 AI 工作流知识基础。
Prime Intellect BlogPrime Intellect 发布 SYNTHETIC-2 数据集,包含四百万条经验证的推理轨迹,涵盖迄今最全面的复杂强化学习任务和验证器。该数据集通过全球计算贡献者的管线并行分布式推理协作生成,1,253块 GPU(包括49个8xH200节点、43个8xH100节点及大量消费级3090和4090 GPU)在3天内参与创建。
 Hamel Husain6565
Claude Code 使用聚类方法从每个簇中选择示例进行审查,结合主动学习技术通过监控标注文件 annotations. 来更新故障分类并查找相似案例或不同故障,审查方法需根据目标进行实验性优化并保留随机样本以发现当前信号未描述的故障模式。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
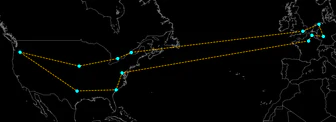
Prime Intellect BlogPCCL发布,专为全球分布式训练设计,具备容错性,支持在公共互联网上运行,每对数据中心带宽达45 Gbit/s,北美与西欧间训练带宽达25 Gbit/s,支持动态成员加入与重加入,通过在主要套接字实现(Linux、macOS、Windows WSA)上的长时间压力测试验证其高容错性。
Prime Intellect BlogINTELLECT-2 是首个通过全球分布式强化学习训练的 32B 参数模型,采用完全异步 RL 跨动态异构计算贡献者群组训练推理语言模型。开源了训练框架 PRIME-RL 及 TOPLOC、SHARDCAST 等组件,并改进 GRPO 训练配方与数据过滤技术,在数学和编码任务上提升 QwQ-32B 性能。
Liquid AI Blog6565Effective State-Size (ESS) 是一个衡量模型内存利用率的代理指标。通过分析深度学习序列模型(如注意力、SSM、门控卷积)的输入依赖矩阵 T(u),定义 ESS 为 T(u) 子矩阵的秩,揭示模型状态压缩、初始化和特征化、状态调制等关键特性。研究发现,有效调节 ESS 的 LLM 在高召回任务中表现更优。
Prime Intellect BlogINTELLECT-2 发布,首次实现全球分布式 32B 参数模型强化学习训练,任何人可无许可贡献异构算力,通过异步强化学习范式消除通信瓶颈,支持异构推理节点,推理节点仅需 4×RTX 3090 GPU 即可参与训练。
Dify BlogInfraNodus 通过生成知识库的概览,帮助 Dify RAG 更好地理解上下文,提升对开放式问题的回答质量。InfraNodus 提取主题、关系和盲点等元数据,增强 RAG 提示词,使 LLM 能覆盖更广泛的重要议题。InfraNodus 可处理 PDF、文本等数据,并支持 API 自动化提取见解,集成 Dify 后显著改善答案结构性和精确度。
Prime Intellect BlogDeepseek-R1 发布 SYNTHETIC-1 开源推理数据集,含 200 万条协作生成的推理轨迹,涵盖数学、编码和科学任务,通过特定任务验证器确认正确性。发布包含正确与错误推理轨迹的原始数据及 90 万条精选 SFT 子集,为 R1 迄今最大 SFT 数据集,并提供偏好调优数据集。发布 7B 参数的 SYNTHETIC-1-SFT-7B 模型,验证数据集通过监督微调能有效提升模型推理能力。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-1 数据集,包含 140 万个经过验证的数学、编程和科学推理任务及验证器,利用 DeepSeek-R1 生成,旨在提升推理模型训练水平。该数据集允许用户贡献计算资源参与分布式强化学习,并开源 GENESYS 框架以支持合成数据生成与验证。
Prime Intellect BlogMetaGene-1 是一个 7B 参数的元基因组基础模型,在 1.5T DNA/RNA 测序数据上预训练,用于疫情监测和病原体检测。它在病原体检测和元基因组嵌入基准上达到 SOTA,512-token 上下文长度使其适合短序列异常检测,但限制复杂任务应用。模型由 USC、Prime Intellect 和核酸观测站合作开发,已开源。
Prime Intellect BlogINTELLECT-1 发布,首个由全球协作训练的 10B 参数语言模型,基于 Llama-3 架构,在 5 国 3 大洲 112 个 H100 GPU 上完成 1T token 训练,PRIME 框架实现 400x 通信带宽降低,96% 计算利用率,支持 8192 序列长度、128256 词汇量,模型代码及数据已开源。
Dify Blog这家服务超1亿用户的全球消费电子领导者通过 Dify.AI 将生成式 AI 整合到运营中,解决了业务与技术间的“左右墙”鸿沟。Dify.AI 低代码平台让新手用户可快速使用主流模型,专家用户能独立定制解决方案,开发者则通过组件化工作流提升效率,一个月内已创建200多个 AI 应用,其中60个在用,用户语音分析时间从8小时缩短至3小时。
Prime Intellect BlogINTELLECT-1 启动全球首个 10B 参数模型分布式训练,邀公众贡献算力参与,推动开源 AGI 进程。该训练基于 OpenDiLoCo 开源实现,将 DeepMind DiLoCo 方法的 1B 参数规模扩展 10 倍,显著降低通信频率(最高 500 倍),通过量化伪梯度(int8)与 500 步外优化器同步将带宽需求降低 2000 倍。
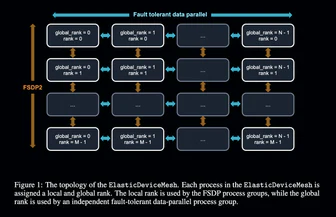
Prime Intellect BlogOpenDiLoCo 成功复现并扩展了 DeepMind 的 DiLoCo 实验至 10B 参数模型规模,通过 Hivemind 和 PyTorch FSDP 实现了跨两洲三国的分布式训练,保持 90-95% 计算资源利用率。该框架基于 Hivemind 开源实现,支持资源动态加入退出和容错训练,在 1.5B 参数模型上显著降低 500 倍通信需求的同时保持性能。