量子位精选8080
OpenAI发布GPT-6.1 Terra:价格减半,电脑操作能力接近GPT-6 Astra
OpenAI发布GPT-6.1 Terra,标准API输入1美元/百万Token、缓存输入0.05美元/百万Token、输出5美元/百万Token,价格约为GPT-5.6 Terra的一半。
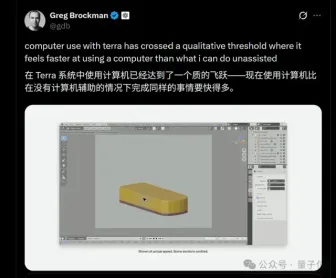
推荐理由: 原文给出GPT-6.1 Terra的官方基准、API定价与网友实测成本对比,可据此判断低价电脑操作模型的性价比边界。
量子位精选8080OpenAI发布GPT-6.1 Terra,标准API输入1美元/百万Token、缓存输入0.05美元/百万Token、输出5美元/百万Token,价格约为GPT-5.6 Terra的一半。
推荐理由: 原文给出GPT-6.1 Terra的官方基准、API定价与网友实测成本对比,可据此判断低价电脑操作模型的性价比边界。
 Hugging Face Daily Papers
提出统一框架整合基础模型与运行时组件以可靠执行复杂数字任务,引入工作持久性与开放性维度,并识别五类核心能力及优化方法。
 MarkTechPost精选7171
百度开源 Unlimited OCR 2,一个 3.34B 参数的 OCR 视觉语言模型,可在单次请求中解析数百页书籍、财报和报告,权重以 MIT 协议发布,代码在 GitHub。
推荐理由: 原文给出 SR-SWA 的稀疏注意力机制与百页文档基准对比,可看长文档 OCR 的上下文成本如何被压平。
MarkTechPost5858vLLM Semantic Router 团队发布 d3-ultra,这是一款 26.09B 参数(含 0.46B 视觉编码器)、上下文长度 131,072 token 的 27B 开源多模态决策模型。
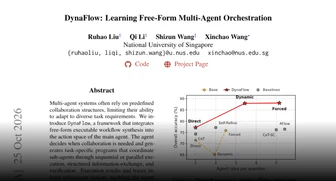
Hugging Face Daily Papers3838DynaFlow 通过让主智能体合成可执行的流程来协调子智能体,实现自适应多智能体协作。该框架在主智能体的动作空间中集成了自由形式的可执行流程合成,主智能体决定何时需要协作并生成特定任务的程序,通过顺序或并行执行、结构化信息交换和验证来协调子智能体。
Hugging Face Daily PapersInteractiveWorld 提供了一个可验证的模拟环境和基准,用于评估多模态语言模型(MLLMs)能否可靠地指导人类完成物理任务。实验使用 12 个前沿 MLLMs 在包含 120 个多轮任务的基准上评估,结果显示它们距离成为可靠的助手仍很远,即使是 Claude Fable 5.1 在长时程指导与规划任务上的得分也仅为 20% 和 25%。
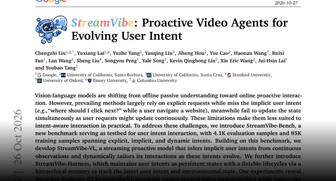
Hugging Face Daily Papers6565StreamVibe-Bench 发布包含 4.1K 评估样本和 85K 训练样本的基准,用于测试显式、隐式和动态用户意图交互;StreamVibe-VL 是一个流式主动视频语言模型,通过持续观察推断隐式意图并动态调整交互;StreamVibe-Harness 通过分层内存框架维持用户意图为持久状态,跟踪最新用户意图和环境状态,使主动交互响应一致性提升 12.3%;
 蚂蚁 inclusionAI · Hugging Face 新模型3838
inclusionAI/Ling-3.0-flash-Sante-fp8 发布 FP8量化版本,保留124B参数(5.1B/Token)与BF16性能,降低内存并提升部署效率,支持医疗推理、研究及工具辅助工作流,需专业人工审核。在Healthbench、ReDisQA等基准上表现稳定,通过块状FP8量化(128×128块)实现高效推理。
MarkTechPost精选同一件事 · 2 家8282OpenAI 发布 GPT-6.1 Terra,一款面向视觉推理、computer use 和写作的快速模型,已以 gpt-6.1-terra 上线 API,标准定价为每百万输入 token 1 美元、输出 5 美元,是 GPT-6.1 Sol 的一半。
 IT之家 · AI精选同一件事 · 2 家8686
OpenAI 发布新模型 GPT-6.1 Terra,主打以更低成本完成需要视觉推理和操作桌面软件的复杂任务,于 10 月 27 日向 Plus、Pro、Enterprise 和 Edu 用户开放,可在 ChatGPT Work 和 Codex 中使用,API 模型标识为 gpt-6.1-terra。
推荐理由: 原文给出多项基准与每任务成本对比,读者可据此判断低成本模型在桌面自动化上的取舍。
IT之家 · AI6565苹果向 Mac 用户推送 macOS 27.2 更新(26B123),新增 Siri AI 法语、日语等六种语言支持,并增强上下文记忆功能;调整亮度与音量滑块;Apple Music 图标更新;系统加入触控手势识别底层代码。
 LangChain Deep Agents releases
LangChain Deep Agents 的 deepagents-code==0.2.2 版本发布,包含安全与性能改进。新增 GPT-6.1 Terra 支持、选中文本输入至聊天、插件更新检测等功能;修复项目 .env 文件设置信任值、终端 UI 链接限制、Git 选项限制等 Bug;通过重用父进程上下文、优化服务器启动流程、精简转录渲染等提升性能,推荐尽快升级。
 Databricks Blog2222
Databricks Free Edition 允许师生免费在浏览器中运行完整数据或 AI 课程,无需云合同或许可证管理,适用于全球学生和教育工作者。该平台提供协作笔记本、Spark、Delta Lake、Lakeflow、Databricks SQL、Genie 代码助手等功能,支持从入门编程到 AI 项目的各类课程,技能直接应用于行业标准工具,无生产环境与教学沙箱的转换成本。
 PyTorch Blog3434
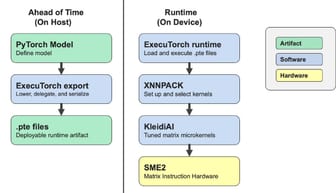
Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
 AWS Machine Learning Blog4848
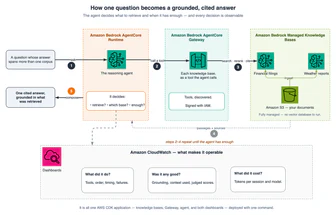
使用 AWS CDK 在 Amazon Bedrock 管理知识库上构建企业级智能检索,通过 AgentCore 提供的推理代理和 AgenticRetrieveStream API 实现多轮规划和工具驱动检索,返回带引用的答案。该方案部署包含 Amazon S3 语料库、知识库和推理代理的 CDK 应用,支持语义路由和多次检索,并内置 Amazon CloudWatch 监控和评估功能。
 Exponential View6565
Claude Code v2.1.159 发布,Anthropic 26% AI 研发由 Claude 领导并有人监督;Sakana AI 和 Gemini 驱动的 AlphaEvolve 代码智能体分别提升 SWE-bench 和 Polyglot 30pp/15pp,MiniMax M2.7 模型智能体迭代提升 30%。
IT之家 · AI4040网易《逆水寒:新世界》首个大型资料片【苗疆蛊事】将于10月30日开启,首次采用双线更新框架,并上线“自拍模式”,支持自定义动作、邀请AI门客NPC合照。玩家可调节动作、视线、宠物互动,门客站支持作品上架、定制开场白及语音,并可通过IP、角色名等条件精准寻访,适配自拍功能。
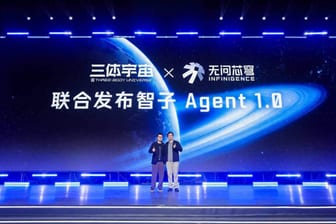
量子位3838无问芯穹与三体宇宙发布智子Agent 1.0,该AI对话Agent以637号小宇宙管理员为角色锚点,通过AgentWorks平台实现角色一致性、交互连续性,支持跨会话记忆,依托多智能体协同机制保障人设与知识约束,采用PDD跨集群异构推理架构降低首Token延迟51.5%。
MarkTechPost6666清华大学和港大研究人员开源 AKV,为 LLM 智能体提供 KV 缓存工程服务。通过丢弃选定缓存条目并重用其余部分,在 3 个模型和 4 个智能体基准测试中,平均成本降低 27.7%,平均任务分数提升 1.7 分。
Hugging Face Daily Papers3131Omni-Woodpecker 是一种无需训练的框架,通过识别模态冲突并重平衡隐藏表示来减少全模态大模型的跨模态幻觉,在 CMM 和 AVHBench 上将 Qwen2.5-Omni-7B 提升了 12.9 和 8.6 分,并在四个通用 OLLM 推理基准上持续提升 0.67-2.25 分,代码开源。
 Hacker News · AI 热帖
Cerebras 通过将 Kimi K3(约 3 万亿参数)模型层分配到多个 WSE-3T 芯片,实现了每秒 1000-2000+ 个 token 的推理速度。
 36氪 · AI6565
Vivix发布实时交互模型W1和A1,目标降低互动内容生成成本至YouTube水平。W1模型实时生成成本接近YouTube每小时约0.2美金的CDN带宽成本,与目前最头部的视频生成模型相比,实时互动内容的生成成本可低1-2个数量级,用户操作后模型能在300-600毫秒内生成下一帧画面。Vivix团队规模已达150-160人。
 Browser Use6262
Claude Code代理可通过安装浏览器扩展或启用Chrome远程调试功能,在已登录的Chrome浏览器中工作;使用Claude in Chrome扩展(需付费Claude计划)可快速连接。
IT之家 · AI5252KRAFTON AI公布Raon-1 mini预览版模型,采用混合专家架构与线性注意力,参数规模30B-A4B,支持推测解码,韩语与英语性能兼顾,Apache 2.0开源,API限时免费试用。预览版在编程与智能体任务上与Meta Muse Glimmer 30B相当,速度更快、内存效率更高。
 The Decoder精选7878
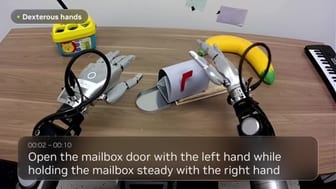
Nvidia 开源数据引擎 Flora,用于机器人视频标注,称标注一小时视频约 0.72 美元,而 GPT-6 Astra 约 88.50 美元。Flora 由三个微调的 Qwen3.5 模型组成,分别负责动作分段、带上下文的描述和奖励打分,覆盖动作描述、分步评分与任务成败判断三类标签。
推荐理由: 原文给出了 Flora 的三类标注能力、成本估算和与 GPT-6 Astra 的逐项对比,读者可据此判断机器人视频标注的开源替代方案边界。
蚂蚁 inclusionAI · Hugging Face 新模型5858inclusionAI/Ling-3.1-flash-base 发布,560B 总参数、25B 活跃参数的稀疏 MoE 架构大模型,采用混合线性注意力机制(63 KDA + 9 Gated MLA),在 47 个跨八个领域的基准测试中表现优异,支持持续预训练、领域适应和后训练研究,模型使用 FP8 精度训练,BF16 精度发布,遵循 MIT 许可证。
IT之家 · AI6060腾讯 WorkBuddy 已接入模型 Kimi-K3.1-Pro,该模型为 3 万亿级参数,支持 100 万上下文,在代码、3D 创作、金融研究等能力上表现突出。
IT之家 · AI4040大众安徽旗下与众 09 今日上市,定位“智能美学纯电轿跑”,共推出 3 款车型,双十一惊喜价 16.99 万元起。该车搭载端到端智能辅助驾驶模型,标配图灵 AI 芯片,总算力 750TOPS,提供单电机和双电机四驱纯电动力版本,全系标配宁德时代神行电芯,峰值充电功率超 520 千瓦,充电 5 分钟可补能 250 公里,CLTC 续航里程达到 755km/705km。
 腾讯混元 · Hugging Face 新模型精选同一件事 · 2 家7171
腾讯混元在 Hugging Face 发布 Hy-Nomas 的 BF16 Diffusers 格式蒸馏权重,该视频世界生成模型支持通过文本指令和相机控制进行多轮自由交互,逐段生成同一世界。
推荐理由: 官方放出蒸馏版 BF16 Diffusers 权重和配套基准,读者可据此判断多轮交互式世界生成的实际用法与门槛。
MarkTechPost6565NVIDIA 发布 Nemotron 3.5 Bolt E4B 4GB,一款开源小型语言模型,专为本地快速对话代理设计,支持语音助手、游戏NPC和机器人接口。该模型基于 Google Gemma 4 E4B 通过强化学习仅进行后训练,总参数 8B,有效参数 4B,上下文窗口 64K。
MarkTechPost5858Kyutai 发布 CADRE,开源因果扩散表示自动编码器专为交互式世界模型设计,将行动延迟降至 230 ms 以下。CADRE 包含 7 个自动编码器,每个约 476M 参数加 86M 冻结的 DINOv3 ViT-B/16,世界模型为 1.2B 参数,视频分辨率为 288×512,帧率为 20 fps,在 1 H100 上运行。
 Cohere Blog
Cohere Labs 开源科学项目通过全球协作收集文化谜题测试 AI 模型,发现模型在跨语言文化理解上存在显著缺陷,常答非所问或产生幻觉。参与者包括 50 多个国家的 100 多人,其中 16 岁的美国学生 Henry Gagnier 和退休教师 Jane Smith 提供了关键见解,指出模型不仅缺乏文化知识,甚至对 Buginese 等常见语言几乎一无所知。
 SemiAnalysis
亚马逊 Trainium 通过原生 PyTorch 训练体验的重大改进,显著提升其在训练领域的竞争力。Trainium3 支持标准 PyTorch API,无需 XLA 标记即可将大部分 PyTorch 代码迁移至 .to("neuron"),但 BF16 训练体验尚未完善。SemiAnalysis 工程团队测试显示其性能接近 CUDA 生态,但仍有改进空间。
Hugging Face Daily PapersFRED框架通过自蒸馏和时序条件提升世界行动模型的未来视频表示能力,在真实世界操作场景中持续优于竞争模型,在长时程和域外任务上实现零样本泛化的大幅增益,将人类视频技能迁移成功率从19.4%提升至50.0%。
AWS Machine Learning Blog5858Amazon SageMaker AI 通过多轮强化学习(MTRL)训练模型执行序列任务,用户无需提供正确轨迹,只需定义结果评分。以 Wordle 游戏为例,将 GPT-OSS-20B 模型的解决率从 61% 提升至 84%(默认推理力度),成本约 339 美元。
Hugging Face Daily PapersWeVisOne-VL 通过结构化 token 预测统一对象级和像素级视觉感知,支持检测、定位、计数、OCR、分割和 matting 等任务,采用轻量级像素解码器和多阶段训练,在 30 项以上基准测试中表现领先,并保持对不存在对象的稳健拒绝。
Hugging Face Daily Papers7575GAFU 框架通过将生成端视觉表示压缩为紧凑的 G token,提升统一多模态模型的细粒度视觉理解能力,支持任务条件检索。在 VStar-Bench、OmniSpatial 和 VSR-Bench 上,GAFU 相比相同数据的 SFT 基线模型最大相对提升达 20.00%、17.94% 和 8.62%。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
Hugging Face Daily Papers7575LaLa-World是一种语言条件潜在世界模型,通过结合模拟、机器人和视频数据实现高效的模型预测规划和策略初始化。该模型采用视频生成模型的语言条件接口,使JEPA风格的潜在世界模型(LWMs)能够跨不同领域和数据源学习。
Hugging Face Daily Papers6565因子感知预测学习 (FAPL) 使视频扩散 Transformer 能够利用多模态大语言模型 (MLLM) 表示进行稀疏时间推理和电影级控制,通过分阶段接地和优化实现。FAPL 在三个电影级视频生成任务(稀疏到视频、因子感知编辑和多镜头生成)上始终优于基线,验证了其在 MLLM 特征使用、时间控制和因子协调方面的贡献。