AWS Machine Learning Blog
U.S. Hunger 如何使用 Amazon Quick 连接领导与数据
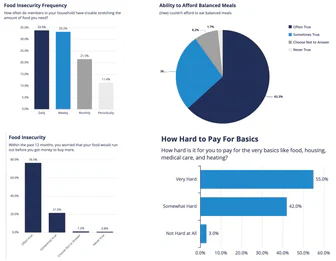
U.S. Hunger 通过 Amazon Quick 直接探索组织数据,实现领导者共享关键绩效指标定义,并在 Quick Spaces 中协同分析财务与非财务信息,支持其年增长500%的运营效率。
AWS Machine Learning BlogU.S. Hunger 通过 Amazon Quick 直接探索组织数据,实现领导者共享关键绩效指标定义,并在 Quick Spaces 中协同分析财务与非财务信息,支持其年增长500%的运营效率。
 Hugging Face Blog
Hugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
 OpenAI News3232
OpenAI、PerturbAI 与 Scripps 研究所合作,使用分布式 AI 智能体分析数百万脑细胞数据,发现新的研究线索。
OpenAI News5555Patch the Planet 连接安全研究员、维护者和事件响应者,帮助应对开源项目中的关键漏洞。
 Trail of Bits
 发布 patching-bugs 和 regression-hunt 插件,让工程师可委托 AI 修复 Bug 和回归测试。patching-bugs 插件可复现 Bug、开发修复方案并测试,regression-hunt 插件则检查变更是否破坏已有功能。regression-hunt 相比基准 Codex 代理减少 25% 假阳性结果。
AWS Machine Learning Blog3232Deepgram 通过 AWS Trainium2 将 Nova-3 语音识别模型部署到 PyTorch,在单个 trn2.3xlarge 实例上运行 8 个副本,处理离线批处理工作负载时每美元可处理 11-70% 更多音频,并使用 NKI 库和 Neuron Explorer/NAD 工具链进行内核级调优,提升推理效率。
AWS Machine Learning Blog5858Amazon Bedrock 现在支持所有 Anthropic Claude 模型的结构化输出,包括 bedrock-runtime 和 bedrock-mantle 端点。
AWS Machine Learning Blog3434AtScale 作为语义层,通过 Semantic Modeling Language (SML) 在 Amazon Redshift 上构建维度模型,支持 Amazon Bedrock AgentCore 中的 Strands 智能体,实现跨系统 Customer 360 分析。
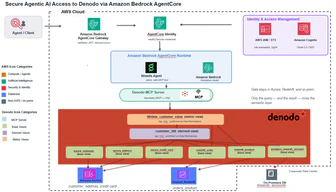
AWS Machine Learning Blog2828Denodo 平台在 AWS 上构建语义层,为 Amazon Bedrock AgentCore 提供受控的企业数据访问,支持 Amazon Aurora、Amazon Redshift 和本地 PostgreSQL 数据库的联邦查询。
 GitHub Blog · AI & ML3333
GitHub Copilot 用户可直接在 VS Code 中打开 GitHub Copilot app 会话,继续其对话、代码变更和上下文。用户可逐行审查 Copilot 的修改,直接在 VS Code 中进行手动编辑,并在本地运行和验证项目。会话和代码工作区保持连接,支持与 Copilot 交互式迭代优化,最后将更新提交到关联的拉取请求。
GitHub Blog · AI & ML2222三位 Java 大师 Vlad Mihalcea、Patrick Baumgartner 和 Frank Delporte 分享了在 Hypersistence Utils、Hypersistence Optimizer、教学幻灯片迁移等项目中使用 GitHub Copilot 的经验。
 Tessl Blog7070
个人应用软件围绕个人需求构建,JavaScript/TypeScript 和 SQLite 可实现远超预期的功能,如 Bonn Tonne、Daybreak 和 Quote-Assist 等示例所示。LLMs 擅长处理这两种技术,能快速生成此类应用。Cloudflare Durable Objects 或自建 celld 可提供运行环境,实现隔离、易操作和零成本扩展。
 Claude · YouTube2525
Anthropic 工程师 Doug 分享在站会与发布评审中使用 Claude Docs 的方法;Claude 在文档中协同工作,自动提取数据、验证论断并响应评论问题;该工具专为团队协作设计,支持多人实时编辑与智能分析。
Tessl BlogTessl Blog 停止逐行审查代码,开始验证意图。团队合并的 PR 量是去年的四倍且几乎都是 AI 生成,导致审查成为瓶颈。团队转向在代码生成前审查意图(验收标准、约束和边缘情况),并将重复的审查评论转化为可由机器执行的规则(不变量),从而将审查重点从代码本身转移到决策和规则所有权上。
 Sakana AI
 举办第二次工程师开放日,涵盖五个职种,介绍各部门工作内容,展示金融和防务领域应用,强调AI主权战略及产品线扩展。
 Hamel Husain6060
在使用决策模型进行评估时,需要根据任务调整阈值以优化性能。在公寓租赁代理的日志数据集上,Jev 1.13、Perplexity Decider 1.1 27B。
 Google Developers Blog
Meta 的 TorchTitan 集成 TorchTPU 使 PyTorch 模型可在 Google Cloud TPU 上原生训练,仅需少量代码更改。
 O'Reilly Radar6565
《周一早晨代理》项目每两周使用NFL公开数据集分析一个美式橄榄球争议话题,逐步为AI智能体赋予分析能力。该项目使用25万个比赛片段和当前赛季数据,每期让AI解释特定战术(如“建立进攻线”)并验证其分析结果。AI在分析时需说明数据局限性,并拒绝超出任务范围(如预测比赛结果)的请求。
 LangChain Blog
Nu公司在开发AI健康教练Nu时,优先构建了评估标准以避免越界医疗诊断,采用LangGraph框架和LangSmith工具,通过按类别评分的LLM裁判和开放式行为测试,确保系统在满足健康指导需求的同时符合监管要求。评估框架针对单一回复和完整对话分别设计,支持在两个前沿模型提供商间快速迁移,安全探针和守门节点实时审查对话内容,确保产品始终处于合规边界内。
 n8n Blog
n8n 工作流可在 NVIDIA DGX Spark 上本地运行,无需调用云 API。通过在 DGX Spark 上部署 35B 混合专家模型 Qwen3.6-35B-A3B(NVFP4 格式)及 8 个其他模型,支持转录、OCR、图像生成等任务,所有模型均通过 OpenAI 兼容端点供 n8n 调用。部署需缓存模型并使用 vLLM 0.30.0 版本,确保离线运行和许可合规。
 IBM Research Blog2222
Coursera 新课程《AI 数据流架构:从原理到实践》教授工程师如何跨 GPU、TPU、Cerebras WSE、Groq LPU 和 IBM Spyre 加速器工作。课程由 IBM 研究院高级研究科学家 Kaoutar El Maghraoui 主讲,通过六门课程和动手实验覆盖执行模型、编译、内存系统、调试和性能建模,强调不同架构如何影响模型性能及编译器优化关键作用。
O'Reilly Radar6565ContextCue 项目通过记录会议录音、保留语音讨论、屏幕共享视觉上下文、决策依据及来源,创建可跨团队的共享协作上下文。该实验针对 GitHub Copilot 和 Claude 等工具已提升编码效率但未改善团队间理解协作的问题,将会议记录转化为围绕请求或决策而非会议本身的 Markdown 格式输出,以解决分布式团队因时差和沟通断点导致需求理解偏差的挑战。
Google Developers Blog使用 ADK 和 Gemini 3.8,通过流式工具和异步函数实现非阻塞语音交互,将销售报告工作流的首次响应时间从 14.4 秒缩短至 1.2 秒,支持零静默、进度更新和并行对话。
 Browser Use
浏览器智能体通过 AI 模型操作网页以达成目标,用户描述任务后,智能体自动打开页面、导航、选择操作并检查结果以继续。它特别适用于需要灵活性和决策的不确定工作流程,由模型(决定行动)、套件(提供上下文、工具和循环)和浏览器(管理网站会话)三部分组成。主要用途包括数据提取、研究、表单填写等,但存在结果不一致、任务失败、网站阻止、提示注入和成本不可预测等缺点。
AWS Machine Learning BlogAmazon Bedrock AgentCore 评估框架帮助 AWS 内部销售团队用多智能体系统处理业务问题,发现智能体在演示和实际生产中表现差异;通过 Amazon Bedrock Guardrails、Amazon CloudWatch 等服务,该框架在发布前和持续生产中验证答案准确性,将错误溯源至数据、提示词或代码,避免因智能体回答看似自信却错误导致用户信任破裂。
 Dify Blog6565
Dify 支持根据任务是否重复、是否需要判断和是否有明确结果来选择 AI Agent 或 Workflow,Agent 由模型选择工具或行动,Workflow 由开发者定义步骤,Hybrid 模式结合两者。在 Dify 中,Agent 适用于需要解释请求并选择下一步的重复性工作,Workflow 适用于固定步骤的 SOP,可在 Workflow 中嵌入 Agent 节点处理需要灵活性的步骤。
OpenAI News3535Anant Kumar 使用 Codex 进行代码审查并加快后续跟进。
 Claude Blog
Claude Code团队将代码审查量提升2倍的同时将回滚率降低40%,通过将大部分审查工作交给机器优化人类时间,并大幅提升撤销错误的速度。团队采用六层自动化审查流程,包括Claude运行测试和生成输出、子代理审查差异、内部技能自动检测错误、UI变更对照设计规范,以及代码规范和代码所有者指南的自动检查,最终由人类审查者处理高阶问题。
 Comfy Blog5252
Comfy博客承诺开源其整个平台但未兑现,因此Comfy启动了一个竞赛,为Genjutsu、Cinema Studio等创意应用的最佳开源重建提供资金支持,大奖为10,000美元,并设有多个奖项类别,包括最具创新性和病毒式传播的应用,所有参赛作品必须使用开放权重模型。
LangChain BlogLangChain 博客介绍了如何使用 Agent Evals 测试 AI 智能体行为,包括通过追踪记录分析行为、构建包含输入和预期输出的测试数据集、运行离线基准测试(如 Terminal-Bench)和在线实时评估,以及使用代码检查、LLM 评分和人工审核等四种评估器类型。离线评估用于测试新提示词或模型并捕捉回归问题,在线评估用于监控生产质量并发现数据集遗漏的问题。
 Lovable Blog
Lovable 平台集成 OpenAI GPT-Live、Anthropic Claude、Google Gemini 4 Argon/Omni/Lyria、Perplexity。
Google Developers Blog评估 AI 智能体不能仅凭感觉检查,因为智能体可能陷入重试循环或产生幻觉回答却仍看似正常,导致云费用和 token 使用量激增。应建立可重复的评估流程,从定义关键用户旅程(CUJ)开始,使用模拟用户测试,并采用单元测试、确定性指标、LLM 作为裁判的评分标准和集成测试等多层检查。结合手动审查的跟踪记录与自动化验证,可在开发早期检测到隐性回归,并随着智能体能力增长扩展评估框架。
LangChain BlogLangChain Deep Agents 通过中间件管理上下文窗口,防止不必要信息进入并过滤已有内容。它采用卸载(将大工具结果和用户消息保存到文件)、摘要(压缩旧消息)、技能(按需加载)、子代理(分离噪声工作)和长期记忆(跨会话保存学习)等技术。这些技术通过在模型调用和工具调用等关键节点插入中间件实现,无需用户编写代码即可使用。
 Google DeepMind
 与新加坡政府技术局(GovTech Singapore)合作,微调了隐私保护型设备端诈骗检测模型 Gemma,用于应对新加坡超过一半的犯罪(超 40 亿新元损失),该模型通过在设备上分析对话模式实时发出警告,且因运行在设备端,用户隐私不受侵犯。
Claude · YouTubeClaude Code 的云会话在云端虚拟机中运行,可离线持续工作,支持手机启动和并行处理。适用于需要持续运行或远程协作的场景,支持 GitHub 连接和环境配置。该功能包含在 Pro、Max、Team 计划及企业高级或 Chat + Claude Code 座位中,计入计划限制且无额外计算费用。
 NVIDIA Blog
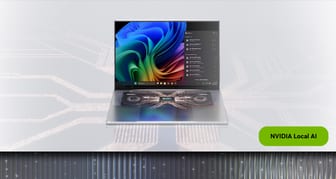
NVIDIA RTX Spark 将游戏 PC、创意工作室和个人 AI 超级计算机的能力整合为单一超级芯片,配备高达 128GB 的统一内存和 1 petaflop 的 AI 计算能力。
n8n BlogJev 对每篇新闻回答三个问题筛选出真正重要的发展,You.com 节点搜索每日新闻并去重,You.com Research 为每个主题撰写简短摘要并通过 Slack 发布,整个流程成本低于四美分,有效避免无关信息干扰。
GitHub Blog · AI & MLGitHub Copilot 可通过自定义指令、代理技能、自定义代理和模型上下文协议(MCP)服务器等方式,让用户向 Copilot 传达项目规则、封装可重复流程、提供专业指导以及连接外部工具,从而提升协作效率。自定义指令定义代码规范,代理技能封装重复性任务,自定义代理处理复杂工作,MCP 服务器扩展 Copilot 功能。
Browser Use7575浏览器指纹识别通过收集用户代理字符串、语言、屏幕尺寸、可用字体和canvas渲染等浏览器特征,经哈希处理后生成唯一标识符,用于用户追踪、欺诈预防、机器人检测等。被动指纹识别利用HTTP头、IP地址和TLS握手特征,主动指纹识别则通过JavaScript收集屏幕尺寸、文本测量、图形渲染和音频处理等数据。网站可结合多种方法识别用户,但浏览器更新或隐私保护会改变结果。
 Simon Willison2222
Dwarf Fortress 开始使用版本控制,具体版本号未提及。