Liquid AI Blog6565
有效状态大小(ESS):衡量模型内存利用率的代理指标
Effective State-Size (ESS) 是一个衡量模型内存利用率的代理指标。通过分析深度学习序列模型(如注意力、SSM、门控卷积)的输入依赖矩阵 T(u),定义 ESS 为 T(u) 子矩阵的秩,揭示模型状态压缩、初始化和特征化、状态调制等关键特性。研究发现,有效调节 ESS 的 LLM 在高召回任务中表现更优。
Liquid AI Blog6565Effective State-Size (ESS) 是一个衡量模型内存利用率的代理指标。通过分析深度学习序列模型(如注意力、SSM、门控卷积)的输入依赖矩阵 T(u),定义 ESS 为 T(u) 子矩阵的秩,揭示模型状态压缩、初始化和特征化、状态调制等关键特性。研究发现,有效调节 ESS 的 LLM 在高召回任务中表现更优。
 Dify Blog
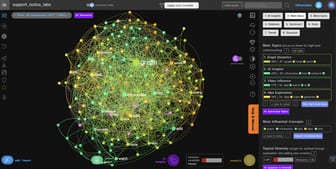
Dify 用户可通过集成 InfraNodus 创建高级 AI 问答机器人,该机器人不仅回答问题,还能从知识库中挖掘洞察并生成新想法。InfraNodus 可可视化知识库为知识图谱,识别概念连接的“结构间隙”,其 API 生成针对这些间隙的见解性问题。用户可将此能力无缝集成到 Dify 应用中,用于启动对话、内容开发或为 Dify AI 代理提供智能提示,从而在网站上嵌入增强型聊天机器人。
 Prime Intellect Blog
INTELLECT-2 发布,首次实现全球分布式 32B 参数模型强化学习训练,任何人可无许可贡献异构算力,通过异步强化学习范式消除通信瓶颈,支持异构推理节点,推理节点仅需 4×RTX 3090 GPU 即可参与训练。
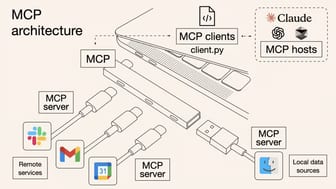
Dify BlogDify 的 mcp-server 插件可将任何 Dify 应用转变为符合 MCP 协议的服务器端点,供外部 MCP 客户端直接访问。该插件通过 HTTP 和 SSE 协议处理客户端请求,支持将 Dify 应用作为单一 MCP 工具供 Cursor、Claude Desktop 等调用,并允许在私有网络环境下运行以增强安全性。
Dify BlogDify 推出面向教育领域的免费 LLM 技术栈,为全球教师和学生提供从构建到应用的完整生成式 AI 工具,支持拖拽式低代码开发、可视化工作流设计及多种插件,首批用户可享 100% 优惠券。
Dify BlogDify 通过 MCP 插件支持将 Zapier 的 7000+ 应用集成到 AI 代理中。开发者可使用 MCP SSE 插件动态调用外部工具,或通过 Agent Strategy 插件让代理自主决策调用。Zapier MCP 服务器提供 30000+ 行动,支持如 Gmail 发送邮件等自动化任务,需配置服务器端点并设置 GPT-4o 提示词控制调用。
 Anthropic Research
Anthropic 发布了两篇新论文,通过构建 AI 显微镜追踪大型语言模型 Claude 的内部机制。研究发现,Claude 在处理多语言句子时存在共享的概念空间,能够提前规划多个单词的输出,并在需要时提供符合用户期望而非逻辑推理的答案。这些发现有助于理解 AI 能力并确保其可靠性,但当前方法仍有局限,需要改进以应对更复杂的模型。
Dify BlogInfraNodus 通过生成知识库的概览,帮助 Dify RAG 更好地理解上下文,提升对开放式问题的回答质量。InfraNodus 提取主题、关系和盲点等元数据,增强 RAG 提示词,使 LLM 能覆盖更广泛的重要议题。InfraNodus 可处理 PDF、文本等数据,并支持 API 自动化提取见解,集成 Dify 后显著改善答案结构性和精确度。
Dify BlogAgora 对话式 AI 扩展作为插件登陆 Dify 市场平台,为开发者提供实时语音 AI 能力。该扩展支持多种 LLM,具备行业领先语音转文本和主流文本转语音服务,通过 Agora 低延迟 SD-RTN™ 技术实现快速响应和全球可靠性。开发者可快速部署虚拟助手或客服机器人,Dify 市场平台现托管超 120+ 插件,支持社区共享和本地部署。
Dify BlogDify 正式推出 Agent Strategy 插件,使工作流节点能将固定流程外的步骤交由 LLM 自主决策。Agent Node 作为执行单元,管理资源与推理过程;Agent Strategy 是可插拔的推理算法模块,定义工具使用与问题解决逻辑。
Dify BlogDify v1.0.0 发布后,其插件系统成为关键特性,通过将水平可扩展模块与 Dify 分离并作为独立运行时操作,实现模块解耦、插件市场与共享机制及 Endpoint 插件等功能。
Prime Intellect BlogPrime Intellect 宣布获得 Founders Fund 领投的 1500 万美元融资,用于构建支持 agentic 模型训练、评估和部署的开放超级智能栈,此前已推出 GPU 交换平台 Compute Exchange 和分布式训练框架 PRIME,并开源了 INTELLECT-1、METAGENE-1 等模型。
Dify Blog6565Dify 低代码平台与 DeepSeek R1 结合,可快速构建企业级多语言文档翻译工具,通过可视化工作流实现文档解析、风格化翻译和批量处理,无需复杂编程即可提升跨语言协作效率。
Dify BlogDeepSeek R1 在 AIME 数学竞赛中表现优异,准确率从 15.6% 提升至 71.0%,并在 Codeforces 编程竞赛中达到 96.3% 的人类水平,展示出强大的推理能力。
Dify BlogDify 提供三种方案确保 DeepSeek-R1 稳定运行:官方 API 集成支持多键负载均衡;接入 Azure AI Foundry 等 MaaS 服务作为备份;本地部署 Ollama 满足隐私需求。通过 Dify 可实现官方 API 与 MaaS 的主备切换,保障 1000+ 模型支持的应用持续在线。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-1 数据集,包含 140 万个经过验证的数学、编程和科学推理任务及验证器,利用 DeepSeek-R1 生成,旨在提升推理模型训练水平。该数据集允许用户贡献计算资源参与分布式强化学习,并开源 GENESYS 框架以支持合成数据生成与验证。
Dify BlogDify 与 DeepSeek 结合,可部署私有 AI 助手并构建本地 DeepSeek R1 + 网络搜索应用。Dify 支持部署 DeepSeek R1:7B 模型(175B 参数),集成网络搜索与文档分析,提供 1000+ 模型支持,确保数据完全私有化。通过 Ollama 管理 DeepSeek 模型,在 Dify 平台上创建聊天机器人或工作流应用。
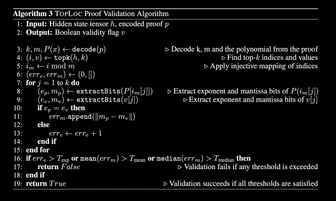
Prime Intellect BlogTOPLOC 通过局部敏感哈希机制检测模型、提示词或计算精度的未授权修改,验证速度比原始推理快 100 倍,每 32 个新 token 的提交存储只需 258 字节(对比 Llama-3.1-8B-Instruct 的 262 KB)。该方案在多种硬件配置、GPU 类型、张量并行维度和注意力核实现下保持鲁棒性,内存开销降低 1000 倍,适用于大规模部署。
Prime Intellect BlogPRIME-RL 算法结合合成推理数据微调的 Qwen-7B-Math 模型训练出 INTELLECT-MATH,在数学推理基准测试中超越 Eurus-2-7B-PRIME 并将训练时间缩短 10 倍至 47 步(原需 592 步);同时发布包含 500 万条推理轨迹的 NuminaMath-QwQ-CoT-5M 数据集,所有代码、权重及数据均开源。
Dify BlogDify 推出 Plugins 插件系统进入 Beta 版,通过即插即用组件扩展 AI 应用功能。开发者可在 Dify Marketplace 获取现成插件或自建,支持图像处理、音频分析、文本生成、数据分析、逻辑推理及外部集成等能力。系统采用解耦架构,包含模型、工具、策略、扩展和包等五类组件,通过自定义端点实现与 Dify 核心功能的双向通信。
Dify Blog6565Dify v0.15.0 推出父子检索技术,通过匹配小粒度子片段实现精准检索,结合大粒度父片段补充上下文,提升 RAG 系统的响应准确性与信息丰富度。该功能支持两种父片段分割模式(段落/全文),允许用户独立编辑父子片段并选择是否再生子片段,同时优化了片段预览界面以增强低代码平台易用性。
Dify Blog6565Dify v0.14.0 引入强大的错误处理功能,允许开发者针对 LLM 节点、HTTP 节点、工具节点和代码节点定义自定义错误处理,通过默认值、工作流重定向等策略防止流程中断,提升 AI 应用可靠性。
Dify Blog6565Dify 和 Windsurf 打造 Twitter MBTI 分析器,上线三天获 20 万次访问。该项目使用 Dify 构建后端,通过 Twitter Scraper 分析用户资料并生成 MBTI 报告,前端由 Windsurf 的 Claude-3.5-sonnet 助手开发,API 通信采用 HTTP 请求,支持 8k 上下文窗口。
Liquid AI BlogSTAR 算法通过演化算法合成定制化架构,生成的架构在质量上优于强 Transformer 和混合架构,参数和缓存更少。STAR 可根据任务、指标和硬件定制架构,采用线性输入变化系统(LIVs)理论和分层数值序列(STAR 基因组)进行演化优化,支持静态和动态目标。
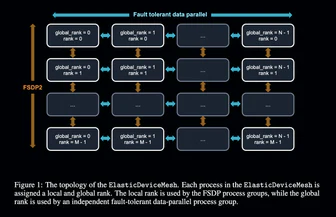
Prime Intellect BlogINTELLECT-1 发布,首个由全球协作训练的 10B 参数语言模型,基于 Llama-3 架构,在 5 国 3 大洲 112 个 H100 GPU 上完成 1T token 训练,PRIME 框架实现 400x 通信带宽降低,96% 计算利用率,支持 8192 序列长度、128256 词汇量,模型代码及数据已开源。
 LangChain Blog
Promptim 是一个实验性提示优化库,通过提供初始提示、数据集和自定义评估器(可选人类反馈),自动运行优化循环生成优于原始的提示。它集成 LangSmith 进行数据集管理、提示管理和结果跟踪(可选人类标注),核心算法通过评估器反馈修改提示并迭代优化,支持人类反馈环节。该工具旨在节省人工提示工程时间、引入严谨流程并简化模型切换,但需保留人工审核环节。
Dify Blog6565Dify Workflow 通过并行模式和高级迭代功能,加速 GPT-Researcher 的研究任务,将问题分解为 4-6 个独立子问题,并行提取主题形成子标题、调用 Tavily API 搜索并分析结果,最终整合为结构化报告,显著缩短研究时间并隔离错误处理。
Dify Blog这家服务超1亿用户的全球消费电子领导者通过 Dify.AI 将生成式 AI 整合到运营中,解决了业务与技术间的“左右墙”鸿沟。Dify.AI 低代码平台让新手用户可快速使用主流模型,专家用户能独立定制解决方案,开发者则通过组件化工作流提升效率,一个月内已创建200多个 AI 应用,其中60个在用,用户语音分析时间从8小时缩短至3小时。
Anthropic ResearchAnthropic 对 Claude 3 Sonnet 的 29 个与社会偏见相关的特征进行引导实验,发现适度引导可在不损害模型能力的前提下减少偏见,但过度引导可能导致模型能力下降甚至不可用;部分引导能精准影响特定领域评估结果,但特征效果难以仅通过其触发上下文预测,存在脱靶效应;其中一项中性行为特征能有效降低九个维度的偏见而不显著影响能力。
Dify BlogDify v0.10.0 发布,新增文件上传功能,支持文档、音频和视频文件,实现问答、摘要生成等应用,并可通过文件上传和 LLM 节点构建 AI 驱动的播客。
Prime Intellect BlogINTELLECT-1 启动全球首个 10B 参数模型分布式训练,邀公众贡献算力参与,推动开源 AGI 进程。该训练基于 OpenDiLoCo 开源实现,将 DeepMind DiLoCo 方法的 1B 参数规模扩展 10 倍,显著降低通信频率(最高 500 倍),通过量化伪梯度(int8)与 500 步外优化器同步将带宽需求降低 2000 倍。
Dify Blog6565OpenAI今日发布o1系列(含o1-mini)推理模型,需API Tier 5访问,Dify已支持其集成。开发者可在Dify平台通过API Key配置OpenAI o1模型,并选择为默认推理模型,支持200消息免费试用。
Dify BlogDify v0.8.0 引入并行处理能力,可同时运行多个分支以提升工作流执行效率。支持简单并行、嵌套并行、迭代并行和条件并行四种模式,帮助 LLM 应用更快更灵活地处理复杂任务。
Dify Blog6565Dify 推出 Conversation Variables 功能,通过临时存储关键信息提升多轮对话的 AI 交互自然度和上下文感知能力。该功能支持存储和召回关键信息,优化多步 AI 工作流,并实现细粒度记忆控制。
Dify Blog6565Dify v0.7.0 发布对话变量和变量赋值节点,赋予 Chatflow 应用更灵活的大语言模型记忆控制,支持存储用户输入、偏好和文件,提升复杂场景下的生产应用能力。
Prime Intellect BlogOpenDiLoCo 成功复现并扩展了 DeepMind 的 DiLoCo 实验至 10B 参数模型规模,通过 Hivemind 和 PyTorch FSDP 实现了跨两洲三国的分布式训练,保持 90-95% 计算资源利用率。该框架基于 Hivemind 开源实现,支持资源动态加入退出和容错训练,在 1.5B 参数模型上显著降低 500 倍通信需求的同时保持性能。
Dify Blog6565Dify 版本 0.6.12 整合 LangSmith 和 Langfuse,用户通过简单配置即可访问 LLM 应用详细数据,便于评估成本、延迟和质量。LangSmith 提供丰富评估功能,Langfuse 支持开源自托管架构,两者助力 Dify 用户监控、优化 LLM 应用性能。
Prime Intellect BlogPrime Intellect Compute 平台正式上线,聚合全球 GPU 资源以实现即时计算的民主化。平台提供统一资源池,支持单 GPU 到 512+ GPU 集群的即时访问,首批整合 12 家云服务商,H100 GPU 时价 1.5-4 美元/小时。
Dify Blog6565Dify v0.6.11 发布,集成 Firecrawl 作为网页数据源,通过爬取网站生成结构化 markdown 数据增强知识库,支持同步网页数据并嵌入向量数据库构建 RAG 应用,提供 500 免费页 API 信用额度,同时优化工作流协作功能。
Anthropic ResearchAnthropic 开发了一种测量大模型说服力的方法,比较了 Claude 1、2、3 三代模型及紧凑型和前沿型模型,发现各代模型说服力均呈提升趋势,最新模型 Claude 3 Opus 的说服力与人类无显著差异。