IT之家 · AI6565
微信输入法 4.0.0 版本新增 AI 录音笔功能,支持实时转写与网页生成
微信输入法 4.0.0 版本新增 AI 录音笔功能,可在手机端通过键盘工具栏或 App 内打开,电脑端通过快捷键 V 或系统菜单栏调用;该功能支持实时语音转写为网页,能自动提炼重点、生成图表和交互页面,并删除冗余语音。
IT之家 · AI6565微信输入法 4.0.0 版本新增 AI 录音笔功能,可在手机端通过键盘工具栏或 App 内打开,电脑端通过快捷键 V 或系统菜单栏调用;该功能支持实时语音转写为网页,能自动提炼重点、生成图表和交互页面,并删除冗余语音。
IT之家 · AI同一件事 · 2 家Ollama 于 10 月 24 日宣布其 Mac 应用正式支持文本转语音(TTS)生成,首个支持的语音模型是 Gradium 开发的 Phonon 系列,用户无需依赖云端服务,可在 Apple Silicon Mac 上运行。在搭载 M5 Max 芯片的 MacBook Pro 上,Phonon 语音生成速度比 Gradium 自身实现快 35%,并支持实时语音生成。
 Ars Technica · AI
苹果发布 iOS 和 macOS 27.2,新增 Siri AI 功能及音乐 Logo
 PyTorch Blog3434
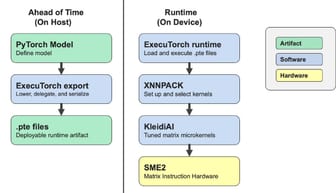
Nemotron 3.5 在 Google Pixel 11 上使用 ExecuTorch 和 SME2 实现了最高的流式语音识别准确率,最高可达 11.7% WER(使用 1,120 ms 音频块和 QC8W 精度),比 FP32 快 3.5 倍,但延迟增加;较短的音频块(如 80 ms)可以降低延迟,但准确率降至 15.2% WER。
 Ollama Blog精选同一件事 · 2 家6262
Ollama新增文本转语音能力,首个接入的语音模型是Gradium的小型TTS模型家族Phonon,目前支持macOS、Windows和Linux,支持即将推出。
推荐理由: 原文给出Ollama接入语音模型后的吞吐对比、准确率与OpenAI兼容接口,可据此判断本地TTS的落地方式。
IT之家 · AI同一件事 · 5 家6262Block 推出 AI 语音模型 Dessa,完全基于人类语音数据训练,支持本地运行于 M4 Max 及更高配置的 MacBook,可模拟笑声、停顿、哽咽等情绪表达,听感高度拟人。Dessa 属于全双工模型,可一边说话一边收听用户语音,自身知识来源于训练所用的对话数据。现阶段暂不对外开放试用,Block 正向安全研究者发出测试邀请。
各家口径不同:The Verge 提及模型对话偶有'生硬和诡异'表现;The Decoder 和 TechCrunch 没有提到这一点。
 Ollama releases6565
Ollama v0.40.11 发布,新增 macOS 语音生成功能,可通过 /v1/audio/speech 端点流式播放文本或聊天回复语音;引入 d3 决策模型,支持 2B 至 27B 参数规模,可对文本、结构化状态或图像进行分类、评分或回答是/否问题。
 TechCrunch · AI同一件事 · 5 家
Block 公司发布 Dessa 语音模型,该模型完全基于人类语音训练,能在消费级 GPU 上本地运行,支持同时说话和聆听,通过真实对话数据获取知识,表达包含笑声、停顿和哭泣等人类情感,目前无法公开访问,公司正在招募安全研究员测试。
各家口径不同:The Verge 提及模型对话偶有'生硬和诡异'表现;The Decoder 和 TechCrunch 没有提到这一点。
 The Decoder同一件事 · 5 家5858
块公司推出 AI 语音模型 Dessa,该模型完全基于人类语音训练,不使用任何文本数据,直接处理音频以实时捕捉情绪、讽刺、笑声和停顿,支持全双工通信,可在 MacBook Pro M4 Max 上本地运行,由单个 NVIDIA GB200 NVL72 训练,目前尚未公开可用,团队正在招募 AI 安全研究人员进行测试。
各家口径不同:The Verge 提及模型对话偶有'生硬和诡异'表现;The Decoder 和 TechCrunch 没有提到这一点。
 MarkTechPost6565
NVIDIA 发布 Nemotron 3.5 Bolt E4B 4GB,一款开源小型语言模型,专为本地快速对话代理设计,支持语音助手、游戏NPC和机器人接口。该模型基于 Google Gemma 4 E4B 通过强化学习仅进行后训练,总参数 8B,有效参数 4B,上下文窗口 64K。
Ollama releases1010Ollama v0.40.11-rc0 发布,通过 @jmorganca 的 #19242 PR 新增 Phonon 语音目录功能;@hoyyeva 的 #19228 PR 优化 qwen3coder 保留函数闭合标签;@SynapShift 的 #19173 PR 允许 vllm-d3 空状态。
 The Verge · AI同一件事 · 5 家6565
Block发布仅基于人类对话训练的AI模型Dessa,展示的对话偶有生硬和诡异表现;该模型为“纯语音到语音模型”,可在MacBook Pro M4 Max或更优设备本地运行,旨在通过语音交互提升人机理解与安全。
各家口径不同:The Verge 提及模型对话偶有'生硬和诡异'表现;The Decoder 和 TechCrunch 没有提到这一点。
 Amazon Science
Audible 技术团队开发新型可控语音合成技术,通过结合大型语言模型(LLM)和三项创新技术提升有声读物体验:1)开发数据合成管道生成带语音特征描述的语音数据,训练模型理解描述并生成匹配音频;2)创建自动分析书籍角色并识别对话的系统,准确率达 97%,为模型提供舞台指示;3)在 MUSHRA 测试中使对话区分度提升 3.7 分,英语和西班牙语测试中八成声音体验显著改善。
 Hugging Face Daily Papers3838
Heartbeat 思考通过在语音更新期间继续准备工具调用,提升了语音代理的覆盖率和响应速度。该技术使语音代理在用户说话时就开始准备工具调用,解决了传统方法因语音更新而中断调用的限制。在 FDBench v3 基准测试中,Heartbeat 思考将工具覆盖率提高了 16 个百分点,并将平均最终响应延迟降低了 36.4%。
Ollama releases4040Speech Ollama 可在 Apple Silicon 上使用 Phonon 生成语音,通过 /v1/audio/speech 端点流式传输音频;d3 决策模型支持 2B 至 27B 参数规模,用于分类、评分等任务;Flint 扩展至 Linux 和 Windows 平台,其他改进包括错误报告和模型能力传递。
 AWS Machine Learning Blog4848
Amazon Polly Generative engine 升级后提供更自然、准确的语音输出,新增 14 个声音(跨 9 个地区),首次将印地语和芬兰语实现通用可用。升级为即插即用,API 调用和声音名称不变,现有应用无需修改。支持基于文本上下文的情感和韵律表达,新增语言为印地语(Arjun/Kiara)、芬兰语(Suvi),总共有 57 个生成声音(11 种语言/25 个地区),价格不变。
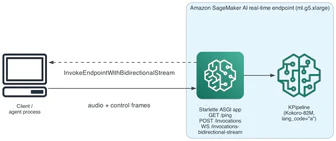
AWS Machine Learning Blog使用Amazon SageMaker AI上的Kokoro-82M TTS模型流式传输AI代理的语音响应,将生成与合成同步,以减少延迟并降低推理成本,Kokoro-82M模型包含8200万参数,在单个ml.g5.xlarge GPU实例上运行。
MarkTechPostGradium 开源了 Phonon,一个可在设备上运行的 31M 参数 TTS 模型,支持英语,包含 37 个内置声音,Apache 2.0 许可,文件大小 64.5 MB,无需云调用、GPU 或按字符计费。Phonon 31m 在 CPU 上首次生成音频只需 6.9 ms,速度比实时快 29.9 倍,在 500 句硬句集上 WER 为 1.70%
 Sierra Blog7575
𝜏-Entity基准测试语音智能体在200项任务中捕捉姓名、电话等实体信息的准确性。GPT Live 1在常规条件下正确率为60.3%,但在噪声和语音干扰下仅为34.0%;推荐验证策略可将成功率提升14-31个百分点,但通话时长增加21-28秒。
MarkTechPost同一件事 · 3 家Mistral AI 发布了 Voxtral 3 语音模型家族及基于 LiveKit 的语音智能体 SDK,包含 3 个转录模型、1 个文本转语音模型。
各家口径不同:The Decoder 提到文本转语音模型(Voxtral Mini TTS 3),而第一份报告没有详细说明。
 腾讯混元 · Hugging Face 新模型精选7272
腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并具备实时声音克隆能力。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数超过所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比数据,并开放 GGUF 权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并可在说话过程中持续输出译文文本与语音,同时通过实时声音克隆保留说话人音色。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布并开源 Hy-SimulMT-30B-A3B 系列实时同传模型,支持中英双向语音到语音翻译和实时声音克隆,同时输出译文文本与语音。在 RealSI 长音频评测中 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 分数超过所比开源模型和 5 个商业 API 中的 4 个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署工具,可据此判断落地条件。
腾讯混元 · Hugging Face 新模型精选7474腾讯混元发布 Hy-SimulMT-30B-A3B 实时同声传译模型,支持中英双向语音到语音翻译并实时克隆说话人音色,已在 Hugging Face 开源多个版本。
推荐理由: 官方给出与开源模型、商业 API 及专业同传译员的对比数据,可据此判断实时同传的质量与延迟取舍。
腾讯混元 · Hugging Face 新模型精选7272腾讯混元发布并开源实时同声传译模型 Hy-SimulMT-30B-A3B,支持中英双向语音到语音翻译,可在说话过程中持续输出译文文本与语音,并支持实时声音克隆。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放多个量化版本和推理部署脚本,可据此评估落地成本。
腾讯混元 · Hugging Face 新模型精选7575腾讯混元发布并开源 Hy-SimulMT-30B-A3B,支持中英双向语音到语音实时同声传译,边接收音频边输出译文文本和语音,并支持实时声音克隆。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 原文给出中英双向同传的延迟与质量对比数据,并附开源权重和部署方式,可据此判断实时语音翻译的可用程度。
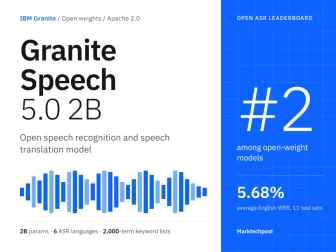
MarkTechPost7575IBM 发布 Granite Speech 5.0 2B,一个 2B 参数的开源语音语言模型,支持 6 种语言的语音转写与翻译,在 Open ASR 排行榜上排名第二,英语平均 WER 5.68%。模型采用 YaRN 扩展至 16k 位置,支持 GPU、Apple Silicon 和本地 CPU 部署,并包含 2000 项关键词偏置功能。
Sierra Blog7575𝜏-i18n 将 𝜏-Voice 扩展至西班牙语、巴西葡萄牙语、印地语、韩语和普通话五种语言,使用航空、零售和电信任务评估跨语言性能。评估包含任务完成度、交互效果和生成质量三维度,结果显示韩语表现最弱,GPT Live 1 任务完成和生成质量最高,Grok Voice Think Fast 2.0 交互最佳但生成质量低。
The Verge · AI3838Google 在 Apple CarPlay 的 Google Maps 中引入了对话式 Gemini 导航功能,美国用户现已可用,全球范围也在逐步推广。该功能允许用户通过语音进行多步骤交互,例如获取地点推荐并规划路线,同时避开收费公路。
The Decoder同一件事 · 3 家7272Mistral AI 发布实时语音智能体全栈 Voxtral 3,包含语音转文本模型(Voxtral Small Transcribe 3)、文本转语音模型(Voxtral Mini TTS 3)及基于 LiveKit 的语音智能体 SDK。
各家口径不同:The Decoder 提到文本转语音模型(Voxtral Mini TTS 3),而第一份报告没有详细说明。
The Decoder7171Elevenlabs 发布两款新语音转语音模型 Eleven Realtime,Max 版本在 Big Bench Audio 基准测试中得分 98.8%,响应时间 0.57 秒。
TechCrunch · AI5555Yelp 新增 Check for Me 功能,用户可在应用内输入人数和电话,由AI代理致电餐厅查询等候时间并短信告知结果;同时更新AI助手整合 OpenTable 支持预订,并增强个性化与历史记录功能;推出付费产品 Smart Lead Reply 帮助商家自动回复客户并筛选潜在客户,每月收费30美元。
 Mistral AI同一件事 · 3 家
Mistral AI 推出 Voxtral 3,包含 50+ 语言实时多步对话的尖端语音模型和语音代理 SDK,其语音转文本模型 Voxtral Small Transcribe 3 在 FLEURS 45 基准中 Forced WER 0.9%。
各家口径不同:The Decoder 提到文本转语音模型(Voxtral Mini TTS 3),而第一份报告没有详细说明。
 Google Developers Blog
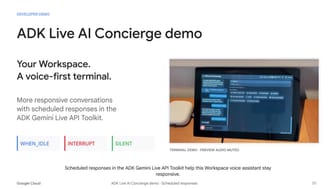
使用 ADK 和 Gemini 3.8,通过流式工具和异步函数实现非阻塞语音交互,将销售报告工作流的首次响应时间从 14.4 秒缩短至 1.2 秒,支持零静默、进度更新和并行对话。
 Inception Labs Blog
Inception Labs 推出 Mercury Voice 扩散大语言模型,专为语音智能体设计,推理、调用工具并遵循长系统提示,首答延迟低于 320 毫秒,在代理和语音基准上击败 GPT-6 Luna 和 Gemma 4 31B。
Inception Labs BlogMercury 2 是首个推理扩散语言模型,在标准 NVIDIA GPU 上每秒解码 1000+ 个 token,将推理成本从 3 秒静默降至 300 毫秒。
 蚂蚁 inclusionAI · Hugging Face 新模型
inclusionAI/Ming-3.0-asr-tiny 结合 Ling-tiny-v3 语言主干和音频编码器,支持单轮中英语音转写及15种方言识别,通过热词或对话上下文提升专业术语识别率,模型参数量未提及,在嘈杂语音和5个应用领域完成评测,提供PyTorch/Transformers推理示例及MIT授权。
 Apple Machine Learning Research2727
Whisper-small 在 CS-FLEURS 基准测试中实现 14 种语言对的平均 F1 分数 0.798,优于 CNN 的 0.776 和 HuBERT 线性基线的 0.751。该方法通过识别预训练语音编码器中的语言选择性隐藏状态维度,直接从语音中检测语言转换,仅需少量代码转换数据集即可微调决策规则。
 Baseten Blog
Gradium TTS 模型将文本转为语音,专为实时 AI 语音代理交互设计,Coval 基准测试中中位数 TTFA 为 214 ms,独立评测将其归为快于人类语音响应层级。
 OpenAI News5555
Higgsfield 推出 GPT-6 Astra、GPT-Image-2.5 和 GPT-Live,支持创作者制作更长的视频、实现精确的视觉效果,并提供语音电影制作的路径。