IT之家 · AI6767
DeepSeek 完成150亿美元新一轮融资,“联想系”投资者入局
DeepSeek 完成第二轮私募融资,筹资150亿美元(约合1003.23亿元人民币),投资者认购意愿强烈。本轮融资前估值约740亿美元(约合4949.29亿元人民币),部分现有股东追加投资,新加入者包括石溪资本、君联资本和吉利。公司正加速推进IPO,争取明年年初在上海上市,年化收入达10亿美元(约合66.88亿元人民币)。
IT之家 · AI6767DeepSeek 完成第二轮私募融资,筹资150亿美元(约合1003.23亿元人民币),投资者认购意愿强烈。本轮融资前估值约740亿美元(约合4949.29亿元人民币),部分现有股东追加投资,新加入者包括石溪资本、君联资本和吉利。公司正加速推进IPO,争取明年年初在上海上市,年化收入达10亿美元(约合66.88亿元人民币)。
IT之家 · AI同一件事 · 2 家DeepSeek、MiniMax 已顺利履行登记手续,完成开源和海外授权使用。绝大部分人工智能技术仍可以自由出口,海外本地化部署属于技术出口管理范围。
 Prime Intellect Blog3838
Prime Mega MoE 通过融合反向传播内核,使 DeepSeek 的 Mega MoE 内核可用于训练,相比默认 PyTorch 实现 MoE 内核速度提升高达 3.11 倍,相比 Prime-RL 基线端到端训练速度提升 1.34 倍。
 36氪 · AI同一件事 · 2 家6565
DeepSeek、MiniMax两家头部企业已顺利履行登记手续,完成开源和海外授权使用。商务部修订的《中国禁止出口限制出口技术目录》中涉及23项人工智能领域技术,引发外界对政策转向的疑问。此次开源和授权使用表明,《目录》的核心是划定边界而非单纯限制AI技术对外出口。
 TechCrunch · AI
深度求索(DeepSeek)在美国被要求移除AI技术两天后,宣布完成约150亿美元融资,创中国最大融资轮记录,潜在投资者包括宁德时代和腾讯;此前该中国AI实验室于6月完成超70亿美元估值、7亿美元融资,并计划明年中国IPO,其开放推理模型曾引发全球关注。
 机器之心同一件事 · 3 家6565
DeepSeek开源了其支撑大规模推理服务的基础框架DeepInfer及配套token编解码组件deepseek-recipe,采用Apache 2.0许可证。DeepInfer是DeepSeek推理服务核心,框架开源后用户可计算AI毛利达82%。
IT之家 · AI5050一汽-大众捷达 M6 今日上市,提供 465 Pro(7.98 万元)、555 Max(8.98 万元)、555 Ultra(9.98 万元)三种配置,搭载地平线征程 6M 芯片支持城区/高速 NOA、跨层记忆泊车,OTA 后支持车位到车位全链路领航;内置千问+DeepSeek+豆包三大模型,配备 113kW/145kW 驱动电机,续航 465km/555km。
 MarkTechPost同一件事 · 3 家
DeepSeek 开源了 DeepInfer 推理框架,该框架用于运行其生产服务并支撑 DeepSeek-V4.1-Flash。
 SemiAnalysis
深求索在国庆节前夕发布了 TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA 及 DeepSelect 的 Ascend 支持,华为提供硬件和原生软件栈,深求索贡献工作负载和工程能力,双方互补以优化模型性能。
 The Decoder5353
Inception 的扩散语言模型 Mercury 3 在 12 项基准测试中 8 次领先,在 SWE-Bench Atlas 上以 51.08 分击败 GPT-6 Luna 和 Claude Haiku 5.5。该模型在 Nvidia GPU 上以每秒 1,068 tokens 的速度运行,比竞争对手快 4-8 倍,且支持 100 万 tokens 的上下文窗口。
The Decoder5858美国国土安全部要求民事联邦机构从 IT 系统中移除 DeepSeek 产品,并禁止采购基于其开源模型构建的第三方软件,中国外交部和商务部要求撤销禁令并称将采取反制。
 Latent Space
DeepSeek 发布开源推理引擎 DeepInfer,支持分布式推理、推测解码等,单集群每日处理 155T tokens,96% 输入缓存命中率,单卡时程收入 38 美元/小时,80% 利润率,81 天投资回报。引擎基于 vLLM 并添加缓存优化,但 KV 缓存管理和负载均衡组件未完全开源。vLLM 团队报告在 GB200 上解码吞吐量与 DeepInfer 相近。
The Decoder6969美国国土安全部禁止联邦民用机构使用中国实验室 Deepseek 的 AI 技术,要求移除现有产品并禁止购买新产品,涵盖其附属公司及第三方服务,但未设定具体时间表或说明具体安全顾虑。该禁令基于 2018 年美国联邦采购供应链安全法,但未明确相关安全问题或机构需完成移除的时间。此前美国政府曾考虑对中国开源大模型采取措施,但最终因多方反对而暂缓。
The Decoder同一件事 · 3 家7272DeepSeek 以 Apache License 2.0 开源内部推理框架 DeepInfer,该框架是支撑 V4.1-Flash 模型大规模快速出答案的服务软件。
TechCrunch · AI7171美国国土安全部下令联邦机构停止采购中国AI初创公司DeepSeek的服务与产品,并从政府IT系统中移除,因国家安全顾虑涉及其在中国运营。该命令超出禁止DeepSeek自身产品范围,涵盖使用DeepSeek技术构建的第三方产品与服务,机构可申请例外。国土安全部担忧DeepSeek处理用户数据,警告美国政府用户敏感信息可能依据中国法律被中国当局获取。
 Interconnects6565
DeepSeek发布了552B参数的DeepSeek V4.1 Flash 1017模型,支持图像输入且采用MIT许可,性能价格比突出;美国国土安全部限制DeepSeek公司及模型参与联邦民用采购,中国商务部要求前沿AI模型国际共享需获政府预审批。
 Liquid AI Blog
LFM2.5-24B-A2B 是一个 240 亿参数的推理模型,仅使用 20 亿活跃参数,适用于设备端的快速智能体。该模型在五个关键基准测试中与 Qwen3.6-35B-A3B 竞争,速度比同类模型快 1.7 倍,且开源可用。
The Decoder7070ARTEX,一个使用 DeepSeek v4.1-flash、GLM-5.3 和 Grok 4.6 AI 模型的开源渗透测试工具,被疑似中文攻击者在 2026 年 9 月底至 10 月初攻击韩国多家金融机构,窃取大量数据,包括 Shinhan 银行超过 25,000 条记录。该事件凸显了 AI 工具加剧单点大规模网络攻击的风险。
 LangChain Deep Agents releases1212
LangChain Deep Agents 0.1.80 发布,修复了在打开选择器时保持会话记录位置的 Bug,并改进了技能路径处理和缓存过期通知功能。
 DeepSeek · Hugging Face 新模型
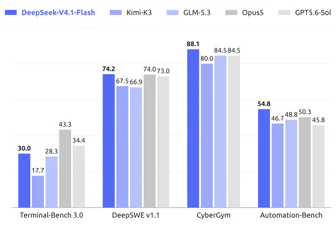
DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,支持高达一百万 token 的上下文,原生处理图像和文本并自回归生成文本。它采用 Causal Encoder-Decoder 架构,通过 CSA2 和 FP4 主 KV 缓存等技术将全局 KV 缓存占用降至 890 字节/token,相比 DeepSeek-V4-Flash 减少 75%。
DeepSeek · Hugging Face 新模型DeepSeek-V4-Flash-Vision-Exp 发布,DeepSeek-V4 家族首个实验性多模态模型,在 DeepSeek-V4-Flash 架构基础上集成视觉模块并持续训练以解锁视觉理解能力。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-2,包含 20 项复杂强化学习任务及验证推理轨迹,支持从消费级 GPU 到超大规模集群的异构计算,采用 DeepSeek-R1-0528 模型生成数据并标注难度。
Prime Intellect BlogDeepseek-R1 发布 SYNTHETIC-1 开源推理数据集,含 200 万条协作生成的推理轨迹,涵盖数学、编码和科学任务,通过特定任务验证器确认正确性。发布包含正确与错误推理轨迹的原始数据及 90 万条精选 SFT 子集,为 R1 迄今最大 SFT 数据集,并提供偏好调优数据集。发布 7B 参数的 SYNTHETIC-1-SFT-7B 模型,验证数据集通过监督微调能有效提升模型推理能力。
 Dify Blog6565
Dify 低代码平台与 DeepSeek R1 结合,可快速构建企业级多语言文档翻译工具,通过可视化工作流实现文档解析、风格化翻译和批量处理,无需复杂编程即可提升跨语言协作效率。
Dify BlogDeepSeek R1 在 AIME 数学竞赛中表现优异,准确率从 15.6% 提升至 71.0%,并在 Codeforces 编程竞赛中达到 96.3% 的人类水平,展示出强大的推理能力。
Prime Intellect BlogDeepSeek 发布 SYNTHETIC-1 数据集,包含 140 万个经过验证的数学、编程和科学推理任务及验证器,利用 DeepSeek-R1 生成,旨在提升推理模型训练水平。该数据集允许用户贡献计算资源参与分布式强化学习,并开源 GENESYS 框架以支持合成数据生成与验证。
Dify BlogDify 与 DeepSeek 结合,可部署私有 AI 助手并构建本地 DeepSeek R1 + 网络搜索应用。Dify 支持部署 DeepSeek R1:7B 模型(175B 参数),集成网络搜索与文档分析,提供 1000+ 模型支持,确保数据完全私有化。通过 Ollama 管理 DeepSeek 模型,在 Dify 平台上创建聊天机器人或工作流应用。