The Verge · AI6565
Meta Muse AI代理新增语音模式与动态表情头像
Meta允许用户实时与Muse AI代理进行语音对话,CEO马克·扎克伯格宣布该功能已向部分用户推送。在iOS应用中,Muse代理的头像会根据对话内容实时动画,用户可通过询问代理或浏览头像设置中的选项来调整语音语调。该语音模式在美国地区现已上线,并将很快应用于Meta的AI眼镜和即将推出的Muse Charm设备。
The Verge · AI6565Meta允许用户实时与Muse AI代理进行语音对话,CEO马克·扎克伯格宣布该功能已向部分用户推送。在iOS应用中,Muse代理的头像会根据对话内容实时动画,用户可通过询问代理或浏览头像设置中的选项来调整语音语调。该语音模式在美国地区现已上线,并将很快应用于Meta的AI眼镜和即将推出的Muse Charm设备。
 TechCrunch · AI6565
硅谷初创公司 Aina 发布智能戒指 Aina AI Ring,售价 399 美元,集成屏幕、摇杆和麦克风,可通过麦克风与 AI 智能体交互、记录笔记、接听电话,并作为 AI 和非 AI 应用的控制器。该戒指支持手势操作,可与 Mac 和手机屏幕交互,控制音乐或智能家居设备。Aina AI Ring 已开始预售,将于 2027 年 1 月发货。
 Hugging Face Blog精选7272
Phonon 发布可在本地设备运行的小型 TTS 模型,无需服务器和网络,提供约 65 MB 和 75 MB 两个版本,覆盖英语、法语、德语、西班牙语和葡萄牙语。
推荐理由: 原文交代了端侧 TTS 的模型规格、开源许可与榜单表现,可据此判断小模型在本地语音场景的可用边界。
 IT之家 · AI6565
Rollme 推出 AuraCam 头戴式耳机,配备 800 万像素摄像头和电子防抖,支持 OpenAI 图像识别与实时翻译功能,售价 89.99 美元。耳机具备会议录音、拍照录像功能,通过按钮同步至手机 App,支持蓝牙 5.4 和 Wi-Fi 6,续航最长 50 小时。
IT之家 · AI6565比亚迪腾势 Z9S 今日完成首次 OTA 更新,AI 超级智能体迪迪虾正式上车。新增代言人王力宏场景播报功能,并增加磁吸玩偶主题联动、无麦 K 歌、AI 日报等新功能。
TechCrunch · AI6565Apple 在 iOS 27.3 和 watchOS 27.3 开发者测试版中推出 Siri Recaps 功能,允许 Apple Watch Series 12 用户检测重要声音、识别歌曲、回顾对话和记录笔记。
 MarkTechPost6565
Soniox STT v6 是其语音转文本 API 的最新版本,通过读取智能体语音并实时分析其文本内容,实现更精准的对话识别和回声消除。该模型支持 60 多种语言,提供 stt-rt-v6(流式)和 stt-async-v6(文件)两种版本,运行于 Soniox 云 API(仅 WebSocket 流式和异步 REST),无自托管或设备端选项。
IT之家 · AI6565苹果在 iOS 27.3 Beta 版中扩展 Siri AI 功能,新增支持繁体中文,总支持语言达 10 种;覆盖日历、文件等 15 款 App,可管理文件、定时发送信息等复杂任务;Safari 支持通过 Siri 清除历史、管理标签页。
The Verge · AI6565Siri 可通过新 watchOS 27.3 开发者 Beta 版的音频智能功能接入 Apple Watch 麦克风,新增 Siri Recap 和 Live Rewind 功能,分别生成对话摘要和 15 秒音频文本转录,支持双击数字表冠调出,并可通过 Siri 应用保存;Health 应用也迎来重设计,增加健康洞察、个性化推荐和教育内容
 AWS Machine Learning Blog3838
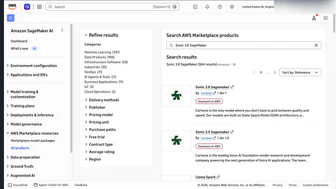
Cartesia 利用专为实时语音 AI 设计的状态空间模型(SSM)和 AWS 基础设施,实现亚 100ms 的文本转语音和语音转文本,支持 44 种语言语音克隆,适用于虚拟助手、客服中心等场景。Sonic 模型在约 90ms 内生成首个音频字节,Ink 模型具备原生话轮检测和噪声鲁棒性,API 接口支持实时流式输出。
TechCrunch · AI6565Apple Watch 的 AI 驱动的“音频智能”技术开始 Beta 测试,初期包含四个可选功能:检测重要声音、识别歌曲、回放对话片段和生成对话摘要。回放功能允许用户回顾最近 15 秒的对话,而 Siri Recaps 则能总结对话要点,不记录原始音频或识别说话人。
 量子位6060
Orilo 通过语音优先策略,在早晨场景提供个性化新闻速递和长尾信息监控,支持跨应用任务执行,实现低交互摩擦。其双层网络架构实现1.08秒的快速响应,但牺牲部分鲁棒性。团队百川联创此前推出「来福电台」,验证了「早晨」场景的PMF。
 Hugging Face Daily Papers5959
Apriel Voice 27B Preview 是一个开源语音语言模型,通过两阶段训练流程(含在线蒸馏)整合语音理解、推理和工具使用,在音频基准测试中表现优异。
IT之家 · AI4040明治蘑菇山无线耳机 Pro 启动众筹,是 2024 年原版的升级复刻型号,采用镀金 FPC 触控传感器,配备 10mm 动圈单元,支持 74 种语言和 70 种变体 AI 同声传译,准确率达 98%,众筹价约 1,343 元人民币。
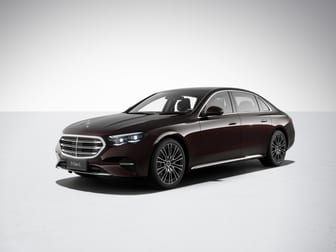
IT之家 · AI42422026款奔驰E300L改款轿车上市,建议零售价42.38万元至50.98万元,起售价下调1.6万元。该车首次搭载由奔驰中国研发团队主导开发的全新AI智能座舱,融合豆包AI大模型,支持季度性大版本OTA升级。
IT之家 · AI6565阿里千问 AI 眼镜今日迎来 OTA 升级,新增通话翻译、媒体翻译等功能,抗噪能力再升级。新增通话翻译支持跨国实时翻译,媒体翻译支持海外播客、外语网课、外语大片的实时翻译,译文同步显示于千问 AI 穿戴 App。
Hugging Face Blog4040MonsterHouse 是一个用 NVIDIA Nemotron Voice Agent、NVIDIA Nemotron ASR、NVIDIA Nemotron 3.5 Bolt E4B 4GB、Magpie TTS Zeroshot 和 Audio2Face-3D 构建的互动投影,能通过语音与访客交流并模仿脾气暴躁的老海盗声音。
MarkTechPost5858Edge0 发布开源文本转语音模型 Audio8-TTS-Realistic,0.6B 参数量支持 23 种语言零样本语音克隆,在 CV3 基准测试中平均误差率 4.86% 优于 Qwen3-TTS-1.7B 和 VoxCPM2,但低于 4B 级别的 Higgs TTS 3。模型采用双自回归架构,包含 24 层宽度 896 的慢分支和 4 层并行预测快分支,并使用学习型真实感评论家进行训练。
IT之家 · AIiPhone 版 Claude 语音模式现已支持 Apple CarPlay,用户可在驾驶途中直接向 Claude 提问;Anthropic 还预告 iPhone 和 iPad 端将支持下拉搜索功能,并支持同时保持多个账号登录切换。
TechCrunch · AI5050Granola 在 Mac 上推出语音转文字功能,用户可按“Fn”键说话并自动生成文本,支持跨应用使用且免费。该功能将在 iOS 和 Windows 平台上线。Granola 和 Wispr 分别估值 15 亿美元和 20 亿美元,均聚焦语音应用,但前者专注会议自动化和笔记,后者则通过研究实验室探索人机界面。
 Codex releases4545
Codex 0.166.0 发布,新增键盘驱动转录选择(支持词、行、页操作)、集成搜索和可配置快捷键,以及 Markdown 在异步问题、选项、答案和转录回复中的一致性渲染。同时支持 GPT-6.1 Terra,并添加 codex queue --resume 功能以恢复卸载线程。
TechCrunch · AI6565亚马逊在节假日前为 Alexa 增加了 100 多项新的购物相关功能,包括订阅和清单管理、更新配送说明、解决支付问题和回答有关 Prime 订阅的问题。该更新允许用户使用 Alexa 创建、注册、查看清单内容以及添加或编辑项目,管理订阅,例如将物品的配送频率从每月一次改为每三个月一次,并编辑配送说明,如更改地址或添加提货详情。
TechCrunch · AIDeepgram 收购 Pipecat 开源语音 AI 基础设施商 Daily,将保持 Pipecat 开源,此举将帮助 Deepgram 深入理解实时语音和视频基础设施
Hugging Face Blog5050Hugging Face 发布开源语音识别 AnySpeechRecognizer 和决策模型 AnyDecisionModel,支持 NVIDIA Parakeet 和阿里云 Qwen3-ASR 等引擎,可在苹果平台本地运行。
MarkTechPostAssemblyAI 发布了其首个文本转语音模型 AssemblyAI-TTS-1,面向实时电话呼叫中的语音代理,价格定为每 1M 字符 15 美元,无年度合同且支持无限并发。该模型在 AssemblyAI 的测试中实体准确率达 93.7%,与 ElevenLabs v4 相当,但价格仅为其五分之一,首次字节中位时间 47 毫秒,但在 Cekura 的独立基准测试中流式延迟中位数为 159 毫秒。
MarkTechPost同一件事 · 5 家Block 宣布仅基于人类对话语音训练的全双工语音模型 Dessa,该模型无需文本或预训练模型,在 1 个包含 72 个 Blackwell GPU 的 NVIDIA GB200 NVL72 机架上进行训练,可在 MacBook Pro M4 Max 上本地运行且速度超实时,目前仅提供研究预览和等待名单。
各家口径不同:The Verge 提及模型对话偶有'生硬和诡异'表现;The Decoder 和 TechCrunch 没有提到这一点。
IT之家 · AI精选同一件事 · 4 家7878英伟达于 10 月 28 日推出开放权重语音转录模型 Nemotron 3.5 Transcribe,整合转录、说话人归属、翻译和音频问答,采用 MoE 架构,总参数约 340 亿、激活参数约 43 亿,可处理最长 1 小时录音,支持 40 种语言转录、最多区分 8 名说话人。
推荐理由: 英伟达开源语音转录模型,公开了参数规模、多语言与说话人分离能力及榜单成绩,可对照现有开源 ASR 方案。
MarkTechPost精选同一件事 · 4 家7171NVIDIA 发布 Nemotron 3.5 Transcribe,这是一个开放权重的语音大模型,单模型支持 40 种语言、最长 1 小时音频,并可输出逐字稿、书面体、说话人标注和翻译结果。
Hugging Face Daily PapersFalcon是一个因果音视频目标说话人提取模型,通过目标说话人嘴部视频从嘈杂重叠语音中提取其声音,结合单次多尺度时频分离器和编码器空间说话人对比损失,在不增加推理成本的情况下减少干扰说话人泄露。
IT之家 · AI6565巴慕达推出 AI 个性化电台服务 BALMUDA Good Morning Radio,可根据用户生活习惯与兴趣生成约 10 分钟的每日播客。该服务计划于 2026 年 11 月 2 日起面向 The Clock 时钟用户开放 Beta 测试版,未购买时钟的用户也可通过 BALMUDA Connect 应用申请测试(限量 1000 名)。
 36氪 · AI
Nemotron 3.5 Transcribe 开放权重语音模型已支持 RTX Spark,可实现语音转录、说话人识别及翻译,支持 40 种语言。Liquid AI 的 LFM3 系列模型也已获得支持,可在本地运行并进行微调。RTX Spark 笔记本起售价 2599 美元,最高配备 128GB 统一内存,FP4 AI 算力最高达 1 petaflop。
 Databricks Blog
Databricks 发布语音智能体,通过实时上下文决策在对话中调整响应,实现语言切换、转接人工或提供个性化服务。该智能体需 200 毫秒内处理客户请求,依赖 Databricks 提供的上下文、本体和治理能力,整合客户、订单、产品和政策数据,并遵循企业数据目录的访问规则。
 The Decoder精选同一件事 · 4 家7171
Nvidia 发布开源语音识别模型 Nemotron 3.5 Transcribe,支持 40 种语言转写、31 种语言与英语互译、13 种语言的说话人识别,可处理最长 1 小时、最多 8 人的录音。
TechCrunch · AI同一件事 · 4 家英伟达发布开源语音转写模型 Nemotron 3.5 Transcribe,支持 40 种语言转写,含 30 亿参数,可在 Jetson AGX Thor 和 DGX Spark 芯片上运行。该模型能翻译 31 种语言、区分 8 个说话人,并在 Hugging Face Open ASR Leaderboard 基准测试中超越竞品,但仅支持录制音频。
Hugging Face Blog精选7878NVIDIA 发布开源权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答合入同一 checkpoint,支持 40 种语言转写、31 种语言与英语互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。
推荐理由: 原文给出多语言转写、说话人分离与翻译的统一权重模型,并附开放数据管线和微调配方,可据此判断语音场景的适配路径。
IT之家 · AI3535全新捷途自由者 7 将于 11 月 4 日上市,搭载灵犀智舱 TOUR OS,内置 DeepSeek+ 讯飞星火 双加持的 AI 语音大模型,搭载 2.5K 超清巨幕 + 高通 8155 芯片。此外,该车还支持 APA 全场景自动泊车。
 OpenAI News
GPT-6 Astra 成为 Retell 语音代理基准测试的领先者,Codex 则帮助其实现人均年营收 160 万美元的营收规模。
 Ollama releases
Liquid AI 发布 LFM3 小模型家族,包含 1.7B 参数的 lfm3 文本模型(256K token 上下文)、支持图像理解的 lfm3-vl、18 语言语音处理能力的 lfm3-audio 及通用模型 lfm3-omni,用于本地智能体和结构化输出;d1 决策模型升级至 2B 参数,支持文本、图像及音频决策,部分模型支持苹果硬件。
Ollama releasesLiquid AI 发布 LFM3 小模型家族,包含 1.7B 参数文本模型 lfm3 及支持图像、音频功能的变体,上下文窗口达 256K tokens;d1 决策模型升级至 2B 参数,支持文本、图像及音频推理,Apple 硬件已支持 rc1 版本。
36氪 · AI6565千问办公接入乐奇AI眼镜,用户可在“RokidAI”App添加“千问办公”智能体,绑定账号后通过语音唤起模型下发任务并在眼镜端查看结果。