量子位5858
openJiuwen Agent-Memory 如何实现视听双流记忆,看懂长视频
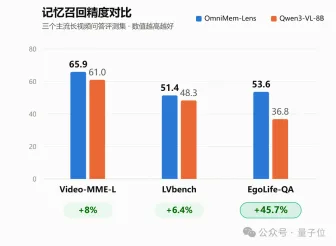
openJiuwen Agent-Memory 0.2.0 版本上线多模态记忆能力 OmniMem-Lens,通过视觉和听觉双流理解视频事件,召回精度最高提升 45.7%,在线问答时延最高降低 97%。该技术按真实事件切分记忆,建立三层记忆结构,实现离线建好在线查,在 EgoLife-QA 评测集上表现突出,视频越长时延降低越明显。
量子位5858openJiuwen Agent-Memory 0.2.0 版本上线多模态记忆能力 OmniMem-Lens,通过视觉和听觉双流理解视频事件,召回精度最高提升 45.7%,在线问答时延最高降低 97%。该技术按真实事件切分记忆,建立三层记忆结构,实现离线建好在线查,在 EgoLife-QA 评测集上表现突出,视频越长时延降低越明显。
 IT之家 · AI6565
YouTube 推广 AI 配乐工具“替换歌曲”,创作者可在收到音频版权申诉后,即时生成四首免版税器乐背景音乐替换受版权保护的音频,并自动移除相关 Content ID 版权声明。该功能目前仅生成器乐背景音乐,暂不支持人声或完整歌曲创作。
 Hugging Face Daily Papers6565
研究表明视频世界模型的潜在预测误差反映外观和运动而非可靠测量物理意外。在IntPhys2基准上,潜在预测、掩码像素重建和简单视觉统计的比较显示,外观易于解码,V-JEPA2仅略微揭示事件是否可能。
Hugging Face Daily PapersReviso 是一个通过分层规划和主动感知学习优先考虑关键视觉证据的智能视频字幕框架,提升了字幕质量和下游视频理解能力。多模态大语言模型(MLLMs)生成的视频字幕可能过度强调次要细节而忽略重要上下文和关键事件。
Hugging Face Daily PapersAgent Harness 整合视频生成与世界模型,支持智能体在多镜头视频制作中进行规划、工具使用和递归自改进。该框架协调脚本、拍摄规划、资产管理、生产和编辑,并分析其评估挑战;同时研究智能体与世界模型在观察、控制、执行和状态维护中的交互,以及两者如何互相评估和改进。
Hugging Face Daily Papers3434Venus-DefakerOne2 通过交替 LoRA 和全参数微调及基于熵的测试自适应,将检测扩展到多种伪造形式和媒体类型,在 DeepFake 面部(96.7%)、AI 生成图像(93.3%)、篡改文档(87.6%)等六项基准测试中实现 SOTA 性能,显著优于专家模型和前身 DefakerOne。
 The Decoder4242
Google DeepMind 发布 StreamVibe 视频智能体,该模型基于 Qwen3.5-9B 并经过专门训练,能理解模糊请求并在适当时机提供帮助,在 ProactiveBench 上将响应时机和质量提升 10.7%,主动交互率提高 12.3%。测试显示其优于其他开源模型,但在长视频(>5分钟)中仍难以持续追踪变化指令,性能下降至基准的 38.5%。
IT之家 · AI4242荣耀将推出全新阿莱拍照模式,该模式基于 LogC 曲线设计原理与阿莱 Film Lab 合作,通过 RAW 信号重构全光谱并模拟 35mm 胶片感光曲线及暗房冲印过程,实现电影胶片级成像。
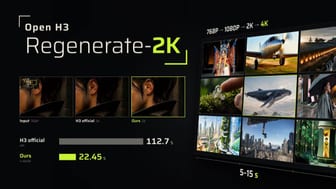
量子位英伟达与麻省理工学院团队开源视频增强方案 Open-H3-Regenerate-2K,基于 MiniMax H3 模型将低分辨率视频重生成 2K(2560×1440)或 4K(3840×2160)视频。
Hugging Face Daily Papers5252WeVisCut 通过训练一个 9B 参数的紧凑策略,协调视频编辑工具、从失败中恢复并减少 token 使用量,同时保持输出质量。该系统采用四阶段数据管道,结合编辑反演和验证重放,从 3,750 个成品视频中生成超过 130K 个训练示例,用于训练单一策略。
 Codex releases4545
Codex 0.166.0 发布,新增键盘驱动转录选择(支持词、行、页操作)、集成搜索和可配置快捷键,以及 Markdown 在异步问题、选项、答案和转录回复中的一致性渲染。同时支持 GPT-6.1 Terra,并添加 codex queue --resume 功能以恢复卸载线程。
量子位精选7272Genspark 发布视频 Agent 工作台 Media Studio,接入 20 多家厂商的 70 多个模型版本,由大语言模型担任导演负责写剧本和调度视频、图像、音频模型。
推荐理由: 作者完整实测了从短剧到知识讲解片的全流程,读者可据此判断多模型编排在真实创作中的完成度与短板。
Hugging Face Daily Papers6565CodeCap-Bench 通过比较代码字幕与自然语言字幕在视频问答和重建任务上的表现,证明代码字幕具有更优的推理准确性和重建保真度。该基准包含 323 个结构化 2D 内容视频,涵盖五个类别,评估发现主流闭源 MLLM 在代码字幕生成上虽表现良好,但难以捕捉复杂时序动态,开源模型差距显著。
Hugging Face Daily Papers6565LociArt通过生成精炼网络、自动化数据集构建和专用基准实现精确的局部视频风格化,支持区域风格控制和时间一致性。GRNStyle在生成精炼网络基础上引入极性风格感知掩码,结合表示-几何条件化技术,实验表明其在区域风格质量和空间控制上优于现有方法。LociArt-100K数据集包含10万局部风格化对,基准包含80个源视频和84个目标掩码,采用风格原型相似度评估方案。
Hugging Face Daily Papers同一件事 · 2 家Hy-Nomas 是一个 8B 参数的扩散模型,支持自由形式文本指令和跨多轮交互的相机控制,通过因果注意力与结构化视频描述相结合的方式遵循多轮文本和相机指令,在人类评估中优于现有世界模型,已开源模型权重、代码和基准。
IT之家 · AI精选同一件事 · 2 家8282谷歌DeepMind于10月27日发布Genie 4世界模型,定位为重大研究里程碑,用户可用自然语言指令实时改变天气、镜头、角色和物体,而非重新生成一段视频。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
IT之家 · AI精选同一件事 · 2 家7777谷歌 DeepMind 推出世界模型 Genie 4,目前处于研究预览阶段,可生成可交互虚拟世界并在运行中输入提示词修改场景,还能生成与画面同步的实时音频。相比前代 Genie 3,Genie 4 画面拟真度提升,支持实时调整天气、镜头角度和增删人物物体,最长维持两分钟连贯场景,为前代的两倍。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
 TechCrunch · AI精选同一件事 · 2 家7272
Google DeepMind 以研究预览形式发布世界模型 Genie 4,可生成照片级真实且可交互的场景,并支持在模拟过程中输入提示词实时改变天气、镜头角度或添加人物物体。
各家口径不同:The Verge 表示模型支持长达两分钟的场景,而 Ars Technica 和 TechCrunch 提到物理和人物模拟的改进,但没有具体说明场景时长。
Hugging Face Daily Papers6565AV-FABLE 引入一个用于长视频稀疏篡改的音频视觉基准,表明冻结的音频视觉大语言模型的感知特征包含最佳通过分离时间解码器而非语言输出恢复的取证证据。长视频中的局部 AI 篡改通常影响其他内容真实的短暂事件,使视频级分类不足以进行取证分析。
IT之家 · AI3535创维自然光壁纸电视 QX 系列发布,85 英寸与 100 英寸版本首发价分别为 41499 元和 61499 元。系列采用四面无边设计、2.7cm 厚度,搭载 OD-MiniLED 背光技术,具备 23040 个独立控色分区、10000nits 峰值亮度,支持 STW 广视角显示。独立主机内置创维与哈曼联合定制的 6.2.2 音响系统,14 个发声单元提供 410W 峰值功率。
Hugging Face Daily Papers6565StreamVibe-Bench 发布包含 4.1K 评估样本和 85K 训练样本的基准,用于测试显式、隐式和动态用户意图交互;StreamVibe-VL 是一个流式主动视频语言模型,通过持续观察推断隐式意图并动态调整交互;StreamVibe-Harness 通过分层内存框架维持用户意图为持久状态,跟踪最新用户意图和环境状态,使主动交互响应一致性提升 12.3%;
IT之家 · AI6565豆包对抖音的引用权重从5月的10.79%飙升至8月的31.8%,每引用3条内容就有1条来自抖音。报告显示,视频标题与提问词的语义相似度正相关,抖音平均引用涨幅51%,关键词覆盖度相关系数更高。
Hugging Face Daily Papers6565这篇综述将视频理解和生成统一于世界建模,围绕推断、合成、分享和交互潜在时间状态来组织进展,强调持续动态而非片段级感知。视频基础模型在理解和生成视觉序列方面迅速发展,而视频世界模型试图捕捉其描绘世界的底层动态。
IT之家 · AI6060即梦 AI 短剧工作室上线,提供自研剧本模型 DreamScript(支持多题材生成、爆款诊断、10 万字长篇解析)、图片模型 Anycook(支持差异化人物设定、多风格场景搭建)和分镜模型 DreamShot(双模式创作、3D 导演台动态预演)。
 36氪 · AI6565
Vivix发布实时交互模型W1和A1,目标降低互动内容生成成本至YouTube水平。W1模型实时生成成本接近YouTube每小时约0.2美金的CDN带宽成本,与目前最头部的视频生成模型相比,实时互动内容的生成成本可低1-2个数量级,用户操作后模型能在300-600毫秒内生成下一帧画面。Vivix团队规模已达150-160人。
IT之家 · AI同一件事 · 2 家3535Grok 发布《奥德赛》系列电影第一集前 7 分钟内容,被指缺乏艺术感染力。该片段由 Grok 与 Wonder Studios 联合制作,部分画面接近真实,但旁白冗长、台词生硬,整体缺乏叙事节奏与共情,与诺兰版形成鲜明对比。
TechCrunch · AI同一件事 · 2 家3535Grok 发布了与 Wonder Studios 合作、由导演 Dev Walker 执导的 AI 生成《奥德赛》七分钟剧集,为该系列的首集。该视频采用实用特效,但缺乏艺术性、灵感或人情味,背景故事冗长,角色台词生硬,与克里斯托弗·诺兰版本相比显得空洞,观众难以产生共鸣。
 腾讯混元 · Hugging Face 新模型精选同一件事 · 2 家7171
腾讯混元在 Hugging Face 发布 Hy-Nomas 的 BF16 Diffusers 格式蒸馏权重,该视频世界生成模型支持通过文本指令和相机控制进行多轮自由交互,逐段生成同一世界。
推荐理由: 官方放出蒸馏版 BF16 Diffusers 权重和配套基准,读者可据此判断多轮交互式世界生成的实际用法与门槛。
 MarkTechPost5858
Kyutai 发布 CADRE,开源因果扩散表示自动编码器专为交互式世界模型设计,将行动延迟降至 230 ms 以下。CADRE 包含 7 个自动编码器,每个约 476M 参数加 86M 冻结的 DINOv3 ViT-B/16,世界模型为 1.2B 参数,视频分辨率为 288×512,帧率为 20 fps,在 1 H100 上运行。
36氪 · AI6565昆仑万维旗下 AI 视频创作平台 SkyProduction 接入可灵 AI 视频生成模型 Kling 4.0,后者是可灵推出的新一代原生多模态 AI 视频创作大模型,在视听表现、创作可控性、叙事连贯性及多元内容生成等方面实现升级。
Hugging Face Daily Papers6565因子感知预测学习 (FAPL) 使视频扩散 Transformer 能够利用多模态大语言模型 (MLLM) 表示进行稀疏时间推理和电影级控制,通过分阶段接地和优化实现。FAPL 在三个电影级视频生成任务(稀疏到视频、因子感知编辑和多镜头生成)上始终优于基线,验证了其在 MLLM 特征使用、时间控制和因子协调方面的贡献。
Hugging Face Daily Papers3838研究人员推出 OmniDR-Bench 基准和评测框架,用于视频中心深度研究智能体,该智能体能合成外部证据生成与视频时刻关联的交互式报告。该任务具有直接实用价值,能帮助用户定位相关视频片段、验证声明、复现演示步骤。OmniDR-Bench 包含 50 个中英文任务,涵盖 19 个现实子类别,共 6,414 条标准,最佳系统得分为 63.3 分。
Hugging Face Daily Papers6565StreamEval 基准测试了交互式流式视频生成模型在五个任务上的表现,发现可靠的请求执行和持续的状态一致性仍是主要挑战。该基准包含 300 个脚本化测试用例,涵盖角色对话、角色表演、世界生成、指令编辑和参考编辑任务,通过四个评估维度(任务执行、状态一致性、视觉保真度和视听协调)进行评分。
 AWS Machine Learning Blog5858
TwelveLabs 的 Pegasus 1.5 视频语言模型现已在 Amazon Bedrock 上提供,可将长视频转换为结构化、带时间戳的元数据,支持基于用户定义标准分析整个视频并返回匹配片段的 JSON 数据,分析时长扩展至每请求两小时,无需预索引且数据保留在 AWS 边界内。
The Decoder7373Kling AI 发布视频生成器 Kling 4.0,支持立体音频、多语言唇形同步及轻量级 Flash 变体,可单次生成 30 秒视频并接受最多 10 张关键帧图像输入,Prompt 理解能力提升至 8,000 tokens。
 NVIDIA Blog
欧洲广播联盟(EBU)与 NVIDIA 合作扩展主权框架,引入云服务商、开源模型开发者及系统集成商,帮助欧洲广播机构在部署智能体时保留数据、基础设施、模型和安全的控制权。
腾讯混元 · Hugging Face 新模型精选7878腾讯混元在 Hugging Face 发布视频世界生成模型 Hy-Nomas,支持通过文本指令和相机控制进行自由形式的多轮交互,逐段生成视频并延续同一世界。模型采用分段自回归 DiT 架构,结合 Qwen2.5-VL-7B 文本编码器、相机条件模块和 PixelUMM 解码器,蒸馏推理配置为 8 步去噪、720×1280 分辨率、24 FPS。
推荐理由: 腾讯混元开源可多轮交互的世界生成模型,给出架构细节与单卡 4090 部署配置,便于评估落地成本。
 O'Reilly Radar6565
《周一早晨代理》项目每两周使用NFL公开数据集分析一个美式橄榄球争议话题,逐步为AI智能体赋予分析能力。该项目使用25万个比赛片段和当前赛季数据,每期让AI解释特定战术(如“建立进攻线”)并验证其分析结果。AI在分析时需说明数据局限性,并拒绝超出任务范围(如预测比赛结果)的请求。
 Comfy Blog5858
Nvidia 的 RTX 视频效果节点已集成到 ComfyUI 中,可在 Nvidia RTX GPU 上本地运行。
 OpenAI News5555
Higgsfield 推出 GPT-6 Astra、GPT-Image-2.5 和 GPT-Live,支持创作者制作更长的视频、实现精确的视觉效果,并提供语音电影制作的路径。