Epoch AI6565
Epoch Capabilities Index 更新采用贝叶斯模型方法论
Epoch Capabilities Index (ECI) 更新采用贝叶斯模型方法论,提供更可靠的模型能力不确定性估计及模型间能力比较概率。新方法基于四参数逻辑斯蒂(4PL)项目反应理论(IRT),使用 Claude 3.5 Sonnet(ECI 130)和 GPT-5(ECI 150)作为锚点模型,通过线性变换固定参数位置和尺度,实现跨时间一致性。
Epoch AI6565Epoch Capabilities Index (ECI) 更新采用贝叶斯模型方法论,提供更可靠的模型能力不确定性估计及模型间能力比较概率。新方法基于四参数逻辑斯蒂(4PL)项目反应理论(IRT),使用 Claude 3.5 Sonnet(ECI 130)和 GPT-5(ECI 150)作为锚点模型,通过线性变换固定参数位置和尺度,实现跨时间一致性。
 36氪 · AI精选7272
TypeSafeAI 9月中旬发布决策模型 Jev,只输出是/否、评分或概率,上线数周用户破百万,财富500强约三分之一企业开始使用,24天内估值从约 2 亿美元升至 75 亿美元。
推荐理由: 从决策模型爆红到物理世界端侧判断,呈现AI能力分工从生成转向可度量决策的产业变化。
 IT之家 · AI6565
开源项目 npu-driver 通过 NPU 渲染 Win11 桌面,刷新率仅 2-3Hz,目标 30Hz。该项目采用 Apache 2.0 协议,已在搭载英特尔 Panther Lake 处理器的设备上测试,能基本运行桌面及应用窗口,并能在必要时切换回 GPU 渲染。
IT之家 · AI2222英飞凌推出首款采用 RISC-V 架构的全新汽车微控制器平台 AURIX RC1,该平台最多可集成 12 个 32 位处理器内核、1 个面向边缘 AI 的高级并行处理单元及最高 40MB 嵌入式存储,计划于 2027 年上半年提供样品。
 AWS Machine Learning Blog2828
Amazon Bedrock 现在支持在印度境内对 Kimi K3 进行推理,满足严格的数据本地化需求。客户 Ultrahuman 通过 API 调用该服务,使 AI 健康助手能处理每日超 14,000 次对话,同时将健康数据保留在 AWS 内部,成本降低 80%,多轮对话速度提升 85%。
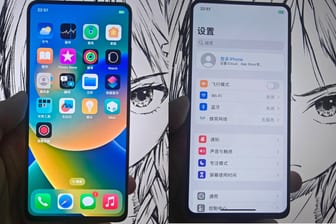
IT之家 · AI6565开发者“你说喜欢是装的”为小米 REDMI K20 Pro 手机刷入苹果 iOS 16.5 测试固件包,支持双系统与数据持久化,需清除安卓数据并替换 TWRP Recovery,可通过正常启动或 Root 权限下的 Magisk 模块切换系统,但开发者强调该方案为测试版本,存在变砖风险。
IT之家 · AI6565高通 AI Hub 面向中国开发者开放,集成 Models、Workbench、Apps 及 GenieX 框架,提供超 230 个预优化模型库和云端调优工具。开发者可通过官网、设备农场和论坛获取支持,加速终端侧生成式 AI 和智能体 AI 开发。
IT之家 · AI爱信与东北大学合作开发全球首款集成 STT-MRAM 的 16nm AI SoC,采用近内存计算设计,实现 50 倍目标检测能效。该 SoC 通过 8/16 位混合乘法架构和权重共享技术,利用 Tiny YOLOv3 在 32MB 片上 STT-MRAM 内完成目标检测,开机启动时间缩短 38.59 倍,AI 处理速度提升 10.16 倍。
IT之家 · AI高通 HBC 技术在美国圣迭戈实验室完成硬件验证,其第一代方案为 AI250 加速卡提供 133 TB/s 内存带宽,相比 AI200 提升 18 倍。该架构通过多层 LPDDR 内存堆叠实现近存计算,计划于 2027 年上半年出样。
IT之家 · AI6565用户 Infinite-Zombie5875 改造 2009 款索尼 NW-X1060 Walkman 跑通 ESP-NOW 通信,保留原装 Marvell 无线芯片,实现低侵入式改装。项目通过逆向解析固件收发链路,添加 ESP-NOW 动作帧接口和原生 C 语言 API,演示了跨设备联动的水族画面同步。
 量子位精选同一件事 · 2 家7070
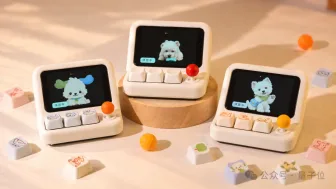
小米技术委创新产品团队开源 AI 硬件 HachimoDock(哈基米机),硬件自制成本约 150 元,可语音指挥电脑端 Agent 执行任务并同步显示任务状态。该设备还支持自定义桌宠形象、用自然语言生成分钟级组件,并通过小米开源项目 xiaomi Miloco 联动控制智能家居。软件源码已在 GitHub 公开,嘉立创平台提供物料清单、结构件模型和装配教程,其开发板与屏幕等元器件出现涨价和缺货。
量子位同一件事 · 2 家5858新芯航途发布 X7 Ultra 芯片,首次用“大模型算力”描述性能,NPU 算力达 700TOPS 且利用率 98.7%,量化模型输出与 FP32 基准模型相似度超 99.99%,内存带宽消耗降低 80%,能效提升 100%。该芯片专为量产智驾大模型设计,采用超大核 NPU 架构和专用计算引擎,配合 AI 工具链优化,支持千线级激光雷达处理和摄像头时延抖动优化,搭载 Arm v9 车规级 CPU,ASIL-B/ASIL-D 安全标准。
 NVIDIA Technical Blog6565
开发者在边缘构建新一代智能体,用于监控驾驶员注意力和车厢条件、帮助机器人理解环境规划任务、协调生产线上的机器集群,这些物理 AI 应用需要感知、推理和行动的模型,在严格的内存、功耗和延迟预算内运行。
IT之家 · AI精选7878小米开源轻量级文档理解模型 Xiaomi-OCR-0,参数规模 0.8B,权重与推理代码已上线 Hugging Face 和 GitHub,单一模型覆盖文档解析、关键信息抽取与 OCR 视觉问答三类任务。
推荐理由: 0.8B 参数在 OmniDocBench v1.6 上位列总榜第二,且权重、MCP 服务与 Skill 工具包一并开放,可据此判断小模型做文档解析的边界。
IT之家 · AI6565今日宜休发布 iFlow 智能温控系统,9999 元起售,支持 BCG 无感监测、双人独立监测、AI 分区控温。系统搭载 MTK Genio 420 端侧 AI 计算平台,可本地运行 ISHO 生理信号大模型,实现动态温控。Pro 版升级至 512 点柔性压力感知阵列,支持 55℃ 高温除螨。
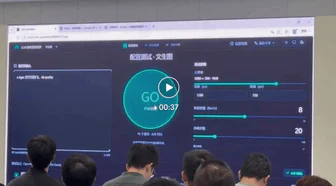
量子位精选7272天数智芯发布基于天枢架构的云端通用GPU天垓300和端侧产品彤央TY1200,并在现场随机出题与英伟达H200、Jetson Thor T5000对比。
推荐理由: 现场随机出题、云端与端侧双线对比英伟达,并给出可复现的实测数字与软件栈落地方式。
IT之家 · AI同一件事 · 2 家4242XHEART 新芯航途发布大模型芯片 X7 Ultra,算力达 700 TOPS,量产模型实测 99.99% 对齐,内存带宽消耗下降 80%、能效提升 100%。芯片内置高精度算子加速引擎,原生支持 FP16/FP32 计算,中国首发量产 Armv9 车规级 CPU,性能提升 20%、能效提升 10%。
IT之家 · AI苹果发布配备 PROLED XDR 显示屏的首款触控 MacBook Pro,其 M5 Max 芯片版配备最高 128GB 统一内存,可本地运行数千亿参数大语言模型,支持 LM Studio 等应用,售价 22,999 元起。
IT之家 · AI精选7272天数智芯在 10 月 28 日上海媒体开放日首次公开展示天垓 300 通用 GPU 实机运行,称其为国内首个实测性能达到英伟达 H200 水平的通用 GPU,第三方实测折算单卡整体吞吐为 H200 的 1.05 倍,但具体测试方法、模型负载和工作负载条件尚未公布。
推荐理由: 天数智芯首次公开天垓 300 实机运行,并给出与 H200 的吞吐对比及超节点成本测算,可据此观察国产 GPU 的落地进展。
IT之家 · AIOpera 推出一项名为 WebAI 的新 Web 标准,允许用户直接在浏览器中运行 AI 模型,无需依赖云端服务。WebAI 兼容多种开放权重 AI 模型,如谷歌的 Gemma 和苹果的端侧基础模型,目前已在 Opera One 浏览器中提供早期预览版,其他 Opera 浏览器也将很快支持。
 Browser Use
Cloudflare 由于自动化特性(navigator.webdriver 为真,Playwright 默认无头壳用户代理不显示 HeadlessChrome)经常封锁标准无头 Chrome,并且通常来自云服务器 IP、无 Cookie 启动。
 MarkTechPost精选7171
据 Hugging Face 博客和 MarkTechPost,每个模型均可在单张 GPU 上微调;文本模型 LFM3-1.7B 为 1.73B 参数、256K 上下文窗口,4-bit 量化下约 1 GB 内存即可运行,可部署在手机、笔记本、私有服务器或云端。MarkTechPost 称免费商用上限为年营收 1000 万美元,完整 128K 上下文需 1.6 GB KV 缓存。IT之家称 LFM-1.7B 参数比上代 LFM2.5-2.6B 减少 35%,性能却更优。
推荐理由: 6 个 2B 级开源模型共享同一骨干,并给出与 Qwen3.5-9B 等竞品的逐项对比,可据此判断小模型在端侧与智能体任务上的位置。
量子位千里科技推出AI 4D毫米波雷达,内置10 TOPS NPU,支持本地AI感知与卫星架构并行输出,实现从天线设计到点云输出的端到端AI处理。该雷达点云密度增强10倍,探测距离提升40%,鬼影消除率达95%,空间角分辨力提升12倍,提供边缘侧、卫星架构及兼容三种工作模式,以适应不同功能等级和平台需求。
 Hugging Face Blog精选7676
Liquid AI 发布 LFM3 新一代 Liquid Foundation Models,以 LFM3-1.7B-Base 为共享骨干派生六个 2B 级模型,覆盖文本、视觉、音频、全模态和决策,全部在 Hugging Face 开放权重。
推荐理由: Liquid AI 用同一 2B 级骨干派生六个模态模型,并给出单卡微调与端侧部署路径,可据此判断小模型专用化路线。
IT之家 · AIOllama 于 10 月 24 日宣布其 Mac 应用正式支持文本转语音(TTS)生成,首个支持的语音模型是 Gradium 开发的 Phonon 系列,用户无需依赖云端服务,可在 Apple Silicon Mac 上运行。在搭载 M5 Max 芯片的 MacBook Pro 上,Phonon 语音生成速度比 Gradium 自身实现快 35%,并支持实时语音生成。
 LangChain Deep Agents releases
LangChain Deep Agents 的 deepagents-code==0.2.2 版本发布,包含安全与性能改进。新增 GPT-6.1 Terra 支持、选中文本输入至聊天、插件更新检测等功能;修复项目 .env 文件设置信任值、终端 UI 链接限制、Git 选项限制等 Bug;通过重用父进程上下文、优化服务器启动流程、精简转录渲染等提升性能,推荐尽快升级。
量子位6767讯飞开源的Spark-X2.6大模型采用MoE架构,总参数量293B,支持1M上下文,API价格打六折,每百万输入tokens 0.9元。实测显示,Spark-X2.6在代码和智能体能力上提升约8个点,国产算力训练效率提升4倍,高频应用场景Token消耗下降约60%。模型支持纯端侧、纯云侧和云+端三种协同模式,在CPU推理下完成机器人公司周度经营复盘,用时6.8分钟交出完整报告,准确率达九成。
 Hacker News · AI 热帖
Cerebras 通过将 Kimi K3(约 3 万亿参数)模型层分配到多个 WSE-3T 芯片,实现了每秒 1000-2000+ 个 token 的推理速度。
IT之家 · AI精选同一件事 · 2 家7171小米技术委创新产品团队孵化的开源 AI 硬件 HachimoDock 在 2026 观猹大会亮相,硬件自制成本约 150 元。该设备集桌宠、语音操控电脑端 Agent、智能家居联动和自定义组件生成于一体,可将语音意图分发给 Codex、WorkBuddy 等 Agent,并联动小米 Miloco 控制家居。软件源码已在 GitHub 公开,同时提供硬件物料清单、结构件模型和装配教程。
推荐理由: 小米公开了这款桌面 AI 硬件的源码、物料清单和装配教程,读者可据此判断低成本自制 AI 硬件的门槛。
36氪 · AI5858千里科技发布集成10 TOPS算力NPU的AI毫米波雷达,首次实现雷达内部目标检测与分类,支持边缘侧、卫星与兼容三种工作模式。该雷达通过在感知链路前端引入数据驱动模型,突破传统架构的规则上限,缩短反应时间并提升安全性。千里科技通过收购融感科技打通软硬一体业务闭环,实现自研算法与硬件的联合优化。
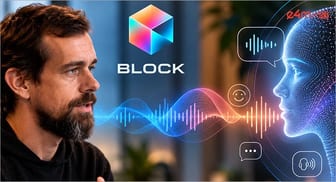
IT之家 · AI6262Block 推出 AI 语音模型 Dessa,完全基于人类语音数据训练,支持本地运行于 M4 Max 及更高配置的 MacBook,可模拟笑声、停顿、哽咽等情绪表达,听感高度拟人。Dessa 属于全双工模型,可一边说话一边收听用户语音,自身知识来源于训练所用的对话数据。现阶段暂不对外开放试用,Block 正向安全研究者发出测试邀请。
IT之家 · AI4040大众安徽旗下与众 09 今日上市,定位“智能美学纯电轿跑”,共推出 3 款车型,双十一惊喜价 16.99 万元起。该车搭载端到端智能辅助驾驶模型,标配图灵 AI 芯片,总算力 750TOPS,提供单电机和双电机四驱纯电动力版本,全系标配宁德时代神行电芯,峰值充电功率超 520 千瓦,充电 5 分钟可补能 250 公里,CLTC 续航里程达到 755km/705km。
 The Decoder精选同一件事 · 2 家7474
AI 初创公司 Recursive 发布首个语言模型 Flint,开发过程中名为 Eureka Machine 的 AI 系统参与提出想法、搭建、测试并规划后续实验。
推荐理由: Recursive 首次公开由自动化研究系统参与开发的模型,读者可据此观察 AI 辅助研发能走到哪一步。
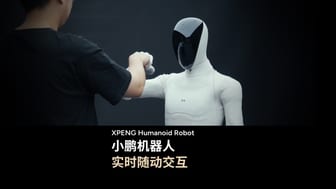
IT之家 · AI7575小鹏 IRON 人形机器人每 0.2 秒重新推理一次,可预测 6 秒内动作变化。它与人互动时能灵活应对临时“变招”,如握手、碰拳、击掌,并调整回应。机器人搭载物理世界大模型,拥有 3 颗图灵 AI 芯片,构建 VLT+VLA+VLM 高阶大小脑能力组合。
IT之家 · AI5050一汽-大众捷达 M6 今日上市,提供 465 Pro(7.98 万元)、555 Max(8.98 万元)、555 Ultra(9.98 万元)三种配置,搭载地平线征程 6M 芯片支持城区/高速 NOA、跨层记忆泊车,OTA 后支持车位到车位全链路领航;内置千问+DeepSeek+豆包三大模型,配备 113kW/145kW 驱动电机,续航 465km/555km。
AWS Machine Learning Blog5252AWS 推出在 AWS Trainium 上用 torchtitan 训练 Qwen3 的三种方法,包括使用 Transformers v5、torchtitan 原生配置以及 Neuron Kernel Interface (NKI) mixture-of-experts (MoE) 内核。
 TechCrunch · AI同一件事 · 2 家7171
Recursive 发布首个模型 Flint,一款可在笔记本电脑上运行的免费编码模型,其开发过程几乎完全由 AI 驱动。Recursive 的自动化研究系统 Eureka Machine 参与了 Flint 的几乎所有开发步骤,使团队在不到四个月内完成模型构建。
Hugging Face BlogHugging Face 介绍了如何使用 TorchNeuron 在 AWS Trainium 上进行系统级推理性能分析,通过 torch.profiler 配置 Neuron 后端捕获干净 traces,并利用 key_averages() 表识别耗时操作。
 Google Developers Blog
Google发布原生PyTorch后端的vLLM和SGLang推理引擎,支持TPU并优化生产级服务;vLLM-TorchTPU在SemiAnalysis InferenceX基准测试中实现175B参数模型每百万token成本2.01美分,行业领先。
Google Developers BlogCoral NPU 发布了完整的 32 位架构,包含新的矩阵执行单元,支持高达 1 TOPS 性能和 10mW 平均功耗;推出基于 IREE/MLIR 的 Coral Compiler v1.0。