OpenHands Blog
什么是 AI 智能体可观察性?如何在大规模下追踪、治理和控制智能体
AI 智能体可观察性是收集追踪、日志、指标、结果和归因数据,帮助团队理解并治理智能体运行期间发生的情况。其核心是记录智能体接收的指令、可观察步骤、使用的工具、产生的结果、验证结果和成本,具有运行范围、行为性、可归因三大特征。OpenHands 可将相关信号整合到智能体运行中,但仅靠可观察性无法解决成本、价值或风险控制问题。
OpenHands BlogAI 智能体可观察性是收集追踪、日志、指标、结果和归因数据,帮助团队理解并治理智能体运行期间发生的情况。其核心是记录智能体接收的指令、可观察步骤、使用的工具、产生的结果、验证结果和成本,具有运行范围、行为性、可归因三大特征。OpenHands 可将相关信号整合到智能体运行中,但仅靠可观察性无法解决成本、价值或风险控制问题。
 Import AI7575
研究显示 AI 加速了网络漏洞发现,但对数学研究影响较小,且 AI 研究本身未见明显加速。SPADE 项目通过自博弈在合成环境中生成训练数据,使用 Qwen3-30B 模型效果最佳,在游戏和工具环境任务上均显著提升性能。Hawkeye 工具用于优化 GPU 内核构建。
 Liquid AI Blog
Liquid AI 与 Artificial Analysis 联合发布 Pipette,一个开源平台,用于在边缘设备上基准测试基础模型。
Liquid AI BlogDSpark 推出 LFM2.5-1.2B-Instruct、LFM2.5-2.6B 和 LFM2.5-8B-A1B 三款推测解码模型,通过增加少量内存开销实现高达 GPU 3.18 倍、设备端 2.87 倍的推理加速,输出质量不变。
Liquid AI BlogLiquid AI 通过实验验证编码智能体能否自主解决生产级问题,开源了 tokenizer 训练工具 toktoktok。该工具需处理单机 trillions tokens,实验选用 Claude Opus 4.5 和 Codex with GPT-5.2 作为智能体,在 30 分钟内完成 toy trainer 开发并通过单元测试,但无法处理完整生产数据集。
 Prime Intellect Blog
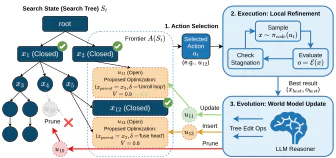
Prime Flash MoE 是一组专为 Blackwell 优化的 CUDA 内核,通过避免某些中间张量的显式创建以及在融合配置中避免激活张量的显式创建,从而显著减少内存流量。
Liquid AI Blog精选7171Liquid AI 发布 LFM2.5-VL-3B,这是在其前代 LFM2-VL-3B 基础上升级的 3.1B 端侧视觉语言模型,已在 Hugging Face 和 Playground 上线。
推荐理由: 原文给出 28 项基准、端侧与 GPU 吞吐数据,可对照同尺寸竞品判断这颗 3B 视觉模型的实际位置。
Prime Intellect BlogPrime Intellect RL现在支持编程任意智能体间交互,可选择学习角色并跨完整交互分配信用,通过verifiers v1和prime-rl算法层实现,可表达Agentic Judging、Self-Play、User-Sim等场景。
 MiniMax News
MiniMax 发布 H3 模型,支持文本、图像、视频和音频的统一上下文理解,能生成带原生立体声的 2K 分辨率视频(最长 15 秒)。
 Berkeley AI Research
K-Search 通过 CUDA-to-MLX 结构化转换层,将 CUDA 核心知识迁移至 Apple Silicon MLX 平台,在 Attention 核心上实现与原生 MLX 0.97x 性能提升,Mamba SSM 核心上较社区实现 20x 预填速度提升。
 MiniMax · Hugging Face 新模型
MiniMax-H3 是一个通用多模态生成系统,支持统一理解文本、图像、视频和音频,能生成最高 2K 分辨率、最长 15 秒的带立体声音频的视频。其 H3-Context-IR 模块用于深度理解输入指令并转化为 H3-Base 可理解的中间表示,但未开源。H3-Base 和 H3-Regenerate-2K 模块分别负责 768p 和 2K 分辨率的音频视频生成,前者开源,后者需 API 调用。
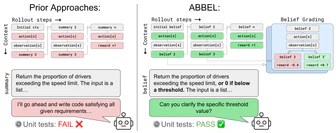
Berkeley AI ResearchABBEL框架通过自然语言信念状态替代完整交互历史作为智能体的工作上下文,并利用信念评分机制监督每个信念状态的内容,在协作代码生成任务上使模型性能接近完整上下文模型,同时将峰值上下文token长度减少约75%,训练步骤减少50%。
Liquid AI BlogLFM2.5-8B-A1B将模型Tokenizer的词汇量从65K扩展至128K,使印地语、越南语和泰语文本token数分别减少2.4倍、2.6倍和4.0倍,设备端解码速度提升2.2倍至3.7倍。该扩展方法通过延续原BPE合并规则并分阶段微调模型,无需重新训练。扩展后的128K tokenizer已在Hugging Face发布,模型本身也同步开源。
 Dify Blog6565
Dify Cloud 通过统一监控和日志功能帮助 IT 团队追踪 token 使用、消息量和活跃用户,识别并优化低效流程;其模型无关特性允许在单个工作流中为不同节点配置 OpenAI、Anthropic、Google 和开源模型,按任务匹配模型以降低成本。
Dify BlogQubrid AI 通过单一插件为 Dify 构建者提供对 DeepSeek、Kimi、Qwen、MiniMax、GLM 等领先开源和前沿模型的统一 API 访问
 Anthropic Research
Anthropic 研究如何通过轴模型分析 Claude 大语言模型在不同语言中的价值观变化。Four key axes capture 15% of the variation in Claude's values。
 Cognition Blog
SWE-1.7 是 Cognition 训练的最强模型,以更低成本达到前沿智能水平。它通过改进 RL 管道(更好基础设施、更稳定训练、高质量数据、长时任务新技巧)实现突破,挑战“微调天花板”假设。在 Devin 平台(Web/桌面/CLI)通过 Cerebras 提供,支持 1000 TPS,编码基准测试中 FrontierCode 1 评分达 42.3%。
 Meta AI Blog
Muse Spark 1.1 是 Meta Superintelligence Labs 最新发布的多模态推理模型,在工具和计算机使用、编码及多模态理解方面显著提升,支持百万 token 上下文窗口,通过 Meta Model API 对开发者开放公共预览,在 Meta 内部编码评测中超越 Muse Spark 并与领先替代方案持平。
Prime Intellect BlogPrime Intellect 宣布获得 1300 万美元 A 轮融资,由 Radical Ventures 领投,NVIDIA Ventures 等参与,总融资额超 1500 万美元用于构建开放超级智能栈。
Cognition BlogDevin Fusion 在新编码基准 FrontierCode 上以 60% 更低成本保持前沿和 Fable 5 级性能,主要通过运行前沿模型与成本效益型“助手”模型并行的双代理架构实现。该架构通过动态中会话路由和深度调优的交互模式,避免基准测试过拟合并提升任务通用性,在实施导向会话中效率提升最显著。用户可通过 app.devin.ai/signup 试用预览版。
Meta AI BlogMeta AI 发布 Brain2Qwerty v2,非侵入式脑机接口实时解码句子,词准确率达 61%;v1 训练代码及数据集开源,v1 数据集由合作方 BCBL 发布。
 OpenAI Alignment Blog
OpenAI 通过在真实场景中强化学习有益特质,使模型在数十个基准测试中表现出更佳的协同与有益行为,且效果泛化至训练域之外并能在对抗压力下持续。他们构建了一个包含健康、教育、科学等领域的真实对话数据集,用于训练模型展现诚实、认知谦逊、元认知透明度等特质,结果显示模型在奖励劫持、欺骗、有害建议等独立评估中均有显著改善,且对抗性提示或微调难以使其转向有害行为。
 Moonshot AI · Hugging Face 新模型
Kimi K3 是 Moonshot AI 发布的 2.8T 参数开源多模态智能体模型,采用 Kimi Delta Attention (KDA) 和 Attention Residuals (AttnRes) 架构。
Moonshot AI · Hugging Face 新模型Kimi K2.7 Code 是 Moonshot AI 基于 Kimi K2.6 构建的编码专注型智能体,在真实长时程编码任务上改进显著,相比 Kimi K2.6 思考 token 使用减少约 30%。
Prime Intellect BlogTrue Agents Model the World 预训练方法使 LLM 能以高精度模拟环境。在 forth-lang 环境中,RLHF 结合 SFT 的方法使模型工具调用更智能,alpha=0.05 时 lookup_doc 使用率显著提升但早期即下降,alpha=1.0 时奖励提升更稳定。
MiniMax · Hugging Face 新模型MiniMax-M3-MXFP8 是一款拥有 1M 上下文窗口、约 428B 参数和 23B 激活参数的原生多模态模型,通过 MiniMax 稀疏注意力机制(MSA)实现 9 倍预填充和 15 倍解码速度提升。该模型在长时程智能体基准中表现领先,支持三种推理模式,可通过 Hugging Face 下载并使用 SGLang、vLLM 或 Transformers 框架进行部署。
Prime Intellect Blog系统性奖励攻击与 Prime Sprints 通过在带有隐藏关键词奖励的 backdoor-ifeval 环境中研究奖励攻击,发现攻击是动态问题,基准频率可预测攻击出现,但无安全稀有度阈值,零基线频率的攻击被放大,罕见攻击较慢,任务难度适中的环境最稳健。Prime Sprints 提供免费信用额度供用户进行奖励攻击实验,环境已开源。
 ByteDance Seed · Hugging Face 新模型2828
ByteDance Seed/SimArt 模型预训练权重发布,包含用于生成关节式 3D 对象结构(URDF 文件)的多模态大语言模型(MLLM)权重,以及用于编码解码 3D 零件几何形状到离散潜在空间的稀疏 VQ-VAE 模型权重。
Prime Intellect BlogGeneral Agent 环境开源,这是一个能随时间自我进化的合成智能体环境,包含 4,504 个跨 1,040 个领域的任务和 8,000 多个工具。合成器与求解器通过 2 人游戏机制生成和验证任务,任务难度分 4 个等级,通过求解器验证后逐步增加难度。
Prime Intellect BlogOpenAI Harmony 模板和 Thinking Machines Tinker cookbooks 推广的 renderer 抽象,将模型聊天模板转化为可编程 Python 对象。
 Thinking Machines
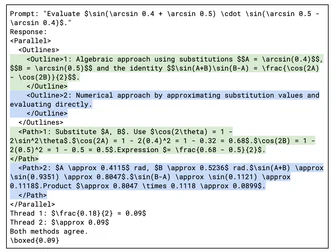
 发布交互式 AI 模型研究预览,原生支持音频、视频、文本多模态实时交互,采用多流微步设计确保 3.5 倍速度提升,实现无缝对话管理、同步语音、时间感知等能力,突破传统回合制接口瓶颈。
Berkeley AI Research适应并行推理让模型根据问题自行决定何时分解和并行化独立子任务、同时启动多少线程以及如何协调。现有方法如固定并行、启发式结构化搜索和蒙特卡洛树搜索等,均在模型外部决定并行结构。最新进展如 ParaThinker 和 GroupThink 等尝试让模型自适应选择并行策略,但决策仍受外部限制。
Anthropic ResearchAnthropic分析了100万个claude.ai对话,发现约6%的用户向Claude寻求个人指导,主要涉及健康与保健(27%)、职业与事业(26%)、人际关系(12%)和个人财务(11%)
Berkeley AI ResearchGRASP 是一种新的基于梯度的世界模型规划器,通过将轨迹提升到虚拟状态实现时间上的并行优化,通过向状态迭代中直接添加随机性进行探索,并通过重塑梯度使动作获得清晰信号,同时避免通过高维视觉模型产生脆弱的“状态-输入”梯度,使长时程规划成为可能。
Prime Intellect Blog6565Prime Intellect 将 FrontierSWE 推上 Environments Hub,这是一个由 Proximal 开发的超长时序开放式编码基准,包含优化编译器或训练蛋白质预测 SOTA 模型等挑战,平均任务耗时 11 小时且几乎无解。
Moonshot AI · Hugging Face 新模型Kimi K2.6 是一个开源多模态智能体模型,在长时程编码、编码驱动设计、主动自主执行和群组任务编排方面取得显著进步。它拥有 1 万亿参数,上下文长度达 256k tokens,在 HLE-Full 基准测试中达到 54.0 分,在 BrowseComp(智能体群组)基准测试中达到 86.3 分,并支持 300 个子智能体并行执行 4,000 个协调步骤。
 LangChain Blog
开源大语言模型 GLM-5 和 MiniMax M2.7 在文件操作、工具使用和指令遵循等核心智能体任务上,与闭源前沿模型(如 Claude Opus 4.6、GPT-5.4)表现相似,工具调用可靠且指令遵循一致。
Berkeley AI ResearchSPEX 算法通过信号处理和编码理论识别 LLM 关键交互,仅需少量扰动即可分析特征、数据和模型组件影响,在情感分析任务上实现数千特征场景下的高保真度;ProxySPEX 算法利用模型层级结构特性,将扰动次数减少 10 倍同时保持性能。
Andrej Karpathy 发布了一个名为 microgpt 的艺术项目,这是一个仅包含 200 行纯 Python 代码的单文件,无需依赖即可训练和推理 GPT 模型。该项目实现了从数据集处理、分词器、自动微分引擎到 GPT-2 风格神经网络架构、Adam 优化器、训练和推理循环的全部算法内容。代码可在 GitHub gist 和 karpathy.art 获取,并已发布为三联画。
Prime Intellect BlogPrime Intellect Lab 发布,提供端到端模型训练平台,整合 Environments Hub、托管训练与托管评估,支持大规模智能体强化学习、推理和评估,无需管理 GPU 集群或算法细节。平台基于环境构建,包含任务数据集和执行器,已通过私有测试完成超 3000 次强化学习运行。