Ollama releases6565
NVIDIA Nemotron 3.5 Bolt E4B 发布
NVIDIA Nemotron 3.5 Bolt E4B 是基于 Gemma 4 的视觉语言模型,支持 128K token 上下文窗口,包含 DFlash 推测解码,可通过 ollama run nemotron-3.5-bolt:e4b 使用。
Ollama releases6565NVIDIA Nemotron 3.5 Bolt E4B 是基于 Gemma 4 的视觉语言模型,支持 128K token 上下文窗口,包含 DFlash 推测解码,可通过 ollama run nemotron-3.5-bolt:e4b 使用。
 The Decoder同一件事 · 2 家
Canva 发布了其首款自研图像生成模型 Canva Craft,称其性能可与来自 Google、OpenAI、字节跳动和 Meta 的同类模型竞争。Canva Research 团队从零开始训练该模型,主要依赖数百万个设计模板而非照片,支持 55 种语言的文本渲染,可在 30 多种宽高比下生成高达 2K 分辨率的图像,并通过 Magic Layers 实现结果的可编辑分层。
各家口径不同:TechCrunch 表示模型支持 30 种宽高比;The Verge 提及“超过 30”种宽高比;The Decoder 指定 30 多种宽高比。
 IT之家 · AI同一件事 · 2 家
月之暗面发布 Kimi K3.1 预热视频,画面显示“Model:Kimi K3.1”,支持 1M tokens 上下文窗口,新增 medium 推理强度档位。K3.1 已在 Hugging Face 可识别,但官方未公布正式发布日期、参数规模或定价。
 腾讯混元 · Hugging Face 新模型
腾讯混元发布 WeVisOne-VL-2B 模型,基于 Qwen3-VL 构建,集成 9.5M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
腾讯混元 · Hugging Face 新模型腾讯混元发布 WeVisOne-VL-4B 模型,基于 Qwen3-VL 构建,集成 9.6M 参数像素解码器,支持目标级感知(开放词汇目标检测、指向定位、计数、指向和 OCR)与像素级感知(指向分割和可提示 alpha 摩擦),适用于视觉定位、指向、计数、OCR 定位、指向分割和图像摩擦等研究任务。
 36氪 · AI同一件事 · 2 家6565
千问蒋冠军在2026中国计算机大会上分享Personal Agent技术实践,认为模型、记忆与生态是构建核心能力的三要素,通过高效协同为不同问题找到最优解决路径。
 Hugging Face Daily Papers6565
Meta Expert 模型通过跨层共享元专家减少冗余,相比层内局部专家的 MoE 模型参数冗余更低、交叉熵损失更低且下游任务准确率更高。在激活量和专家粒度固定时,该模型仅用 70-80% 的专家即可达到与 Vanilla MoE 相当的性能,显著提升模型扩展潜力。理论分析显示,元专家提供更灵活的残差通路,从而提高信息检索效率。
36氪 · AI同一件事 · 2 家6565Kimi 即将发布最新大模型 K3.1,并发布相关预热视频,引发 AI 开发者关注和讨论。
Hugging Face Daily PapersDeep Fusion Memory (DFM) 通过门控交叉注意力将预测的参数化记忆集成到中间隐藏状态,减少检索开销,在无需在线检索的情况下提升知识密集型任务表现。
IT之家 · AI3535PCB 制造商 TLB 已就 SOCAMM3 内存模组的设计和制造方案与两家内存制造商客户进行早期磋商,但最终规格尚未确定。SOCAMM3 的量产预计将从 2028 年开始,可能随 NVIDIA 的 Rosa CPU 一道进入市场。
 vLLM Blog5858
vLLM 在 NVIDIA Blackwell、Rubin 和 AMD MI350 系列显卡上为 MiniMax-M3.1-Flash 提供零日支持,在智能体工作负载上表现优异。
IT之家 · AIMiniMax 开源 M3.1 Flash 模型权重,总参数 428B、激活参数 23B。通过稀疏注意力、量化感知训练和 Power-aware scheduling 优化,推理效率提升,上线 72 小时处理超 100 万亿 Token。
Hugging Face Daily Papers6565Cola2 通过动态跨度分割、掩码扩散解码和流匹配先验联合优化持续语义压缩、重建-生成平衡和编码器-解码器自适应,在五个下游任务上验证了其核心设计,使用 2100 亿训练 token 显示出有竞争力的非饱和扩展性,3460 亿源 token 的未收敛检查点在八个任务上平均达到 60.10 分,并在 HellaSwag 和 StoryCloze 上超越 Llama-3-8B。
 The Verge · AI同一件事 · 2 家7575
Canva 发布首款 AI 图像模型 Canva Craft,在生成前规划设计;该模型采用两阶段架构,支持 2K 分辨率、30 余种宽高比,可用于社交媒体和营销内容创作,现已在全球上线。
各家口径不同:TechCrunch 表示模型支持 30 种宽高比;The Verge 提及“超过 30”种宽高比;The Decoder 指定 30 多种宽高比。
 TechCrunch · AI7070
OpenAI 首次将决策模型 Decisions API 广泛开放给用户,该模型将 ChatGPT Luna 重构以实现更快推理和更低成本,速度从秒级缩短至毫秒级。
TechCrunch · AI微软 AI 诊断系统 MAI-DxO 在模拟中诊断复杂病例准确率达 83%,超过单独工作的全科医生(36%),其通过协调多个 AI 智能体模拟医生团队运作。
 AWS Machine Learning Blog
SageMaker AI 推出无 GPU 管理的模型定制功能,用户可通过训练会话控制后训练逻辑,无需管理底层基础设施。支持 SFT、DPO、RLVR、RLAIF、多轮 RL 等技术,并可选择 LoRA 或全量微调。
 Hacker News · AI 热帖
在询问13个AI模型对人类的“争议性”看法时,32个回答相同。GPT-6.1 Sol、Grok 4.7、DeepSeek V4 Pro、Kimi K3。
The Decoder精选7474AI 初创公司 Recursive 发布首个语言模型 Flint,开发过程中名为 Eureka Machine 的 AI 系统参与提出想法、搭建、测试并规划后续实验。
推荐理由: Recursive 首次公开由自动化研究系统参与开发的模型,读者可据此观察 AI 辅助研发能走到哪一步。
Hugging Face Daily Papers7070Spectral-Spatial Interpretation (SSI) 发布,使用符号归因解释模型分数,为每个空间单元和频谱通道分配贡献度。SSI 在三个数据集和两种掩码基线下的三个指标平均表现最佳,例如 HLS 联合删除的均值基线得分 0.1545 高于 KernelSHAP 的 0.2096。SSI 在空间定位、频谱 Hit@K 和通道删除方面领先于比较方法。
 O'Reilly Radar7575
Anthropic 官方宣布未来 Claude 模型将包含 AI 文本水印以符合欧盟 AI 法案,Claude Mythos 5.1、Claude Fable 5.1。
 机器之心5858
无界动力发布并开源 MWA™-Phoenix 隐空间世界模型基座,横扫 LIBERO-Plus、LIBERO-Pro、RoboCasa GR1、Bench2Dex、RoboTwin 2.0 和 RoboDojo 真机榜。
 量子位同一件事 · 2 家5858
蚂蚁数科发布决策模型 LingDT-Decision-1.0,准确率超微软等竞品。该模型提供 4B 和 27B 两个版本,在客服、风控等场景测试显示,Token 消耗降低超 90%,响应时效提升 10 倍,性能优于大语言模型。
IT之家 · AI同一件事 · 2 家蚂蚁数科发布决策模型 LingDT-Decision-1.0,在 23 项开源评测基准中性能超过 Microsoft-Decision-1、Jev 1.13.等模型,其 27B 版本取得最高准确率,在真实业务场景中将 Token 消耗降低超 90%,响应时效提升 10 倍。
 MarkTechPost
Mistral AI 发布了 Voxtral 3 语音模型家族及基于 LiveKit 的语音智能体 SDK,包含 3 个转录模型、1 个文本转语音模型。
 Hugging Face Blog
Hugging Face发布IBM Granite时间序列模型集成预测方案,结合四款Granite模型(PatchTST-FM-r1、PatchTST-FM-r2、FlowState-r1.1、TTM-r3)提供无微调的集成预测。
腾讯混元 · Hugging Face 新模型精选7272腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并具备实时声音克隆能力。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数超过所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比数据,并开放 GGUF 权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布 Hy-SimulMT 实时同声传译模型,支持中英双向语音到语音翻译,并可在说话过程中持续输出译文文本与语音,同时通过实时声音克隆保留说话人音色。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署脚本,可据此评估落地方式。
腾讯混元 · Hugging Face 新模型精选7373腾讯混元发布并开源 Hy-SimulMT-30B-A3B 系列实时同传模型,支持中英双向语音到语音翻译和实时声音克隆,同时输出译文文本与语音。在 RealSI 长音频评测中 StreamLAAL 约 3 秒,为对比系统中最低,GEMBA 分数超过所比开源模型和 5 个商业 API 中的 4 个。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放模型权重和推理部署工具,可据此判断落地条件。
腾讯混元 · Hugging Face 新模型精选7474腾讯混元发布 Hy-SimulMT-30B-A3B 实时同声传译模型,支持中英双向语音到语音翻译并实时克隆说话人音色,已在 Hugging Face 开源多个版本。
推荐理由: 官方给出与开源模型、商业 API 及专业同传译员的对比数据,可据此判断实时同传的质量与延迟取舍。
腾讯混元 · Hugging Face 新模型精选7272腾讯混元发布并开源实时同声传译模型 Hy-SimulMT-30B-A3B,支持中英双向语音到语音翻译,可在说话过程中持续输出译文文本与语音,并支持实时声音克隆。
推荐理由: 官方给出实时同传的延迟与质量对比,并开放多个量化版本和推理部署脚本,可据此评估落地成本。
腾讯混元 · Hugging Face 新模型精选7575腾讯混元发布并开源 Hy-SimulMT-30B-A3B,支持中英双向语音到语音实时同声传译,边接收音频边输出译文文本和语音,并支持实时声音克隆。在 RealSI 长音频评测中,其 StreamLAAL 约为 3 秒,为对比系统中最低,GEMBA 分数高于所比较的开源模型和五个商业 API 中的四个。
推荐理由: 原文给出中英双向同传的延迟与质量对比数据,并附开源权重和部署方式,可据此判断实时语音翻译的可用程度。
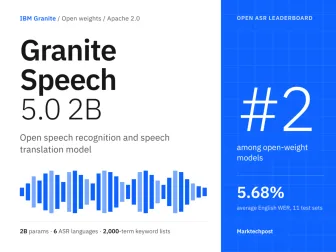
MarkTechPost同一件事 · 2 家7575IBM 发布 Granite Speech 5.0 2B,一个 2B 参数的开源语音语言模型,支持 6 种语言的语音转写与翻译,在 Open ASR 排行榜上排名第二,英语平均 WER 5.68%。模型采用 YaRN 扩展至 16k 位置,支持 GPU、Apple Silicon 和本地 CPU 部署,并包含 2000 项关键词偏置功能。
各家口径不同:Hugging Face Blog指出模型在390,000小时数据上训练;MarkTechPost未提及训练数据时长。
MarkTechPost5555Cactus Whistle语音模型在CPU上以16.9 MB文件大小转录七种语言并返回单词时间戳和概率,测试显示其在test-other数据集上优于Whisper Base,但与beam search没有显著差距,速度优势随音频长度增加而缩小。此外还测试了30秒窗口音频处理、流式延迟、时间戳、关键词偏差、其他语言、噪音、嵌入和语音到工具调用功能。
MarkTechPost使用 Nsight Python(NVIDIA 开源 Python 接口)分析 GPU 内核性能,通过 `nsight.annotate` 标记代码、`nsight.analyze.kernel` 装饰函数,获取每段代码的硬件指标 DataFrame。
MarkTechPostRecursive 发布开源 40B 模糊模型 Flint,2.5B 活跃参数,在 50B 以下 MoE 模型中表现最佳,支持推理和 OpenAI 兼容工具调用,4 位权重约 23GB,SWE-bench Verified 74.2%。
 PyTorch Blog
TorchTitan 新增对 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 等最新 SOTA 模型的原生 PyTorch 支持。
Hugging Face Blog精选7878NVIDIA 发布预训练关系型基础模型 Kumo Relational,可直接在企业数据库上做预测,无需任务特定训练、特征工程或表展平。模型在 15 个数据库的 41 个任务上超过监督式关系深度学习和专家特征工程梯度提升树,在 SAP SALT 基准上 MRR 比 AutoGluon 集成高 8%。
推荐理由: 原文给出预训练关系模型在 41 个任务上的对比结果与开源入口,读者可据此判断它能否替代现有 XGBoost 流水线。
The Decoder7070Google Cloud 今日起开始提供 GPT-6 Astra(用于编码和科研)、GPT-6.1 Sol(性能相似但更便宜)和 GPT-6 Luna(快速且成本高效)三个 OpenAI 模型,成为唯一同时提供 Gemini、Claude 和 OpenAI 模型的云服务商,目前以私享预览形式向企业客户开放注册,费用计入现有 Google Cloud 合同。
 Baseten Blog同一件事 · 2 家5858
Baseten 发布全球顶尖决策模型 mammoth-1(27B)和 elephant-1(9B),分别位列 Jev 决策指数 0.4 第 1 名和 9B 决策模型第 1 名。两者均开源,可在 Baseten 模型 API 上免费试用一周(默认零数据保留)。