跳到正文
实时
11月6日周五
  1. vLLM Blog72

    REINFORCE Zero:对齐 kernel 让异步 RL 在 lag 64 下稳定训练

    NVIDIA Research 与 Inferact 的 REINFORCE Zero 提出先对齐 rollout 与训练 kernel,再用不裁剪的 token 级重要性采样修正权重滞后,在 16 张 GPU、12K 次更新下训练步吞吐为同步训练的 2.40 倍。

    推荐理由: 论文把异步 RL 的 rollout 与训练差距拆成权重滞后和 kernel 不一致两项,并给出对齐后免裁剪重要性采样的做法。

10月25日周日
  1. vLLM Blog60

    vLLM在GB300 NVL72上服务DeepSeek-V4.1-Flash:性能追平DeepInfer并扩展至整机架

    vLLM 团队在 NVIDIA GB300 NVL72 单机架上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash,在 SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍。

    推荐理由: vLLM 团队公开了在 GB300 NVL72 上服务 DeepSeek-V4.1-Flash 的逐项优化与实测数据,可与 DeepSeek 自家引擎 DeepInfer 对照。

10月2日周五
9月10日周四
  1. DeepSeek · Hugging Face 新模型

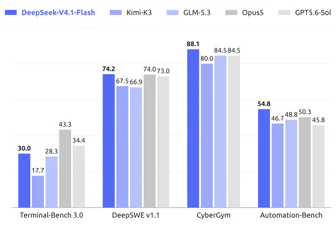
    DeepSeek-V4.1-Flash 发布:552B 参数多模态 MoE 模型,上下文高达百万 token

    DeepSeek-V4.1-Flash 是一个 552B 参数的多模态 MoE 模型,支持高达一百万 token 的上下文,原生处理图像和文本并自回归生成文本。它采用 Causal Encoder-Decoder 架构,通过 CSA2 和 FP4 主 KV 缓存等技术将全局 KV 缓存占用降至 890 字节/token,相比 DeepSeek-V4-Flash 减少 75%。

8月31日周一